Annotazione intelligente ed etichettatura in batch
Scegli un modello di etichettatura e una soglia di confidenza misurando il lavoro di revisione, poi avvia l'annotazione in batch e verificala calcolando il tasso di modifiche.
Disegnare riquadri a mano consente di elaborare forse 100 immagini all'ora; rivedere buone pre-etichette può essere diverse volte più veloce. Ma un modello di etichettatura con una soglia di confidenza sbagliata può creare più lavoro di quanto ne faccia risparmiare, e un modello non sottoposto a revisione insegna al tuo modello successivo i propri errori. In questa lezione misuri il lavoro di revisione a ogni soglia su dati reali già etichettati, così scegli la soglia in base ai numeri, non a una supposizione.
Pratico
Tre modi per pre-etichettare#
Nell'editor di annotazione, la modalità Draw (V) è manuale, mentre la modalità Smart (S) consente a un modello di proporre etichette:
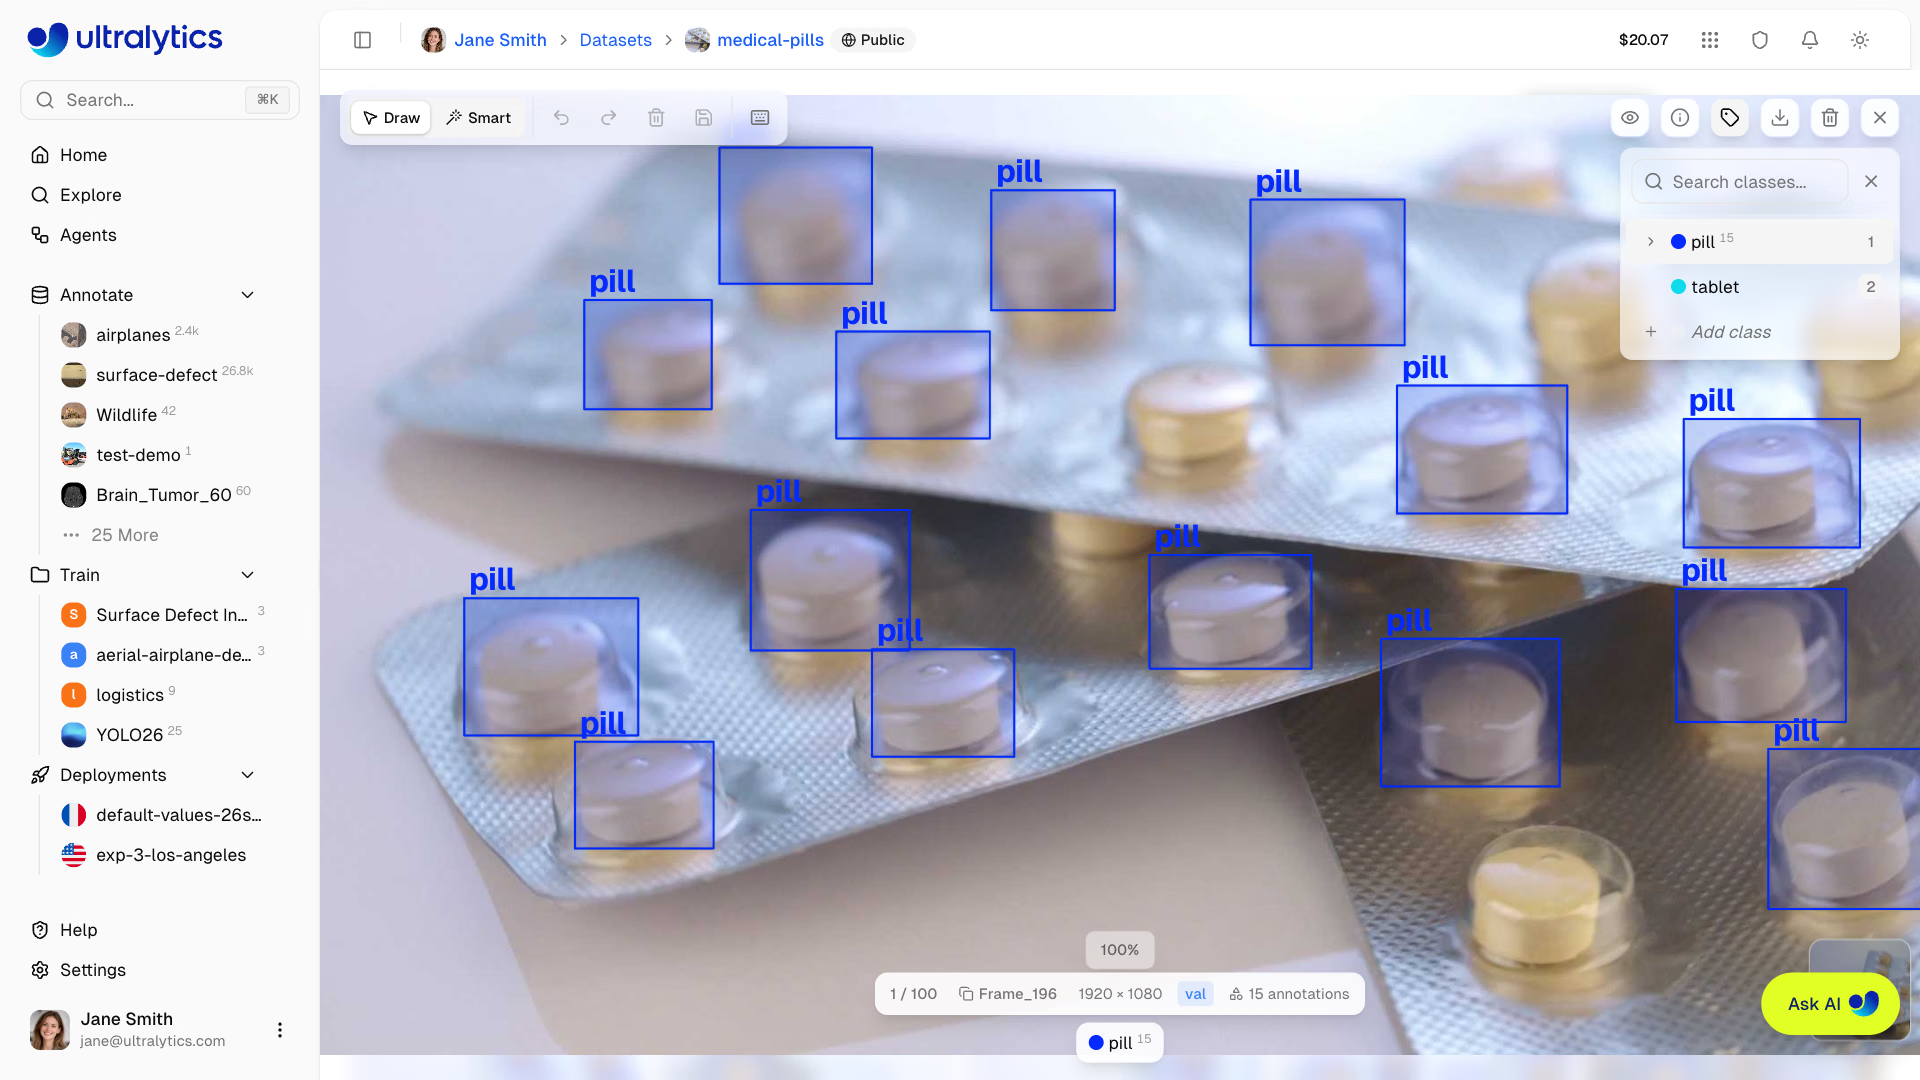
| Famiglia | Come funziona | Attività | Costo |
|---|---|---|---|
| SAM (SAM 2.1 da Tiny a Large, SAM 3, SAM 3.1 predefinito) | Fai clic su un oggetto per creare una maschera; fai clic all'esterno per aggiungerlo, all'interno per sottrarlo; A attiva o disattiva l'applicazione automatica | Rilevamento, segmentazione, semantica, OBB | Free |
| YOLO (modelli ufficiali o personalizzati) | Predict aggiunge i rilevamenti del modello; Map classes allinea le classi del modello a quelle del dataset; i duplicati con IoU pari o superiore a 0.7 vengono ignorati | Rilevamento, segmentazione, semantica, OBB, posa | Gratis nell'editor |
| Con prompt di classe (Moondream 3.1 predefinito, YOLOE-26x, SAM 3 Text e altri) | Individua nell'immagine i nomi delle classi del dataset; i modelli a pagamento dei provider vengono eseguiti usando la tua chiave API | Dataset di rilevamento con 1–200 classi | Modelli ospitati gratuiti |
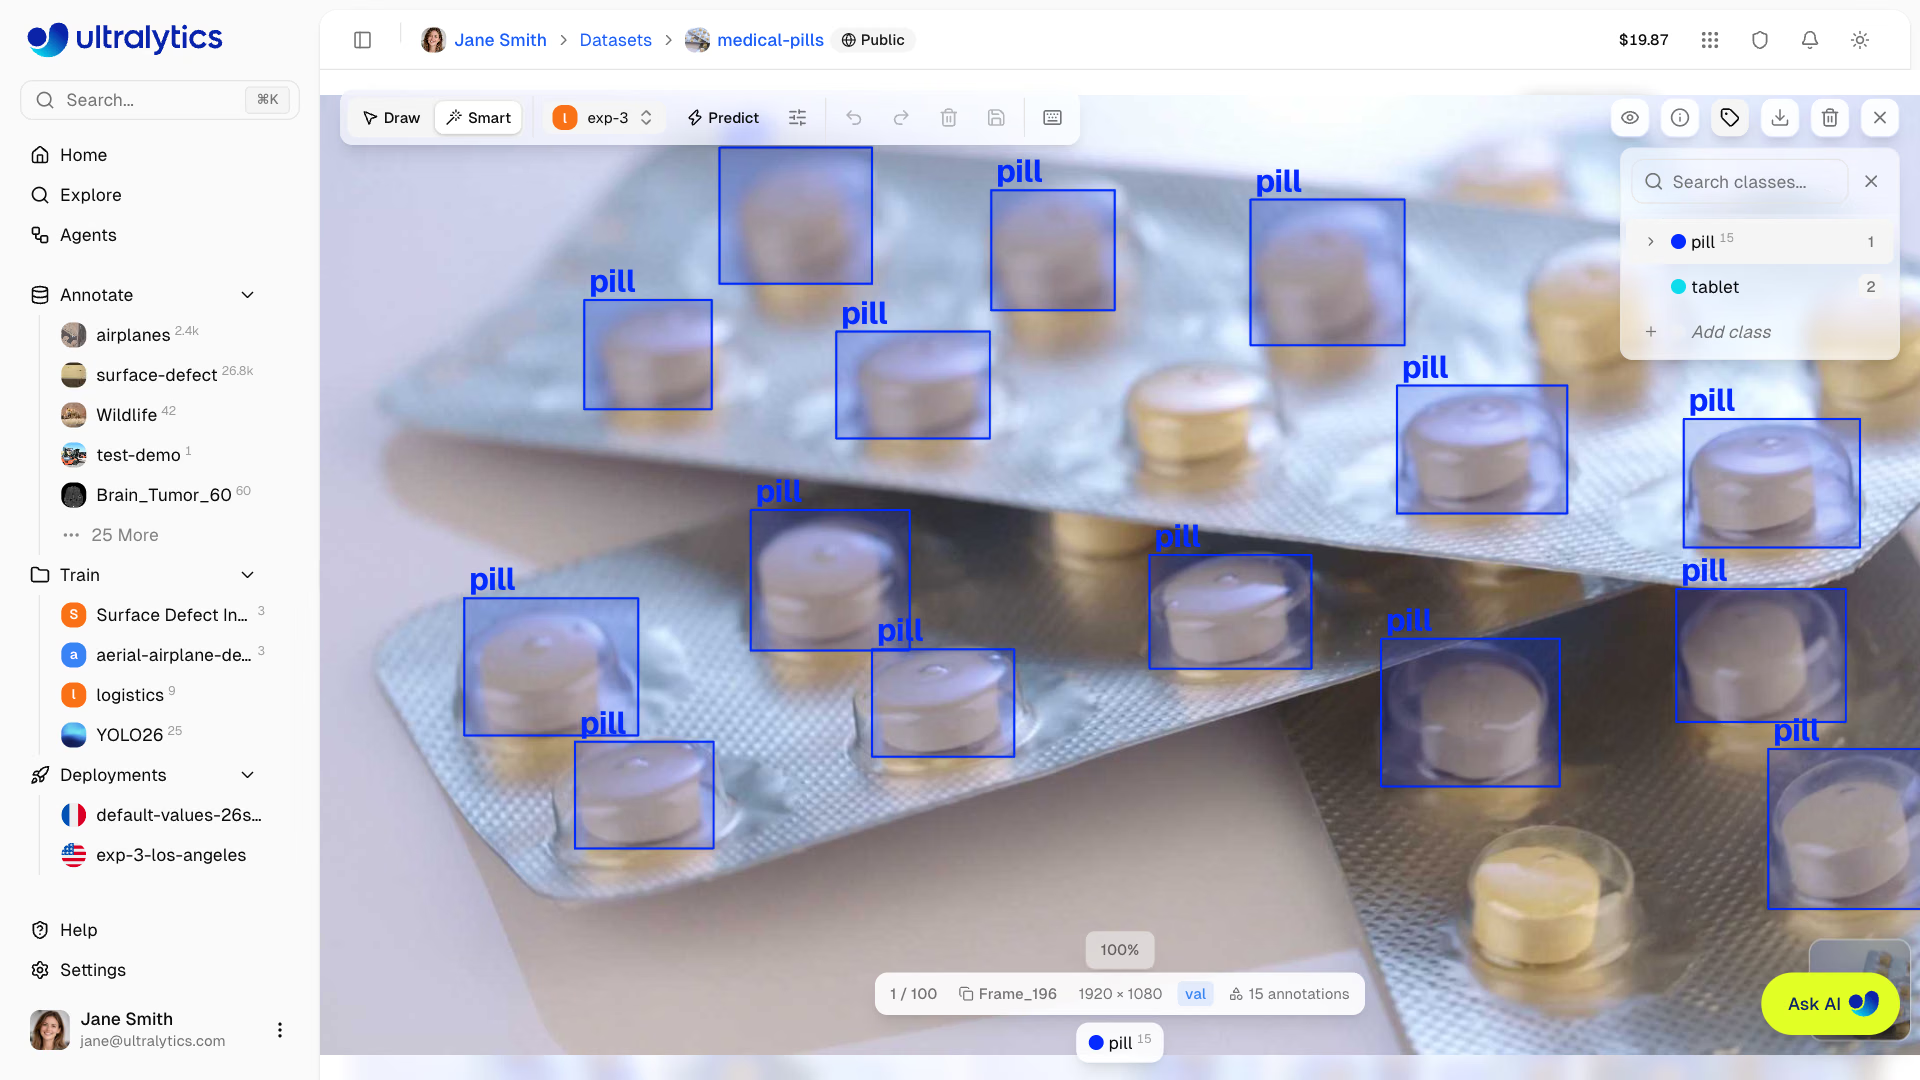
SAM richiede un clic per oggetto e produce forme più precise. Le previsioni del modello richiedono un clic per immagine e sono valide solo quanto il modello, quindi il resto della lezione è dedicato alla scelta e alla messa a punto del modello.
Scegli il modello di etichettatura#
Un modello v0 poco accurato, addestrato su 100–200 etichette manuali, è comunque meglio che disegnare da zero e, a partire da v1, di solito è un utile alleato per l'apprendimento attivo. Le prestazioni dei modelli con prompt di classe variano molto a seconda del dominio: alcuni modelli che trovano quasi tutto nelle foto di tutti i giorni non rilevano la maggior parte degli oggetti nelle immagini di PCB, radiografie o prodotti al dettaglio, quindi controlla dieci previsioni prima di fidarti.
Esempio pratico: misura il lavoro di revisione per soglia#
La soglia di confidenza determina su cosa i revisori impiegano il loro tempo: se è troppo bassa, eliminano riquadri falsi; se è troppo alta, disegnano i riquadri ignorati dal modello. Misurala su immagini già etichettate correttamente, qui le 128 immagini etichettate di COCO128, usando YOLO26n preaddestrato come modello di etichettatura:
from pathlib import Path

import torch

from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset
from ultralytics.utils.metrics import box_iou
from ultralytics.utils.ops import xywhn2xyxy

data = check_det_dataset("coco128.yaml")  # 128 labeled images, downloaded on first use
images = sorted(Path(data["train"]).glob("*.jpg"))
results = YOLO("yolo26n.pt").predict(images, conf=0.05, verbose=False)  # your labeling model

def review_work(result, image, conf):
    """Return (kept, delete, draw): correct pre-labels, false positives to delete, missed objects to draw."""
    label = Path(str(image).replace("images", "labels")).with_suffix(".txt")
    lines = label.read_text().splitlines() if label.exists() else []  # no label file = background image
    gt = torch.tensor([[float(x) for x in line.split()] for line in lines]).reshape(-1, 5)
    h, w = result.orig_shape
    gt_boxes, gt_cls = xywhn2xyxy(gt[:, 1:], w=w, h=h), gt[:, 0]
    boxes = result.boxes[result.boxes.conf >= conf]
    iou = box_iou(boxes.xyxy, gt_boxes) * (boxes.cls[:, None] == gt_cls[None])  # IoU with same-class boxes only
    matched = set()
    for row in iou:  # greedily match each prediction to its best unmatched ground-truth box
        for j in row.argsort(descending=True).tolist():
            if row[j] >= 0.5 and j not in matched:
                matched.add(j)
                break
    return len(matched), len(boxes) - len(matched), len(gt) - len(matched)

print("conf  kept  delete  draw  edits/image")
for conf in (0.1, 0.25, 0.4, 0.5, 0.7):
    kept, delete, draw = (sum(t) for t in zip(*(review_work(r, i, conf) for r, i in zip(results, images))))
    print(f"{conf:<5} {kept:>4} {delete:>7} {draw:>5} {(delete + draw) / len(images):>12.1f}")
conf kept delete draw edits/image
0.1 590 490 339 6.5
0.25 468 138 461 4.7
0.4 386 58 543 4.7
0.5 328 35 601 5.0
0.7 230 6 699 5.5Come funziona e cosa indica:
- Il modello genera previsioni una sola volta con una
conf=0.05bassa; ogni soglia filtra poi le stesse previsioni, quindi la scansione è veloce. review_workabbina ogni previsione a un riquadro di riferimento della stessa classe con IoU pari o superiore a 0.5. Le previsioni non abbinate sono riquadri che il revisore elimina; gli oggetti di riferimento non abbinati sono oggetti che il revisore disegna.- Le modifiche per immagine raggiungono il minimo tra 0.25 e 0.4 (4.7). Al di sotto, le eliminazioni aumentano vertiginosamente; al di sopra, aumentano gli oggetti mancati.
- Anche con la soglia migliore, i revisori disegnano circa 3.6 riquadri per immagine, perché la lunga coda di oggetti piccoli di COCO è difficile da gestire per un modello nano.
Criteri decisionali: scegli la soglia con il minor numero di modifiche per immagine. Se disegnare è l'operazione prevalente a ogni soglia, il modello di etichettatura è troppo debole per i dati: usa un modello più grande o il tuo modello ottimizzato. Se eliminare è l'operazione prevalente anche a 0.5, il modello confonde classi simili, quindi controlla la matrice di confusione prima di etichettare altri dati. Nel tuo progetto, esegui la scansione con il tuo modello ottimizzato su 50–100 immagini che hai già etichettato.
Esegui l'annotazione in batch#
L'annotazione in batch esegue un modello YOLO o con prompt di classe sull'intero dataset. Aprila da More actions > Batch Annotation oppure fai clic su Annotate all nella notifica dopo una previsione nell'editor:
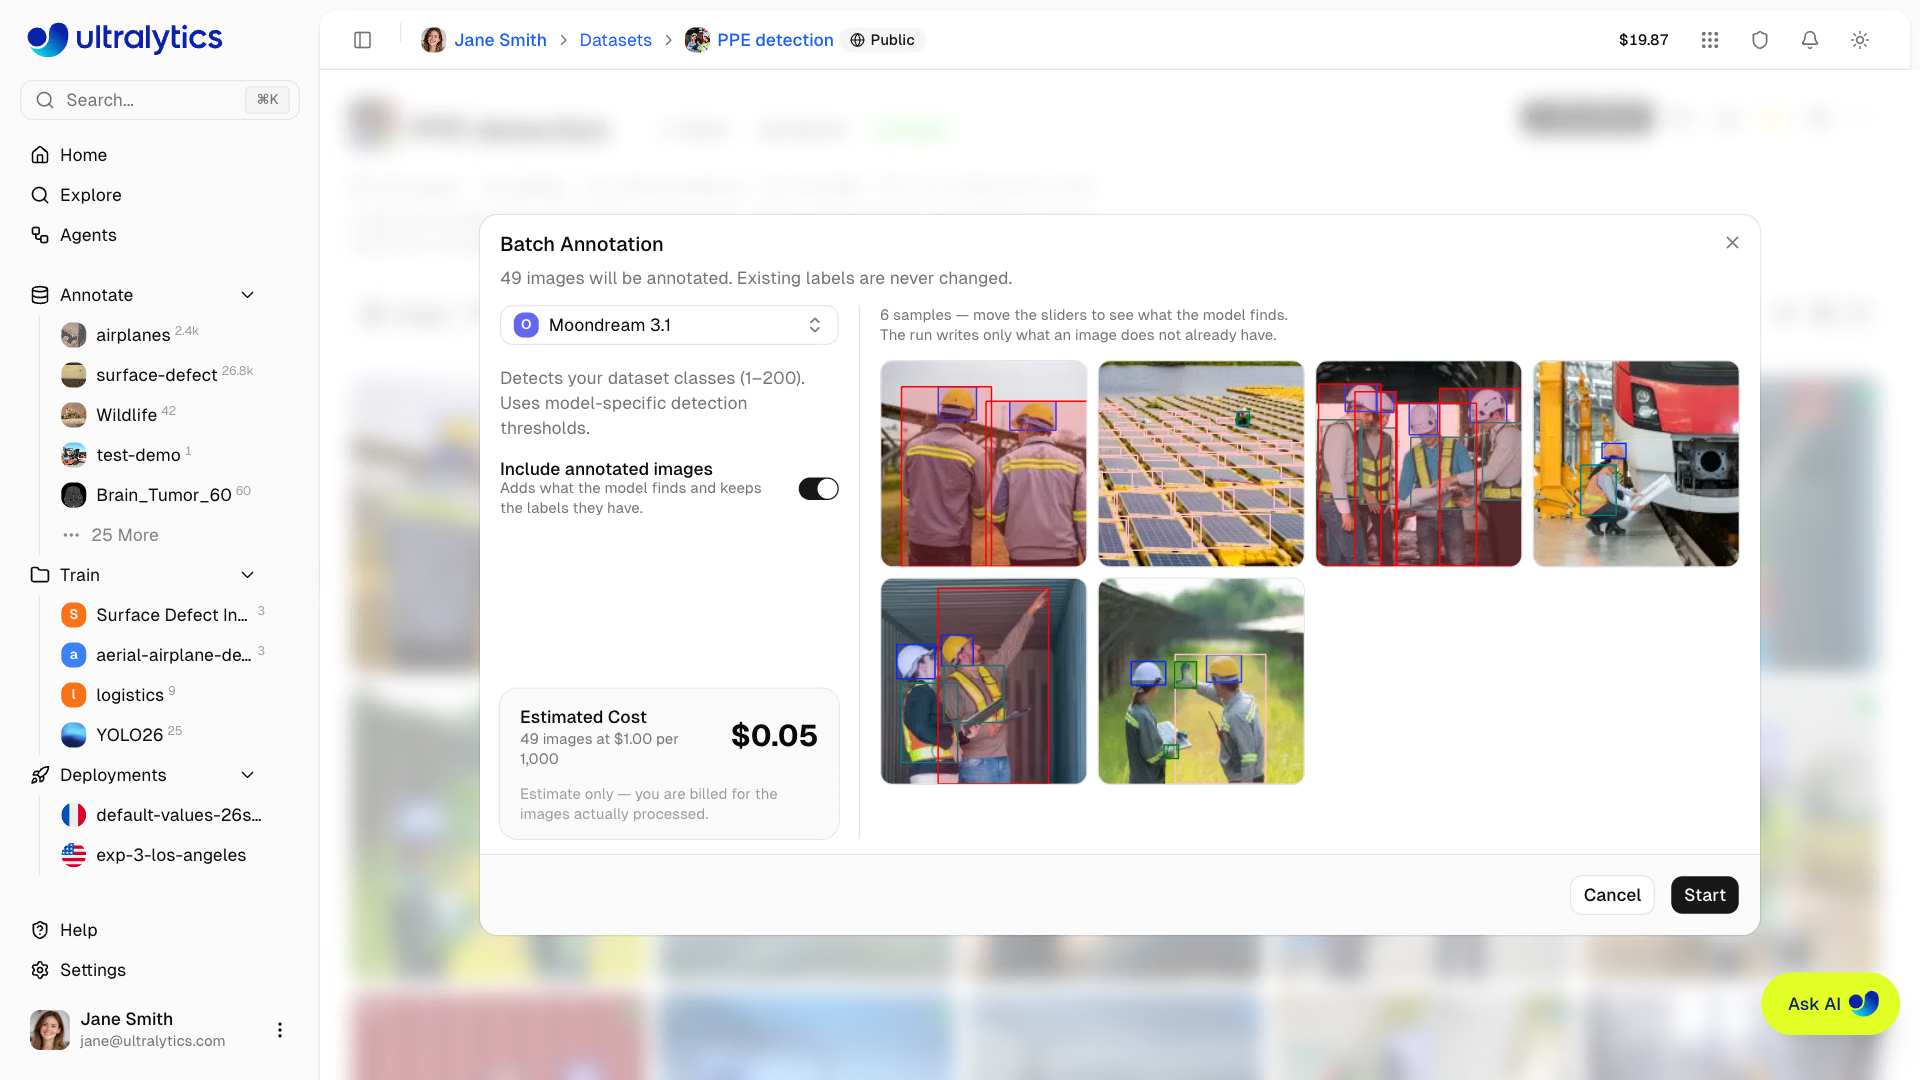
- Scegli il modello. I dataset di rilevamento si aprono con Moondream 3.1 selezionato; passa al tuo modello ottimizzato o al modello YOLO.
- Per un modello YOLO, imposta la confidenza sulla soglia scelta dalla scansione (il valore predefinito è
0.25) e IoU (0.7), quindi controlla le anteprime di esempio. - Lascia disattivata l'opzione Include annotated images per etichettare solo le immagini senza etichette.
- Controlla Estimated Cost ($1.00 ogni 1.000 immagini, minimo $0.01) e fai clic su Start.
L'avvio di un'esecuzione salva prima una versione del dataset, così puoi ripristinare lo stato precedente. Stop conserva e addebita le immagini elaborate fino a quel momento.
Rivedi, poi misura il tasso di modifiche#
Le previsioni diventano normali annotazioni, quindi nulla le contrassegna come non revisionate. Filtra per classe per controllare prima quelle rare e ordina per Annotations in ordine crescente (probabili oggetti mancati) e decrescente (scene affollate in cui i riquadri si fondono). Crea poi una versione, apri Compare versions nella scheda Versions e scegli v_auto come versione From:
| Conteggio | Significato |
|---|---|
| Aggiunti | Oggetti mancati dal modello, più la copia corretta di ogni riquadro modificato |
| Rimossi | Falsi positivi, più l'originale di ogni riquadro modificato |
| Tasso di modifiche | (aggiunti + rimossi) ÷ annotazioni in v_auto, una stima per eccesso perché un riquadro corretto viene conteggiato due volte |
Monitora il tasso di modifiche per ogni batch. Un tasso in aumento è il primo segnale che le nuove immagini si discostano da ciò che il modello di etichettatura conosce. La lezione sulle best practice di annotazione tratta le guide all'etichettatura e l'accordo tra revisori.
Insidie#
Sintomo: a ogni nuovo addestramento il punteggio resta più o meno uguale e mancano sempre gli stessi oggetti. Soluzione: le pre-etichette non revisionate incorporano nel dataset, come verità di riferimento, gli errori sistematici del modello di etichettatura: classi simili tra loro, bordi dei riquadri abitualmente imprecisi e oggetti che il modello non rileva mai. Revisiona ogni immagine prima che venga inclusa in una versione di addestramento.
Sintomo: l'annotazione batch termina, ma la maggior parte degli oggetti è ancora senza etichetta. Soluzione: prova prima il modello nell'editor su dieci immagini rappresentative. Se non rileva più di pochi oggetti, etichetta manualmente un set iniziale e addestra invece un modello v0.
Sintomo: i riquadri predetti riportano nomi di classe errati. Soluzione: quando le classi del modello differiscono da quelle del dataset, il passaggio Mappa classi associa ogni classe del modello a una classe del dataset oppure la ignora. Esegui la mappatura con attenzione: un'associazione errata rietichetta tutti i riquadri di quella classe.
Mostra la soluzione
Esempio pratico: il test sceglie 0.35 per un fine-tuning dell'ispezione di pillole. Batch Annotation salva v4 con 1,240 annotazioni. Dopo la revisione, Compare versions v4 → v5 mostra 96 aggiunte e 152 rimozioni, quindi il tasso di modifica è (96 + 152) ÷ 1,240 = 20%. Il numero di rimozioni superiore a quello delle aggiunte indica sovrapredizione: esaminando le box rimosse, si scopre che il modello contrassegna i riflessi sui blister come pillole. Ne conseguono due azioni: aumentare la confidenza di un livello (0.35 → 0.45) per il batch successivo e verificare che il tasso diminuisca; aggiungere 30 immagini revisionate di confezioni lucide alla versione di training successiva, così il fine-tuning impara a distinguere i casi.