Confrontare le esecuzioni e scegliere la migliore
Confronta le esecuzioni in un progetto Platform, annota il motivo di ciascuna e decidi con uno script di approvazione se distribuire un modello candidato.
I modelli più grandi di solito vincono sulla metrica principale, ma poi perdono su una classe che nessuno ha controllato. Senza una regola decisa in anticipo, viene distribuita l'esecuzione che è piaciuta di più a qualcuno. In questa lezione documenterai ogni esecuzione per poter ritrovare in seguito il ragionamento e trasformerai "è migliore?" in uno script di approvazione che restituisce PASS o FAIL.
Pratico
Confrontare le esecuzioni in un progetto#
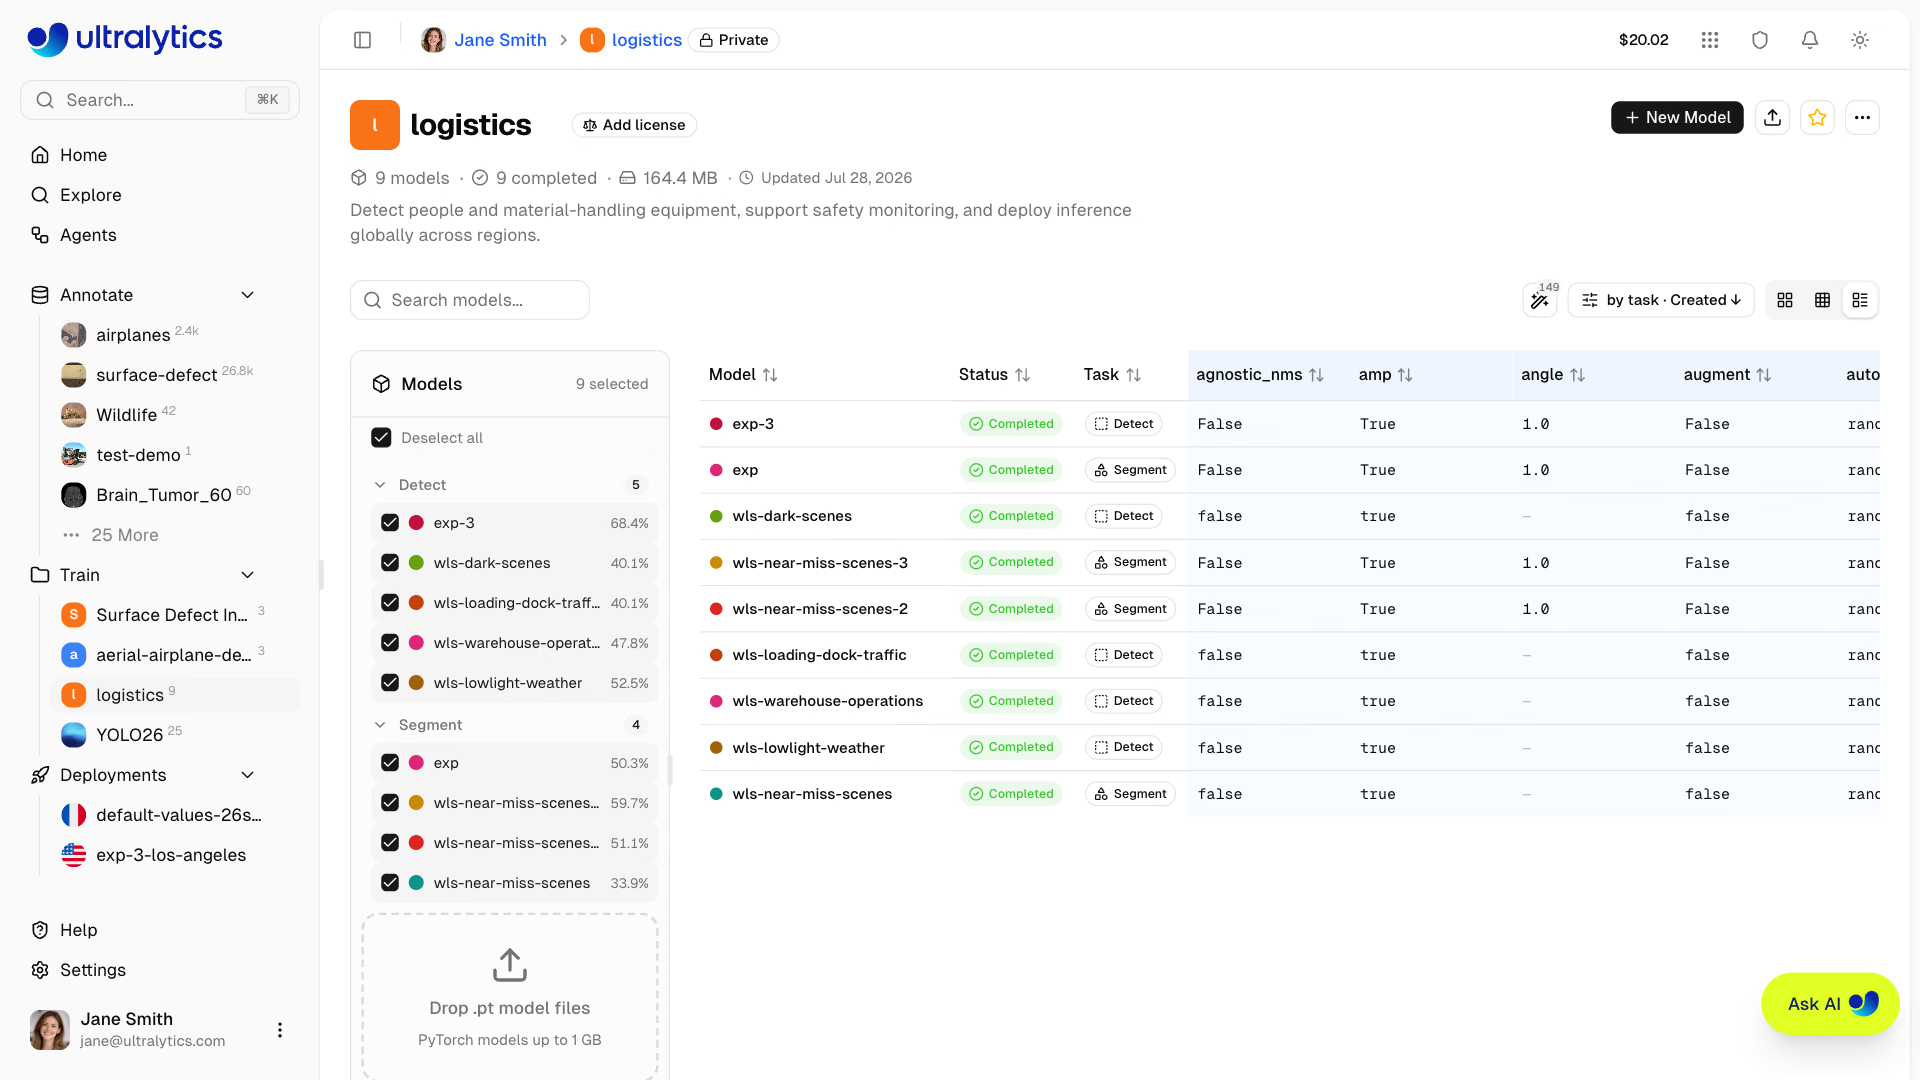
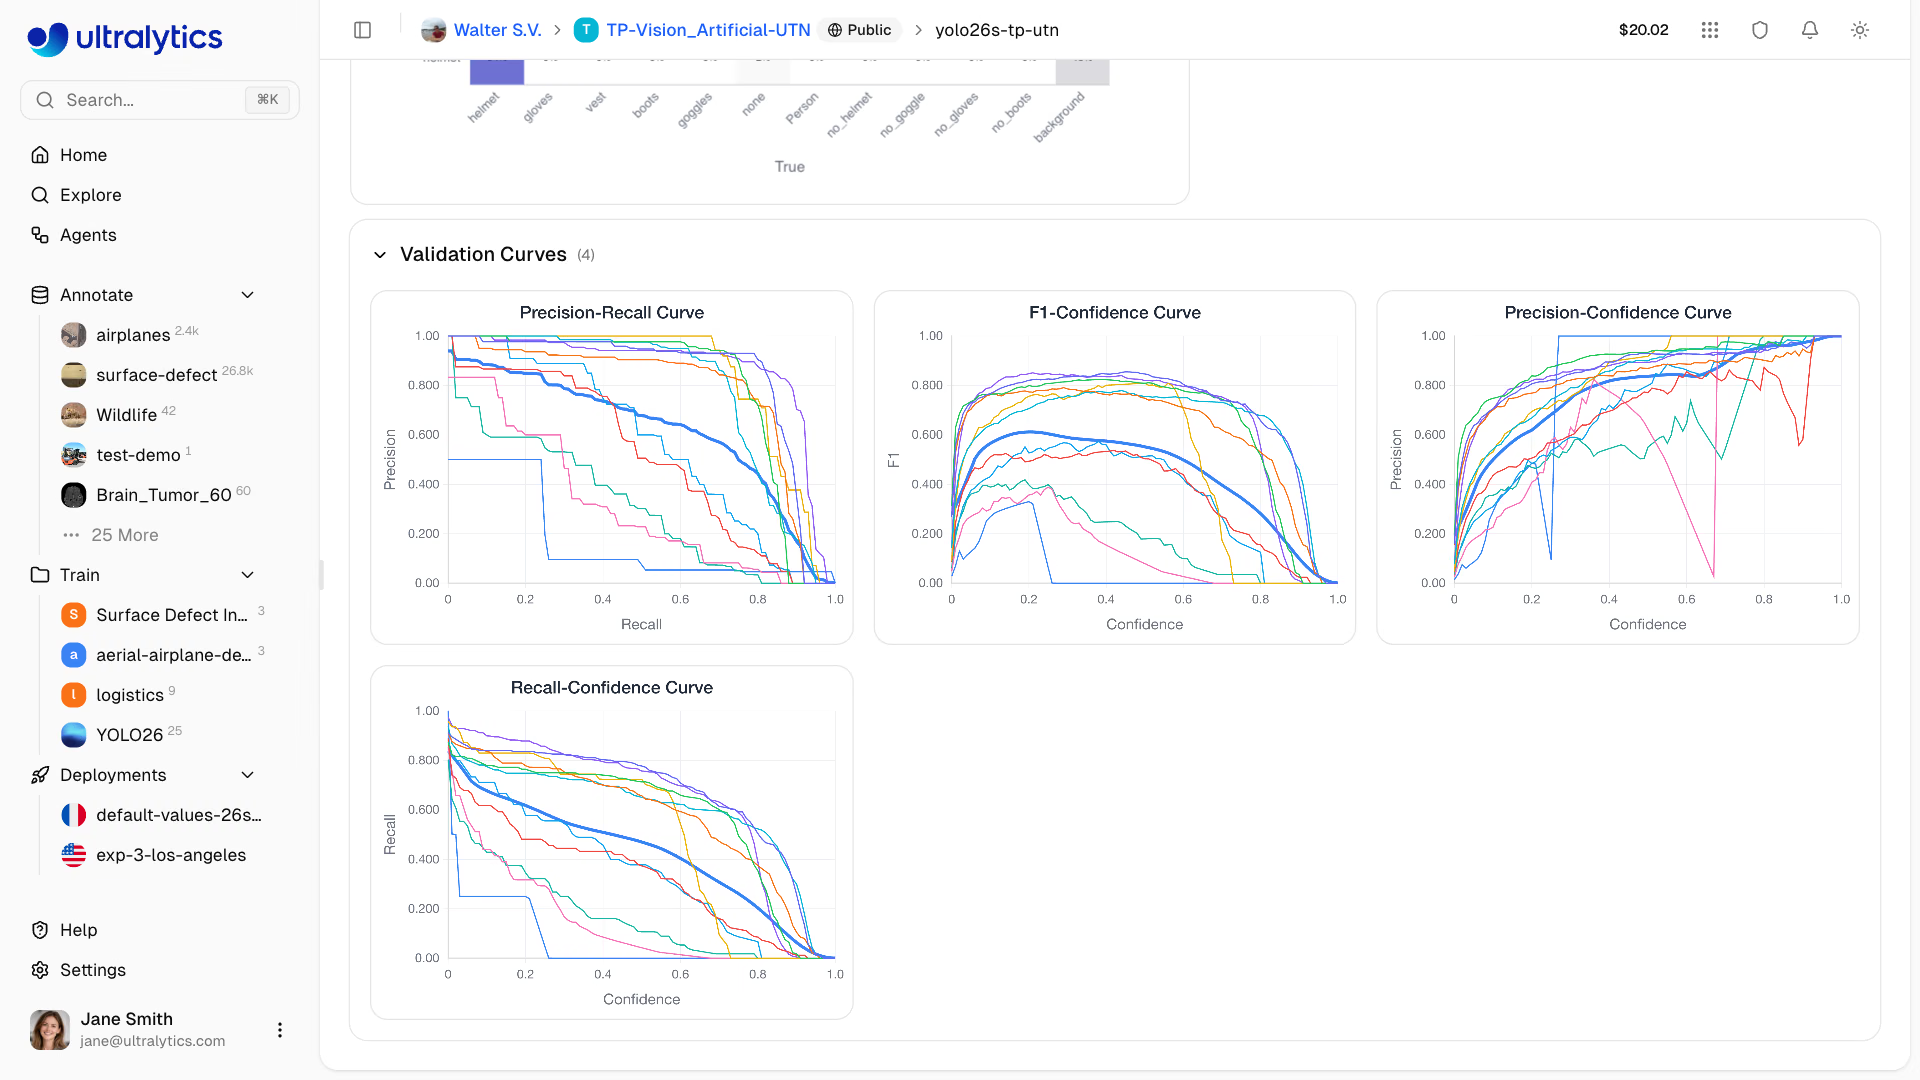
Un progetto elenca i modelli con caselle di selezione. I modelli selezionati vengono sovrapposti nella dashboard Charts; la vista Table affianca gli argomenti di training e le metriche finali, mentre Diff nasconde le colonne identiche così puoi vedere subito che due esecuzioni differiscono solo per imgsz. Il confronto è possibile all'interno di un singolo progetto, quindi raggruppa gli esperimenti correlati (puoi tagliare e incollare i modelli tra progetti). Quando esamini le curve, confronta il valore finale, la rapidità con cui ciascuna esecuzione lo ha raggiunto e la regolarità dell'andamento.

Con due o più modelli completati, Compare with AI chiede ad Ask AI di riepilogare le differenze e proporre il prossimo esperimento. Considera la proposta un'ipotesi per la prossima esecuzione, non un verdetto.
Rendi ogni esecuzione comprensibile#
I nomi danno il contesto: run_5 non dice nulla, mentre v3_pallets_added e v4_imgsz1024 indicano la versione del dataset e le modifiche apportate. Per documentare il ragionamento, apri More actions > Information nella pagina del modello e salva una nota JSON come Custom Metadata:
{
  "hypothesis": "Pallet AP is low because val holds only 7 pallets",
  "change": "Dataset v3: +80 pallet images from cam03 and cam07; fine-tuned from v2",
  "result": "Pallet AP 0.31 -> 0.58, overall mAP50-95 0.51 -> 0.59",
  "next": "Forklift recall drops at night; collect dawn and dusk footage"
}
Platform registra il resto: la scheda Run Information mostra GPU, tariffa oraria, costo totale, versione ultralytics, host, modello padre, versione del dataset bloccata, commit Git quando disponibile e un comando yolo train copiabile. I confronti sono validi solo tra esecuzioni sulla stessa versione del dataset; per questo ogni esecuzione dovrebbe averne una bloccata.
Scegli la metrica e definisci i criteri prima di esaminare i risultati#
| Metrica | Quando è la scelta giusta |
|---|---|
| mAP50-95 | Impostazione predefinita per detect, segment, pose e OBB: premia i box precisi ed è sufficientemente stabile per i confronti |
| mAP50 | Oggetti grandi e ben separati, per i quali la precisione dei box conta poco |
| AP per classe, per una singola classe | Una classe determina il valore per l'attività |
| Richiamo a precisione fissata | Sistemi di sicurezza e di allarme |
| Latenza di inferenza sul dispositivo di destinazione | Sempre, come limite inderogabile |
La guida alle metriche di prestazione di YOLO le illustra tutte. Un modello candidato viene distribuito solo se supera ogni criterio:
Esempio pratico: uno script di approvazione#
Scarica i file best.pt dei modelli finalisti e valutali sugli stessi dati con lo stesso codice. Questo esempio usa due checkpoint ufficiali, quindi può essere eseguito ovunque:
from ultralytics import YOLO

DATA = "coco8.yaml"  # identical held-out data for both runs; use your test split for the final call
BASELINE, CANDIDATE = "yolo26n.pt", "yolo26s.pt"  # e.g. best.pt from two Platform runs
NOISE, CLASS_FLOOR, LATENCY_BUDGET_MS = 0.005, 0.90, 100.0

def evaluate(weights):
    m = YOLO(weights).val(data=DATA, plots=False, verbose=False)
    per_class = {m.names[int(c)]: ap for c, ap in zip(m.box.ap_class_index, m.box.ap)}
    return m.box.map, per_class, m.speed["inference"]

(base_map, base_ap, _), (cand_map, cand_ap, cand_ms) = evaluate(BASELINE), evaluate(CANDIDATE)
weak = [n for n, ap in base_ap.items() if cand_ap.get(n, 0) < CLASS_FLOOR * ap]
gates = {
    f"mAP50-95 {base_map:.3f} -> {cand_map:.3f} beats noise": cand_map - base_map > NOISE,
    f"every class keeps {CLASS_FLOOR:.0%} of its AP (weak: {', '.join(weak) or 'none'})": not weak,
    f"inference {cand_ms:.1f} ms within {LATENCY_BUDGET_MS:.0f} ms": cand_ms <= LATENCY_BUDGET_MS,
}
for name, ok in gates.items():
    print("PASS" if ok else "FAIL", name)
print("verdict:", "ship the candidate" if all(gates.values()) else "keep the baseline, run more experiments")
raise SystemExit(0 if all(gates.values()) else 1)  # non-zero exit blocks a CI release step
PASS mAP50-95 0.669 -> 0.693 beats noise
FAIL every class keeps 90% of its AP (weak: elephant, potted plant)
PASS inference 44.1 ms within 100 ms
verdict: keep the baseline, run more experimentsRisultato: il modello più grande vince nel complesso con 2.4 punti di vantaggio, ma due classi perdono oltre il 10% del loro AP, quindi non supera la verifica. È una regressione che un confronto basato solo sulla metrica principale non mostra. Il dizionario per classe proviene da ap_class_index e ap, che includono solo le classi presenti nei dati; la latenza viene misurata sulla macchina che esegue lo script, quindi applica il criterio su hardware simile a quello di destinazione. COCO8 contiene solo 8 immagini di convalida: sono troppo poche per prendere una decisione reale. Usa un set escluso dall'addestramento di almeno qualche centinaio di immagini e passa split="test" una sola volta, per la decisione finale.
Esamina le immagini problematiche#
Per le esecuzioni di rilevamento addestrate con una versione salvata del dataset, la vista Validation aggiunge Validation insights: le immagini con le prestazioni peggiori e migliori, ordinate in base a F1 per immagine e visualizzate con le annotazioni di ground truth; un esploratore delle caratteristiche che correla F1 con dimensione, proporzioni e numero di istanze dell'immagine; e le classi più associate agli errori. Find similar sulle immagini peggiori aggiunge immagini simili al set di training come immagini non etichettate, trasformando una verifica non superata in un'attività concreta sui dati.
Insidie#
Sintomo: la mAP di test riportata è ottima, ma in produzione le prestazioni sono peggiori. Soluzione: ottimizza usando la partizione di convalida. Se hai confrontato dieci esecuzioni sulla partizione di test, l'hai usata per l'ottimizzazione e il suo risultato è troppo ottimistico. Valuta i finalisti sulla partizione di test una sola volta, alla fine.
Sintomo: un'esecuzione risulta «vincitrice» con 4 punti di vantaggio e nessuno riesce a riprodurre il motivo. Soluzione: controlla la versione del dataset fissata nella scheda Run Information di ogni esecuzione. Se le versioni differiscono, riesegui il baseline sulla nuova versione prima di fare il confronto.
Sintomo: il vincitore cambia ogni volta che riaddestri con un nuovo seed. Soluzione: nella maggior parte dei dataset, differenze inferiori a circa 0,5 punti mAP sono rumore tra un'esecuzione e l'altra. Mantieni la soglia del rumore nel gate e, quando i risultati sono così vicini, usa un set di holdout più ampio.
Mostra la soluzione
Esempio svolto sul modello delle pillole: baseline v1-baseline (10 epoche) a confronto con il modello candidato v2-finetune (altre 5 epoche, SGD, lr0 0.001). Imposta DATA = "medical-pills.yaml" e i due pesi in gate.py. Output: PASS mAP50-95 0.659 -> 0.687 beats noise, PASS every class keeps 90% of its AP (weak: none), PASS inference 4.0 ms within 100 ms, verdetto 'distribuire il modello candidato'. Custom Metadata per v2: ipotesi 'v1 stava ancora migliorando all'epoca 10', modifica 'fine-tuning per 5 epoche, SGD lr0 0.001', risultato 'mAP50-95 0.659 -> 0.687'. Nota la seguente avvertenza nei metadati: anche la convalida di medical-pills ha guidato l'addestramento, quindi prima della produzione verifica il modello su un set di dati separato.