最初のモデルを学習する
1回の呼び出しでデータセット上のYOLO26をファインチューニングし、学習ログをリアルタイムで1行ずつ読み、実行フォルダーからbest.ptと重要なプロットを見つけます。
検出器をスクラッチから学習するには、数日と膨大なデータセットが必要です。約100枚の画像で事前学習済みYOLO26をファインチューニングする場合、ノートPCのCPUで約1分です。転移学習によって、モデルがエッジ、形状、物体についてすでに学習した知識を再利用できるためです。
このレッスンでは、錠剤データセットで学習し、mAP50-95がほぼゼロのベースラインから10エポックで0.66まで上昇する様子を確認します。また、ログを見て、実行が健全か時間を無駄にしているかを早い段階で判断する方法を学びます。
実践的
実践例:錠剤検出器を学習する#
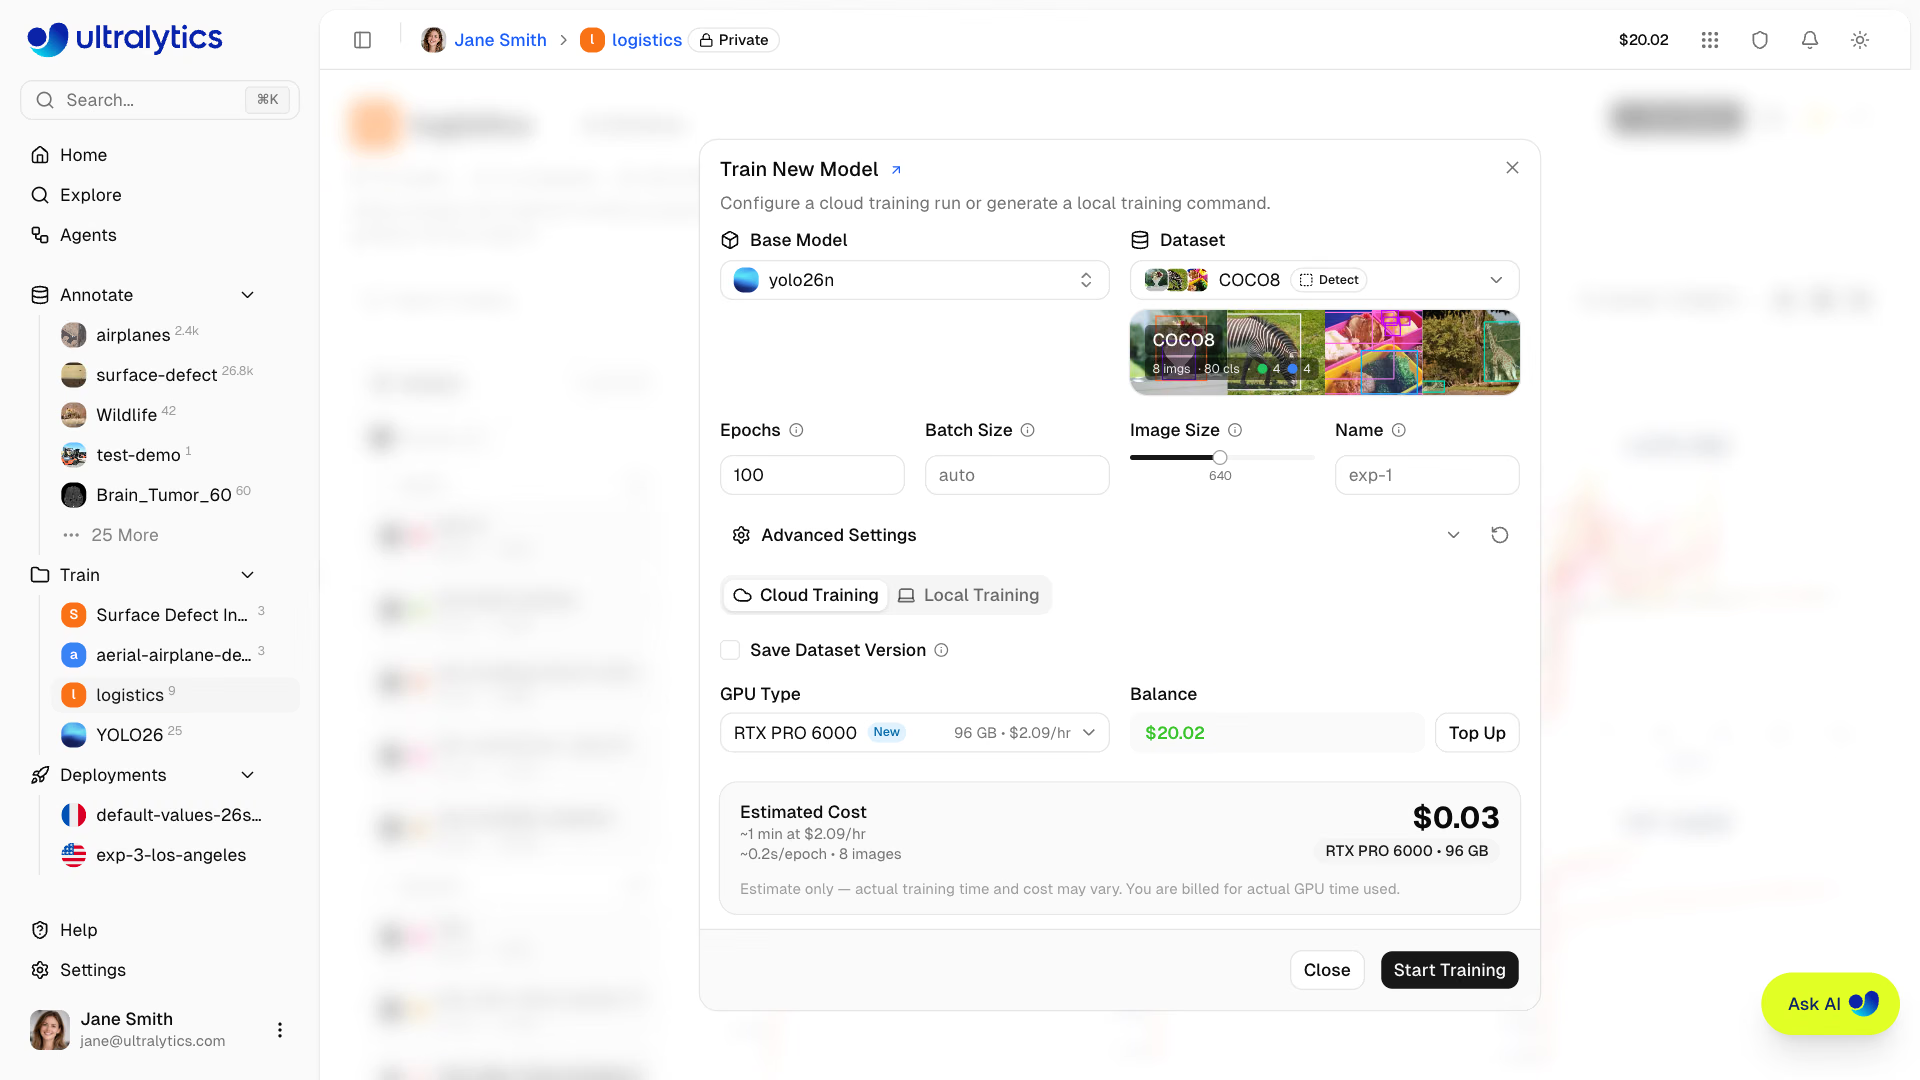
Ultralytics Platformの「新しいモデルを学習」ダイアログでは、以下のコードと同じ項目(ベースモデル、データセット、エポック数、画像サイズ)を指定します。設定をクラウドGPUで実行するか、対応するローカルコマンドを生成できます。これらの設定ならノートPCのCPUでも約1分で完了します。
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # COCOで事前学習済み
results = model.train(data="my_dataset/data.yaml", epochs=10, imgsz=320, name="pills_v1")
print(results.save_dir)CLIとPythonは同等です。epochs=10 と imgsz=320 はCPUでの実行時間を短くする設定です。GPUでは両方を省略してデフォルト(epochs=100、imgsz=640)を使用します。エポック数とピクセル数を増やすと、ほとんどの場合に精度が向上するためです。Trainモードでは、このループが自動で実行されます。
ログを1行ずつ読む#
実際の出力を、最初と最後の2エポックに絞って示します。
optimizer: AdamW(lr=0.002, momentum=0.9) with parameter groups ...
Using 92 train, 23 val images for fraction=1.0 at imgsz=320
      Epoch    GPU_mem   box_loss   cls_loss    l1_loss  Instances       Size
       1/10         0G      1.818      3.899   0.008805        206        320: 100% 6/6 3.3s
                   all         23        399      0.957      0.805      0.927      0.548
       2/10         0G      1.434      3.291   0.006285        208        320: 100% 6/6 4.4s
                   all         23        399      0.953      0.911      0.964      0.592
       ...
       9/10         0G      1.121      1.103   0.005143        194        320: 100% 6/6 5.0s
                   all         23        399      0.949      0.957      0.975      0.656
      10/10         0G      1.174      1.125   0.005068        212        320: 100% 6/6 5.1s
                   all         23        399       0.97      0.957      0.977      0.659
10 epochs completed in 0.015 hours.
optimizer: AdamW(lr=0.002 ...):デフォルトのoptimizer=autoが、オプティマイザーと学習率を自動で選択しました。Using 92 train, 23 val images:これらがデータセットと一致していることを確認します。数が少ない場合は、画像がスキップされています。GPU_mem 0G:CPUで学習しています。GPUの場合はここに使用中のメモリが表示されます。GPU搭載マシンで0Gと表示される場合、GPUは使用されていません。- 各エポックの最初の行:学習用データ分割の3つの損失と、最後のバッチに含まれるラベル付き物体の数(
Instances)、画像サイズが表示されます。 - 各エポックの
all行:検証用データ分割の適合率、再現率、mAP50、mAP50-95が表示されます。注目すべきなのはこの行です。
| 列 | 意味 | 健全な推移 |
|---|---|---|
box_loss | 予測ボックスとラベル付きボックスのずれ | 低下してから横ばいになります |
cls_loss | クラススコアの誤差 | 低下してから横ばいになります |
l1_loss | YOLO26のボックス座標に関する直接的な誤差 | 低下します |
P, R | 検証用データ分割の適合率と再現率 | 上昇し、バランスを保ちます |
mAP50, mAP50-95 | 検出品質です。mAP50-95はボックスの精密さも評価します | 上昇してから頭打ちになります |
ここでは、mAP50-95はベースラインの0.0002から1エポック後に0.548、10エポック後に0.659になりました。適合率はエポック4で0.80まで下がった後、回復しました。検証画像は23枚なので、エポックごとの数値にはばらつきがあります。単独の行ではなく、推移を見て判断してください。実行中の判断基準は次のとおりです。
- 損失が低下し、mAPが上昇している場合: 続行します。
- 1エポック目から損失が横ばいの場合: Ctrl+Cで停止し、ラベルとYAMLを確認します。
- 適合率が再現率を大きく上回る場合: モデルが慎重になり、物体を見逃しています。再現率が適合率を大きく上回る場合: 実際には存在しない物体にも反応しています。
- mAPが多くのエポックで横ばいの場合: エポック数を増やしても改善しません。データまたは
imgszを変更します。
3つの損失はYOLO26の損失関数を構成する要素です。性能指標ガイドでは、各指標を詳しく解説しています。
実行結果を確認する#
すべて runs/detect/pills_v1/ に保存されます。
| ファイル | 用途 |
|---|---|
weights/best.pt | エポック全体で検証フィットネスが最良だったときのチェックポイントです。推論とエクスポートに使用します |
weights/last.pt | 最新のチェックポイントです。中断した実行の再開に使用します |
args.yaml | 実行時に使用したすべての引数です。再現に使用します |
results.csv, results.png | エポックごとの損失と指標が、データとプロットで保存されます |
labels.jpg | クラス数と、ボックスのサイズおよび位置のヒストグラム |
train_batch*.jpg | ラベルが描画された、拡張後の学習バッチ |
val_batch*_labels.jpg, val_batch*_pred.jpg | 検証画像上の正解データと予測 |
confusion_matrix*.png, Box*_curve.png | 混同行列と、適合率、再現率、F1、PR曲線 |
まず train_batch0.jpg を開いてください。ボックスが物体に重なっていない場合、ラベルが間違っています。エポック数を増やしても解決しません。
まず変更する引数#
| 引数 | デフォルト | 変更する場合 |
|---|---|---|
epochs | 100 | 短時間のCPU実験や、過学習が始まる小規模データセットでは減らします。まだ改善が続く大規模データセットでは増やします(200~300) |
imgsz | 640 | 小さい物体の場合は1024または1280に増やし、CPU実験では減らします |
batch | 16 | バッチサイズ:メモリ不足エラーが発生した場合は減らします。または -1 を使い、GPUメモリの約60%を使用するよう自動調整します |
patience | 100 | 検証フィットネスがNエポックにわたって改善しない場合、早期停止します(例:patience=20) |
device | 自動 | cpu、mps、0 のようなGPUインデックス、または [0, 1] のような複数のGPUを指定します |
name | train | 常に、変更内容に基づいて実行に名前を付けます |
model.train(data="my_dataset/data.yaml", epochs=200, imgsz=1024, batch=-1, patience=20, name="pills_v1_1024")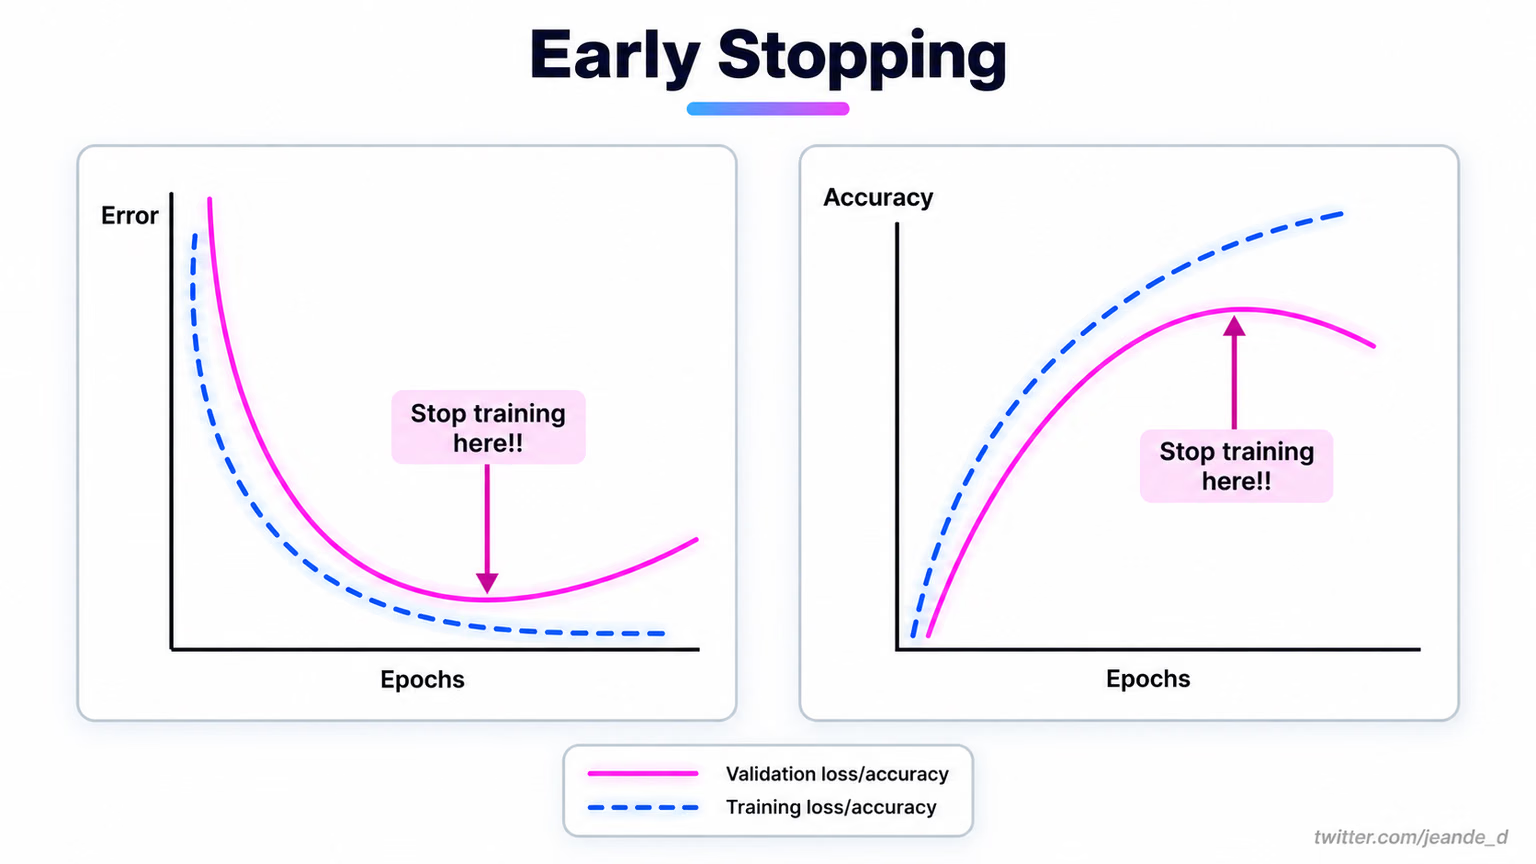
patience のデフォルト値100では、100エポックの実行が早期停止しません。より小さい値にすると、上の曲線が示す停滞した実行を終了できます。どちらの場合も best.pt は保持されます。
複数のGPUを使う場合は、device=[0, 1, 2, 3] のようなリストを渡します。Ultralyticsが分散データ並列(DDP)学習を自動で開始します。batch はGPU全体での合計値であり、学習ではデフォルトで混合精度(amp=True)が使用されます。ノートPCでは対応できない規模の実行になった場合も、同じデータセットと引数をUltralytics Platform上のクラウドGPUで実行できます。詳しくは学習、実行の確認、ファインチューニングをご覧ください。
次の間違いに注意する#
症状: 小規模なデータセットで多くのエポックを実行しても、mAPがほぼゼロです。原因: モデルの重みが yolo26n.pt ではなく yolo26n.yaml(ランダムな重み)から始まっています。対処: 必ず事前学習済みの .pt から開始してください。スクラッチからのトレーニングが有効なのは、バックボーンの研究や非常に大規模なデータセットの場合に限られます。
症状: 最初のエポックで CUDA out of memory が発生します。対処: batch を半分にするか、batch=-1 を設定して、AutoBatchが収まるサイズを選ぶようにしてください。imgsz を小さくする方法もありますが、モデルが認識できる内容が変わります。
last.pt は最終エポックを指し、それ以前のエポックより性能が低い場合があります。best.pt は検証時のfitnessが最も高かったエポックであり、検証、エクスポート、デプロイに使うべきものです。
残りの引数についてはモデル学習のヒントガイド、学習率の探索と遺伝的チューナーについてはハイパーパラメータチューニングガイドで説明しています。ファインチューニングガイドではレイヤーの凍結を解説しています。
解答を表示
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
results = model.train(data="my_dataset/data.yaml", epochs=10, imgsz=320, name="pills_v1")
print(results.save_dir)  # runs/detect/pills_v1
Baseline (yolo26n.pt, no pill class): mAP50 0.001, mAP50-95 0.0002
pills_v1 (10 epochs, imgsz 320, CPU, ~1 min): mAP50 0.977, mAP50-95 0.659
Plateau: mAP50-95 gains shrink after epoch 8 (0.649 -> 0.656 -> 0.659)
train_batch0.jpg: yes, boxes sit on the pills正確な数値は、ハードウェアやパッケージのバージョンによって多少異なります。