カスタムデータセットを準備する
画像とラベルをUltralytics YOLO形式で配置し、ピクセル座標のBBoxを正規化したラベル行に変換して、学習前に不正なラベルを見つけます。
フォルダー名の誤りや正規化されていないラベルがあっても、学習は停止しません。Ultralyticsは問題のある画像をスキップして処理を続けます。その結果、データの一部だけで学習し、性能の低いモデルができ、原因を見当違いの場所で探して午後を無駄にすることになります。
このレッスンでは、物体検出データセットのフォルダー構成、ラベル行、変換、チェックといった実務的な部分を扱います。このコースの以降のレッスンで学習に使う、実際の画像115枚からなる医療用錠剤データセットを使用します。何を収集し、どのようにラベル付けするかについては、アノテーションのベストプラクティスで説明します。
実践的
練習用データセットを入手する#

以下の構成は、zipファイルとしてUltralytics Platformの「New Dataset」ダイアログにアップロードできる形式でもあるため、ここで準備したデータセットはそのままアップロードできます。ブリスターパックに入った錠剤の学習用フレーム92枚と検証用フレーム23枚をダウンロードし、my_datasetに展開します。
curl -L -o medical-pills.zip https://github.com/ultralytics/assets/releases/download/v0.0.0/medical-pills.zip
unzip -q medical-pills.zip -d my_dataset
my_dataset/
├── images/
│ ├── train/ Frame_0.jpg, Frame_100.jpg, ... (92 images)
│ └── val/ Frame_144.jpg, ... (23 images)
└── labels/
├── train/ Frame_0.txt, Frame_100.txt, ... (92 files)
└── val/ Frame_144.txt, ... (23 files)マニフェストはありません。Ultralyticsは画像パスの/images/を/labels/に、拡張子を.txtに置き換えて各ラベルを見つけます。そのため、images/val/Frame_144.jpgはlabels/val/Frame_144.txtを読み込みます。これには次の2つの点が関係します。
- フォルダーは、横並びにして正確に
imagesとlabelsという名前にする必要があります。 - ラベルファイルが空、または存在しない画像は背景画像です。有効な画像であり、モデルに検出対象ではないものを学習させるのに役立ちますが、意図して用意した場合に限ります。
ラベル行を読み解く#
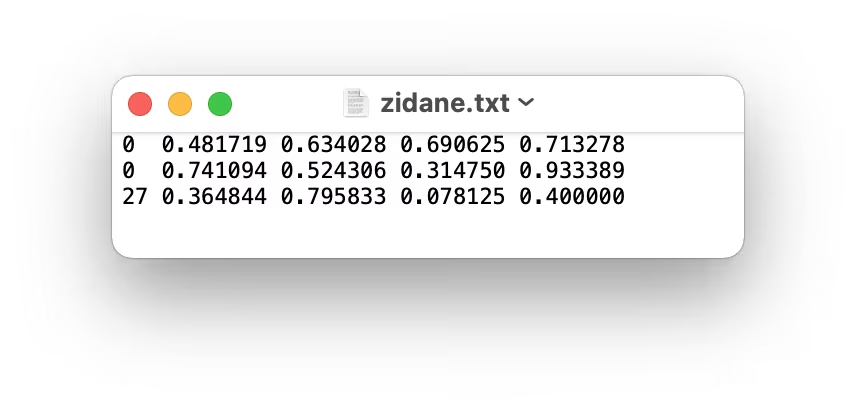
各行は1つのオブジェクトを表します。整数のクラスインデックスに続いて、画像の幅と高さに対する比率で表したバウンディングボックスの中心座標とサイズを記載します。labels/train/Frame_0.txtからの実際の行は次のとおりです。
0 0.330729 0.816204 0.103125 0.1212960:クラスインデックスは0で、YAMLではpillという名前になります。0.330729 0.816204:BBoxの中心は、画像の左端から横方向に33%、上端から下方向に82%の位置にあります。0.103125 0.121296:BBoxの幅は画像の約10%、高さは約12%です。
実例:ピクセル座標のBBoxを変換する#
アノテーションツールでは、ピクセル単位の角の座標(x1, y1, x2, y2)が出力されることがよくあります。画像サイズで割ってください。前のレッスンで使った810×1080のbus.jpgでは、左端の人物の範囲は(49, 398)から(240, 902)です。
| 項目 | 数式 | 値 |
|---|---|---|
x_center | (x1 + x2) / 2 / width | (49 + 240) / 2 / 810 = 0.178395 |
y_center | (y1 + y2) / 2 / height | (398 + 902) / 2 / 1080 = 0.601852 |
width | (x2 − x1) / width | 191 / 810 = 0.235802 |
height | (y2 − y1) / height | 504 / 1080 = 0.466667 |
多くのアノテーションツールや、Roboflowなどのツールでは、YOLO形式に直接エクスポートできます。COCO JSONの場合は、COCO JSON学習ガイドに従ってください。JSON2YOLOリポジトリでは、その他の形式について説明しています。Pascal VOC XMLの場合、上記の計算式を短いスクリプトで実行できます。
import xml.etree.ElementTree as ET
from pathlib import Path

CLASSES = ["person", "bus"]  # index = class id; must match names in data.yaml

def voc_to_yolo(xml_file: Path, out_dir: Path) -> None:
    root = ET.parse(xml_file).getroot()
    w, h = int(root.find("size/width").text), int(root.find("size/height").text)
    lines = []
    for obj in root.iter("object"):
        name = obj.find("name").text
        if name not in CLASSES:
            continue
        box = obj.find("bndbox")
        x1, y1, x2, y2 = (float(box.find(k).text) for k in ("xmin", "ymin", "xmax", "ymax"))
        xc, yc, bw, bh = (x1 + x2) / 2 / w, (y1 + y2) / 2 / h, (x2 - x1) / w, (y2 - y1) / h
        lines.append(f"{CLASSES.index(name)} {xc:.6f} {yc:.6f} {bw:.6f} {bh:.6f}")
    out_dir.mkdir(parents=True, exist_ok=True)
    (out_dir / f"{xml_file.stem}.txt").write_text("\n".join(lines) + "\n")

voc_to_yolo(Path("bus.xml"), Path("labels"))
print(Path("labels/bus.txt").read_text())前のレッスンで使った人物とバスのBBoxを含むbus.xmlに対して実行すると、実例とバスの結果が出力されます。
0 0.178395 0.601852 0.235802 0.466667
1 0.495679 0.454167 0.991358 0.482407学習前に確認する#
いくつかのラベルファイルの内容を画像に描画してください。クラスのずれ、xとyの取り違え、影を囲むBBoxは目で見れば明らかですが、指標には現れません。
from ultralytics.data.utils import visualize_image_annotations

visualize_image_annotations(
    "my_dataset/images/train/Frame_0.jpg",
    "my_dataset/labels/train/Frame_0.txt",
    {0: "pill"},
)
次に、Ultralyticsですべてのファイルを確認します。データセットを初めて読み込む際にラベルをスキャンし、画像ごとに利用可能かどうかを行単位で判定します。
スキャン結果に処理内容が表示されます。正常なデータセットでは23 images, 0 backgrounds, 0 corruptとなります。それ以外の表示は、以下のいずれかのミスを示します。
次の間違いに注意する#
症状: ignoring corrupt image/label: non-normalized or out of bounds coordinates [634. 881. 198. 163.] と、ゼロではない corrupt の値。原因: ピクセル値を分数として扱っています。対処: 画像の幅と高さで割ってください。ラベル値が1を超えている場合、ボックスが正規化されていません。
症状: yolo val が 0 images, 23 backgrounds をスキャンして No labels found と警告し、トレーニングが ValueError: train: No labels found で停止します。ここではラベルフォルダーの名前が annotations だったことが原因です。対処: フォルダー名を正確に images と labels にし、ファイル名も一致させてください。
症状: Label class 1 exceeds dataset class count 1. Possible class labels are 0-0。原因: エクスポートツールがクラス番号を1から付けています。対処: YOLOのクラスは0から始まります。変換スクリプトで1を引くか、エクスポート設定を修正してください。
ボックスが半分ずつ下と右にずれて描画される場合は、x_center y_center w h ではなく x1 y1 w h を記述しています。ファイルを1つ描画すれば数秒で見つかりますが、スキャンチェックでは見つかりません。
データセット全体を体系的にチェックする方法については、データセットの品質管理を参照してください。coco8、coco128、african-wildlifeなどの組み込みデータセットは、構成の参考になります。データセットの概要では、すべてのデータセットを紹介しています。トレーナーはラベルにデータ拡張を適用するため、ここで簡単にデータクレンジングを行うと、すべてのエポックで効果が得られます。
解答を表示
for s in train val; do
  echo "$s: $(ls my_dataset/images/$s | wc -l) images, $(ls my_dataset/labels/$s | wc -l) labels"
done
# train: 92 images, 92 labels
# val:   23 images, 23 labels
from pathlib import Path
for txt in Path("my_dataset/labels").rglob("*.txt"):
for line in txt.read_text().splitlines():
values = [float(v) for v in line.split()[1:]]
if any(v < 0 or v > 1 for v in values):
print(txt, line)スクリプトから何も出力されなければ、すべての座標が正規化されています。各分割の数が一致していれば、すべての画像にラベルファイルがあります。次のレッスンでスキャン結果を確認し、破損したファイルがないことを確かめます。