アノテーションのベストプラクティス
ラベリングガイドを作成し、ツールを選び、精度をひそかに損なう10のミスを避け、スケールアップの前にスクリプトでアノテーター間の一致度を測定します。
ラベルの品質がモデルの品質の上限を決めます。10人のアノテーターがそれぞれ「パレット」の解釈を少しずつ変えると、データセットは10通りの解釈を同時に学習させることになり、どれだけ学習しても矛盾は解消されません。文書化されたガイド、測定可能なキャリブレーションラウンド、よくあるミスの簡潔なリストがあれば、1人で500枚にラベルを付ける場合も、チームで50,000枚に付ける場合も、一貫性を保てます。
実践的
アノテーションツールを選ぶ#
適切なツールは、タスク、チーム、トレーニングを行う場所によって異なります。
| ツール | 最適な用途 | 説明 |
|---|---|---|
| Ultralytics Platform | 7種類すべてのYOLOタスクに対応します。ボックス、ポリゴン、セマンティックマスク、キーポイント、回転ボックス、画像クラスを編集でき、深度マップのアップロードにも対応しています。SAMによるスマートアノテーションも利用できます | ラベル、データセットのグラフ、トレーニングを1か所で管理でき、エクスポートの手順が不要です |
| CVAT | 大規模チーム、動画、複雑なレビューのワークフロー | セルフホストまたはクラウド |
| Label Studio | マルチモーダルプロジェクト(画像 + テキスト + 音声) | 柔軟に設定できますが、習得には時間がかかります |
| Labelme | 小規模チームでのポリゴンラベリング | シンプルなデスクトップアプリ |
| LabelImg | ボックスのみの迅速なプロトタイプ作成 | 軽量ですが、リポジトリはアーカイブされています |
Ultralytics Platformでは、SAM 2.1、SAM 3、SAM 3.1によるスマートアノテーションを、detect、segment、semantic、OBBのデータセットで利用できます。どのツールを選ぶ場合も、タスクに必要なYOLO形式でエクスポートできることを確認してください。カスタムデータセットの準備では、ラベル形式と変換方法を説明しています。
7種類のラベル#

| ラベルの種類 | 描画するもの | タスク |
|---|---|---|
| クラスラベル | 画像ごとに1つのラベル | 分類 |
| バウンディングボックス | オブジェクトごとの軸に平行な長方形 | 検出 |
| ポリゴン | 各オブジェクトインスタンスの輪郭 | インスタンスセグメンテーション |
| 高密度マスク | すべてのピクセルにクラスを割り当てます | セマンティックセグメンテーション |
| キーポイント | 関節などの名前付きポイント | 姿勢 |
| 方向付きボックス | オブジェクトごとの回転した長方形 | OBB |
| 深度マップ | 描画するものはありません。深度センサーによるピクセルごとの距離マップで、各画像に対応付けられます | 深度推定 |
まずラベリングガイドを作成する#
誰かがボックスを描き始める前に、次の5つのセクションを含むガイドを作成します。
- クラスの定義:各クラスについて、該当する例、そのクラスに該当しない類似物、境界事例を含めて1段落で説明します。
- 描画ルール:見えているオブジェクトを囲むタイトなボックスを描き、ポリゴンは見えている輪郭に沿わせます。
- オクルージョンとサイズのルール:部分的に隠れたオブジェクトに対する基準(「クラスを識別できるならラベルを付ける」)と、小さなオブジェクトに対する基準(「高さ10ピクセルを超える人物にラベルを付ける」)をそれぞれ1つ定め、すべての画像に適用します。
- 曖昧なケースの記録:「これはどうする?」という質問ごとに、合意した回答とスクリーンショットを記録します。
- 除外するもの:このタスクでラベルを付ける価値がないものをすべて記載します。
スクリーンショット付きで1~2ページあれば十分です。このガイドを基に、ラベリングを大規模に始める前に短いループを実施します。
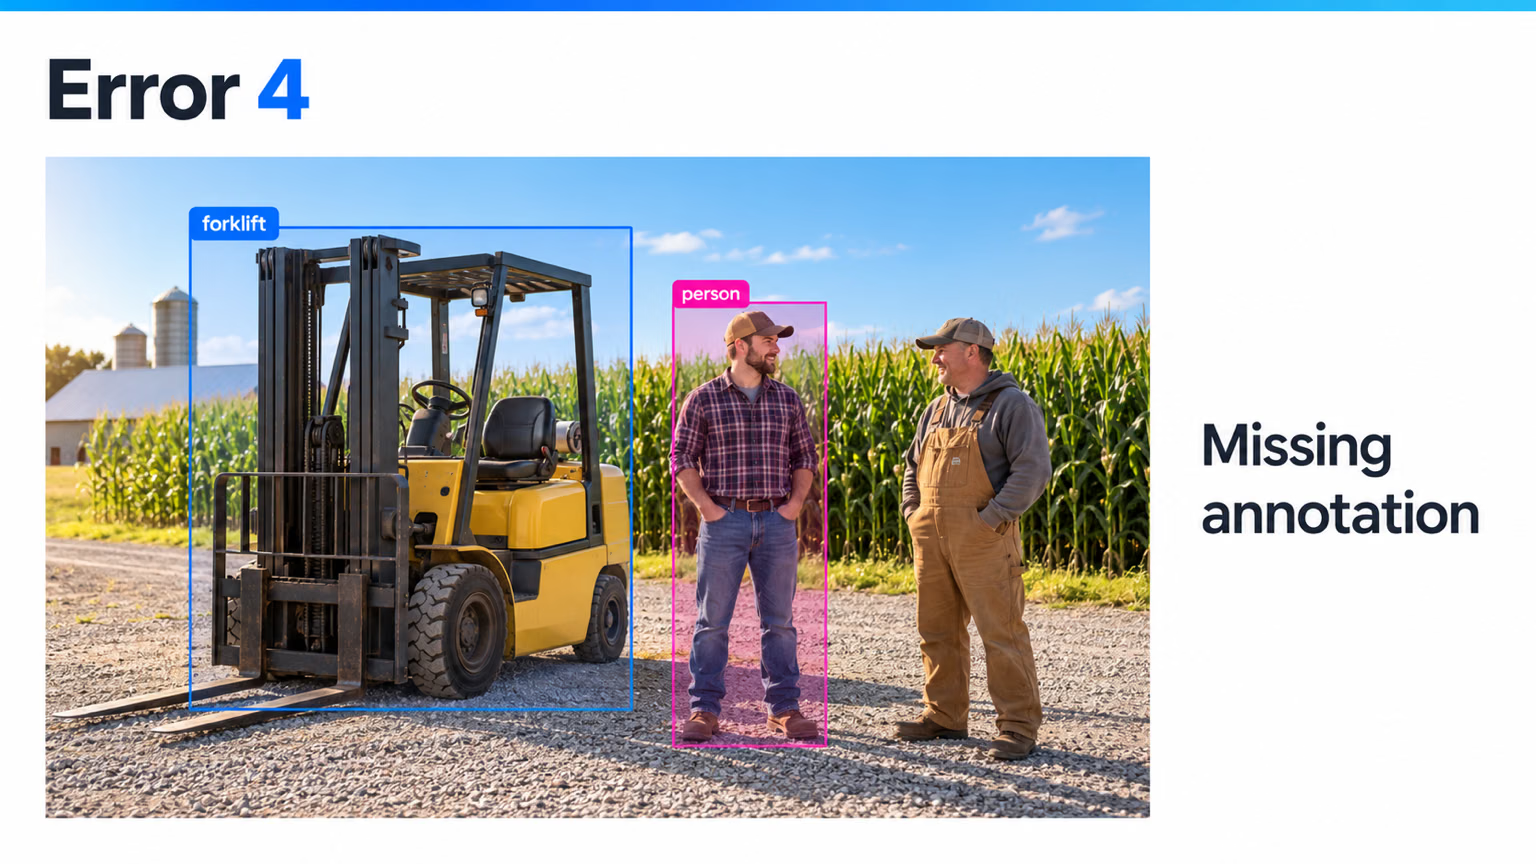
すべての画像で、関連する物体すべてにラベルを付けます。ラベルのないフォークリフトは、フォークリフトが背景になる場合もあるとモデルに学習させるため、検出漏れにつながります。一部しかラベル付けされていないデータセットは、学習するまで、完全にラベル付けされた小規模データセットと見分けがつきません。次の画像に進む前に、各画像の作業を完了します。
精度を損なう10のミス#
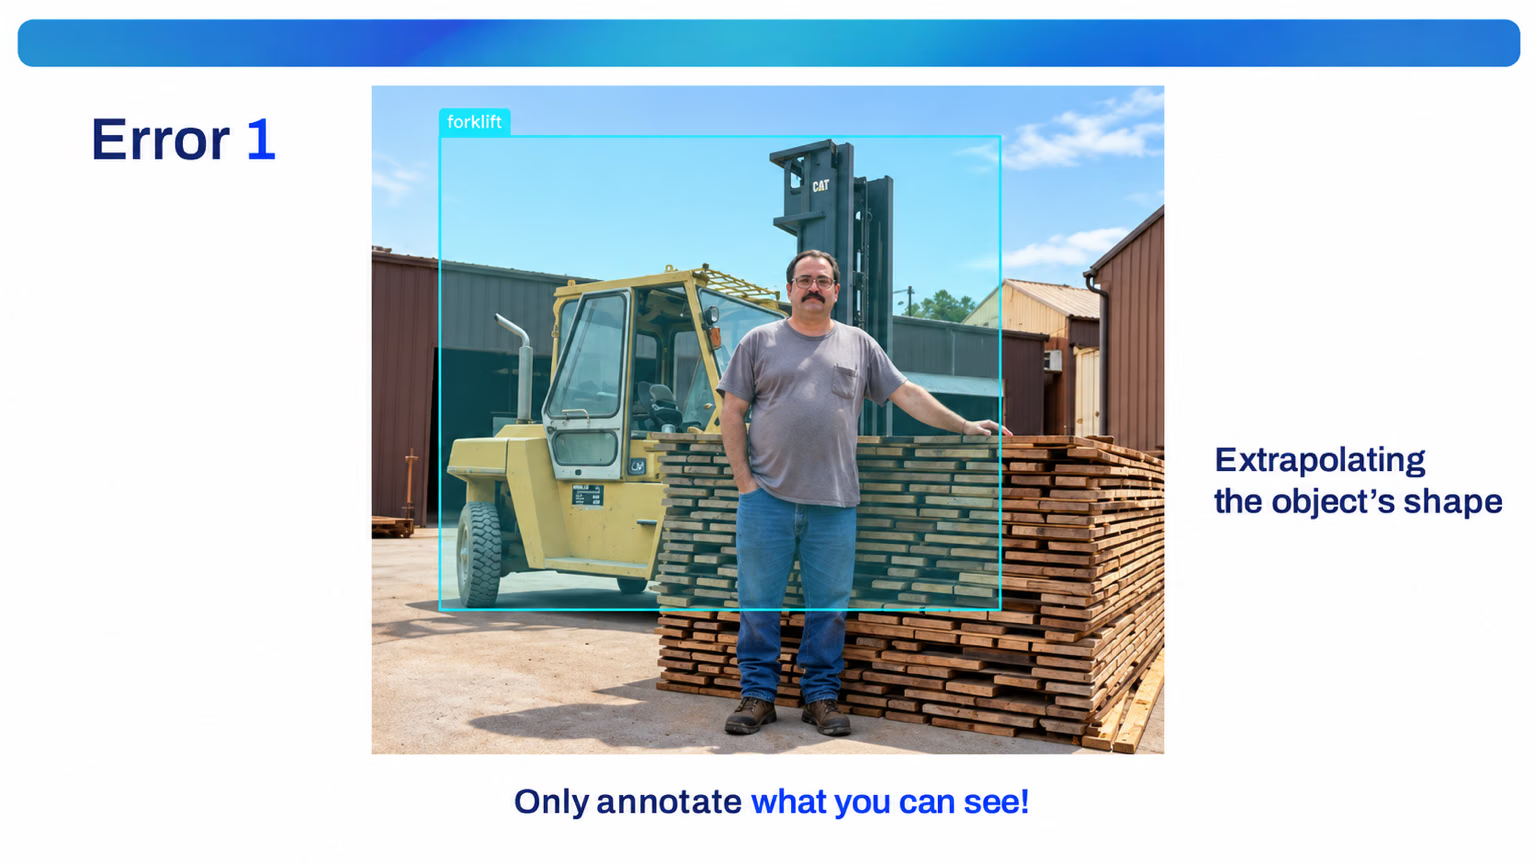
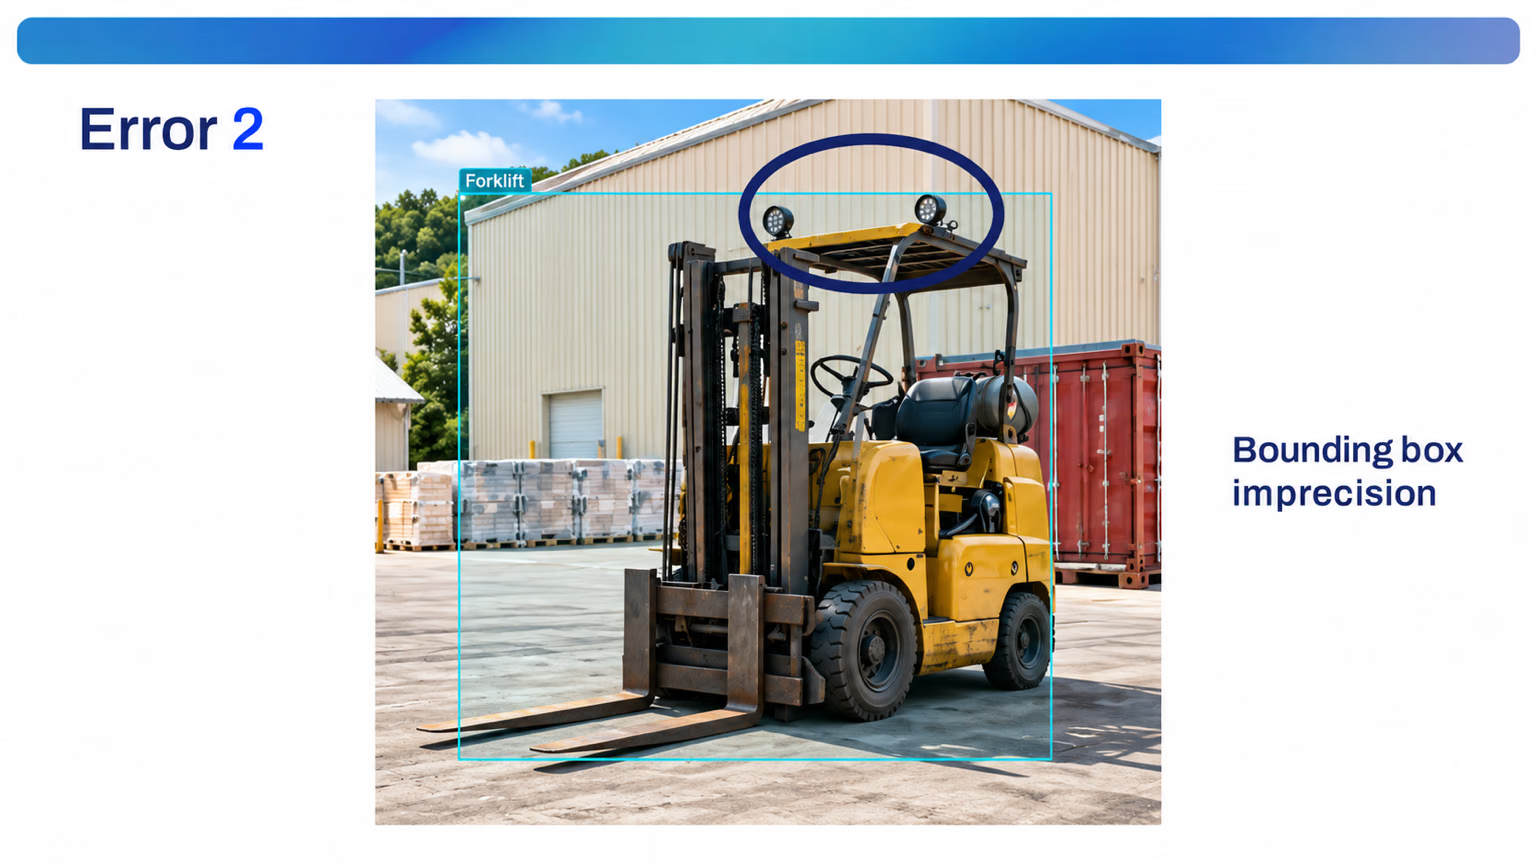
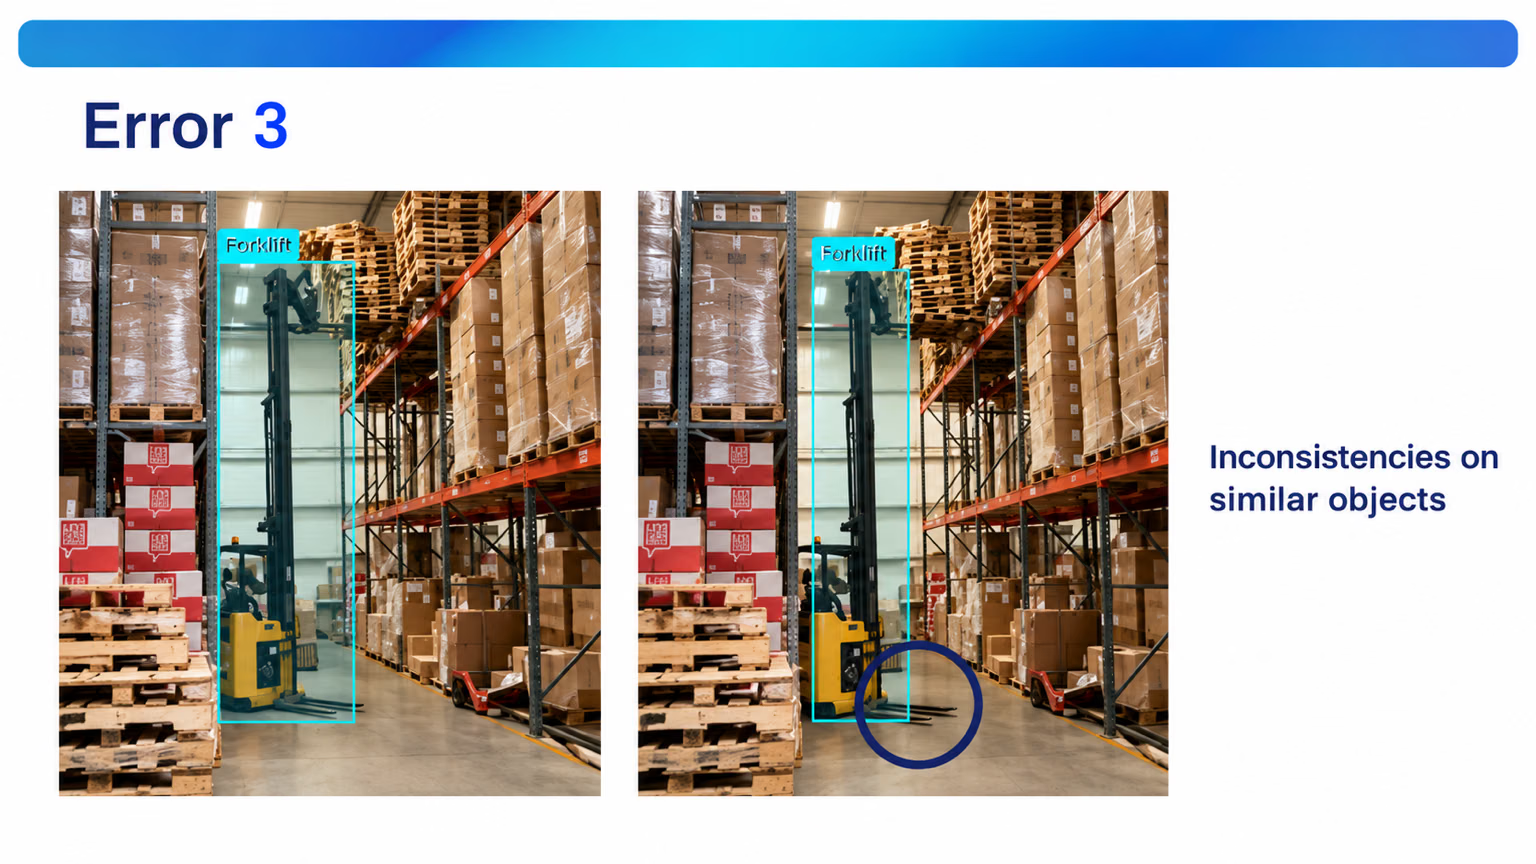
Ultralyticsのアノテーションチームがよく目にするエラーを、フォークリフト、人物、パレットの画像を使って説明します(Alexis Schutzgerの資料を基に編集)。これらをガイドの最初の項目として活用してください。
1. オブジェクトの形状を推測して補う。見えている部分だけをアノテーションします。この例では、フォークリフトは人物と木材の山の後ろにありますが、アノテーターがトラックの残りの部分を想像し、ボックスをその両方にまたがるように引いています。見えている部分だけを囲みます。
2. ボックスの精度が低い。ボックスはオブジェクトに沿わせる必要があります。この例では、上部ガードのライトを横切っています。オブジェクトの一部を切り取るボックスや、床との間に余白を残すボックスは、誤った範囲を学習させます。
3. 類似したオブジェクトに一貫性のないルールを適用する。左側のボックスにはフォークが含まれていますが、右側のボックスには含まれていません。同じ質問に対してモデルが異なる答えを学習するため、フォークを含めるのか、含めないのか、ルールを文書化します。
4. アノテーションの漏れ。フォークリフトの横に人物が2人立っていますが、ボックスが付いているのは1人だけです。ラベルのない人物は、「人物は背景である」という学習例になります。
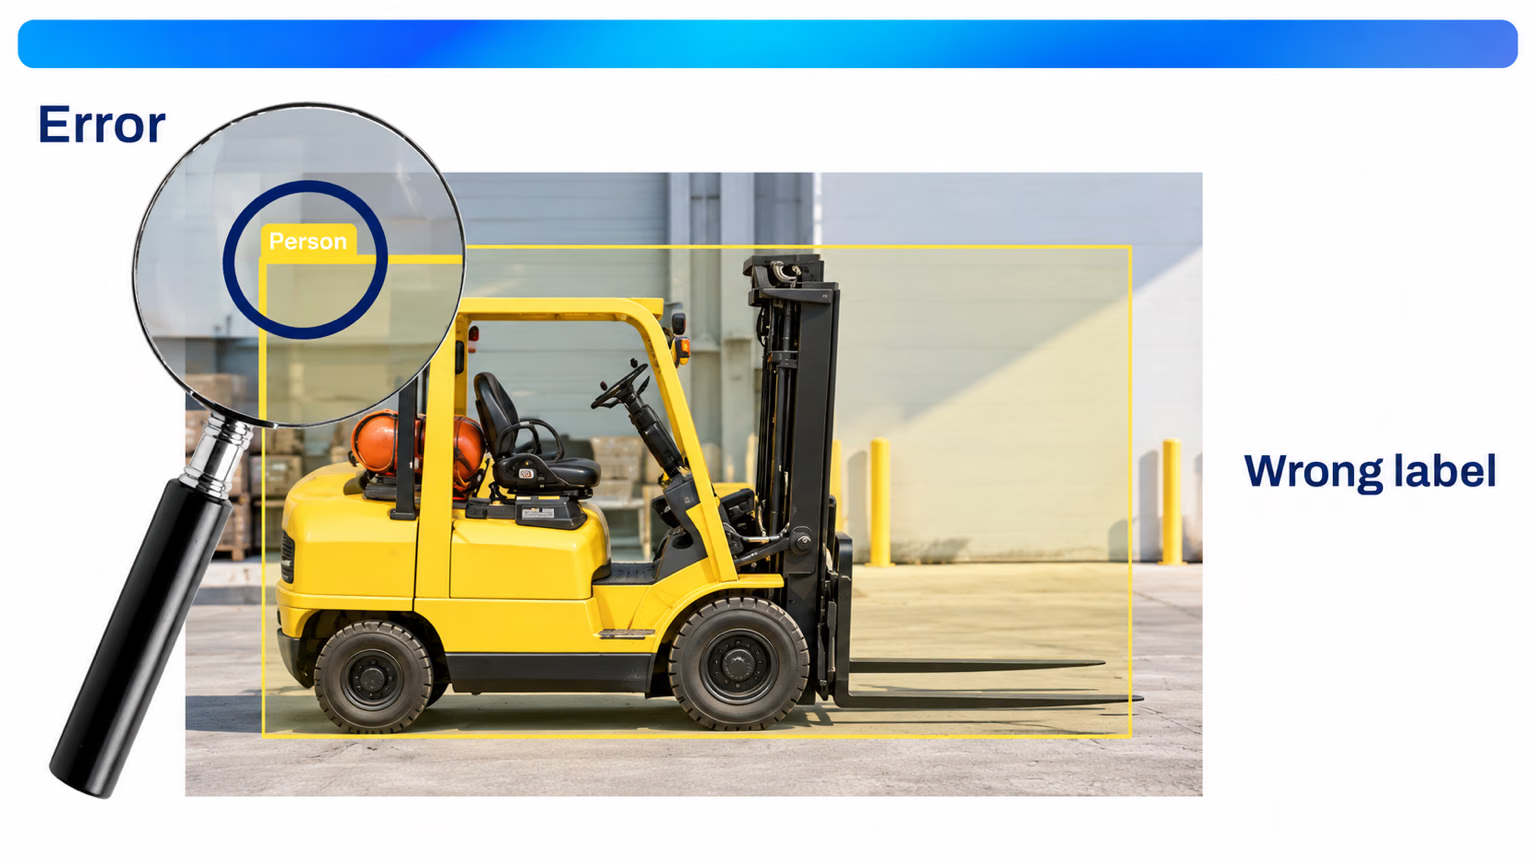
5. クラスの誤り。 ボックスだけでなく、クラスも確認してください。フォークリフトを正しく囲んだボックスに person のタグが付いていると、両方のクラスが誤ってしまいます。これはたいてい、キーボードショートカットの誤操作です。
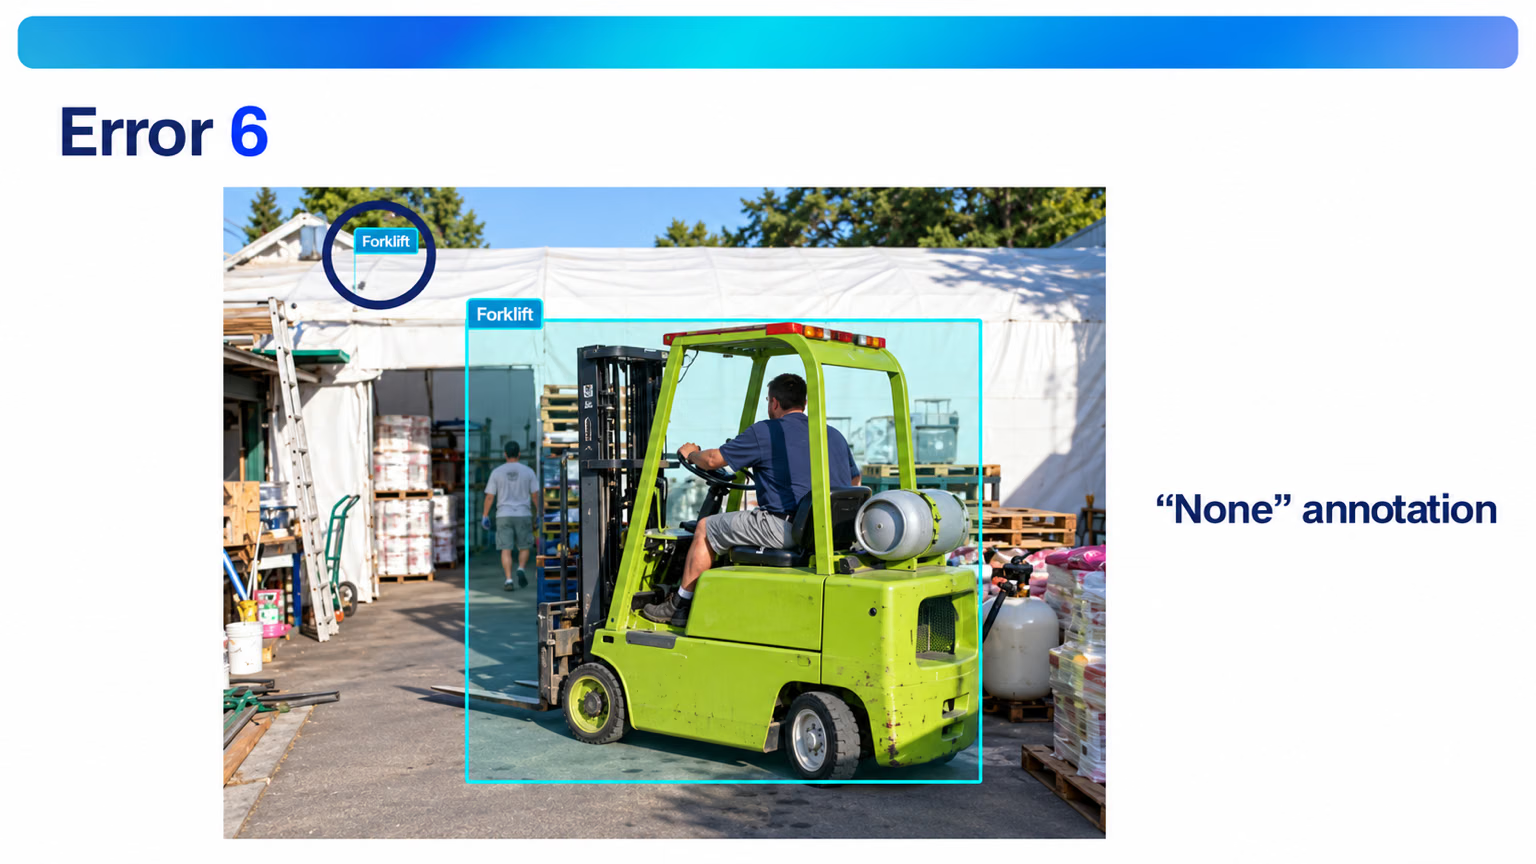
6. 空のアノテーション、または余分なアノテーション。 すべてのアノテーションには、実在するオブジェクトと正しいクラスが必要です。余計なクリックをすると、ここの隅にあるような、ほぼ空のボックスが残ります。また、クラスなしで保存されたボックスは、None またはクラス0としてエクスポートされることがあります。修正するか、削除してください。
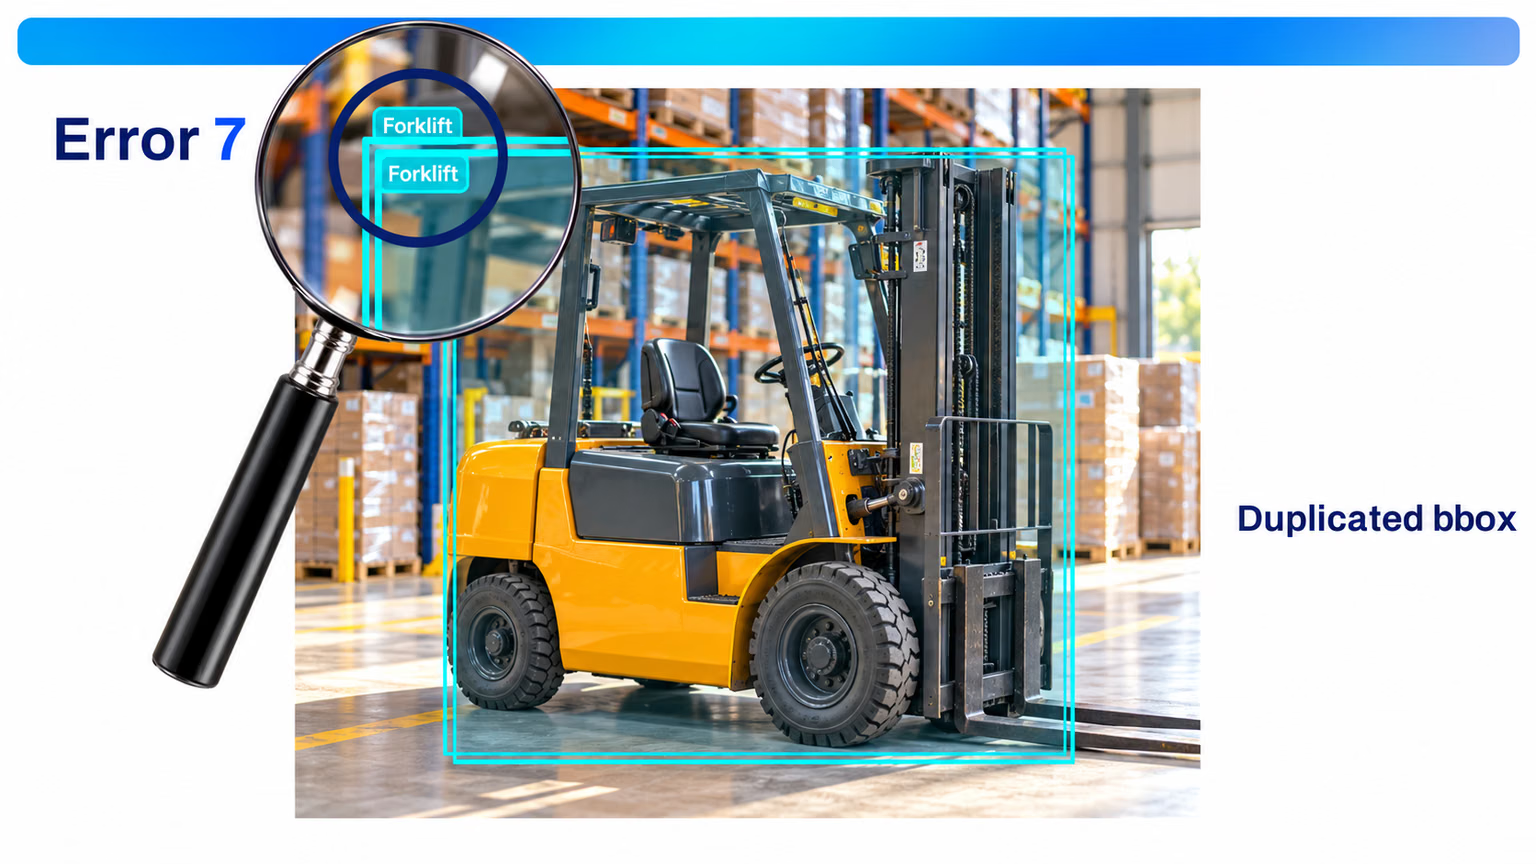
7. ボックスの重複。 1つのオブジェクトにボックスは1つです。同じフォークリフトに重なったボックスが2つあると、インスタンス数が水増しされ、モデルが重複を予測するように学習されます。
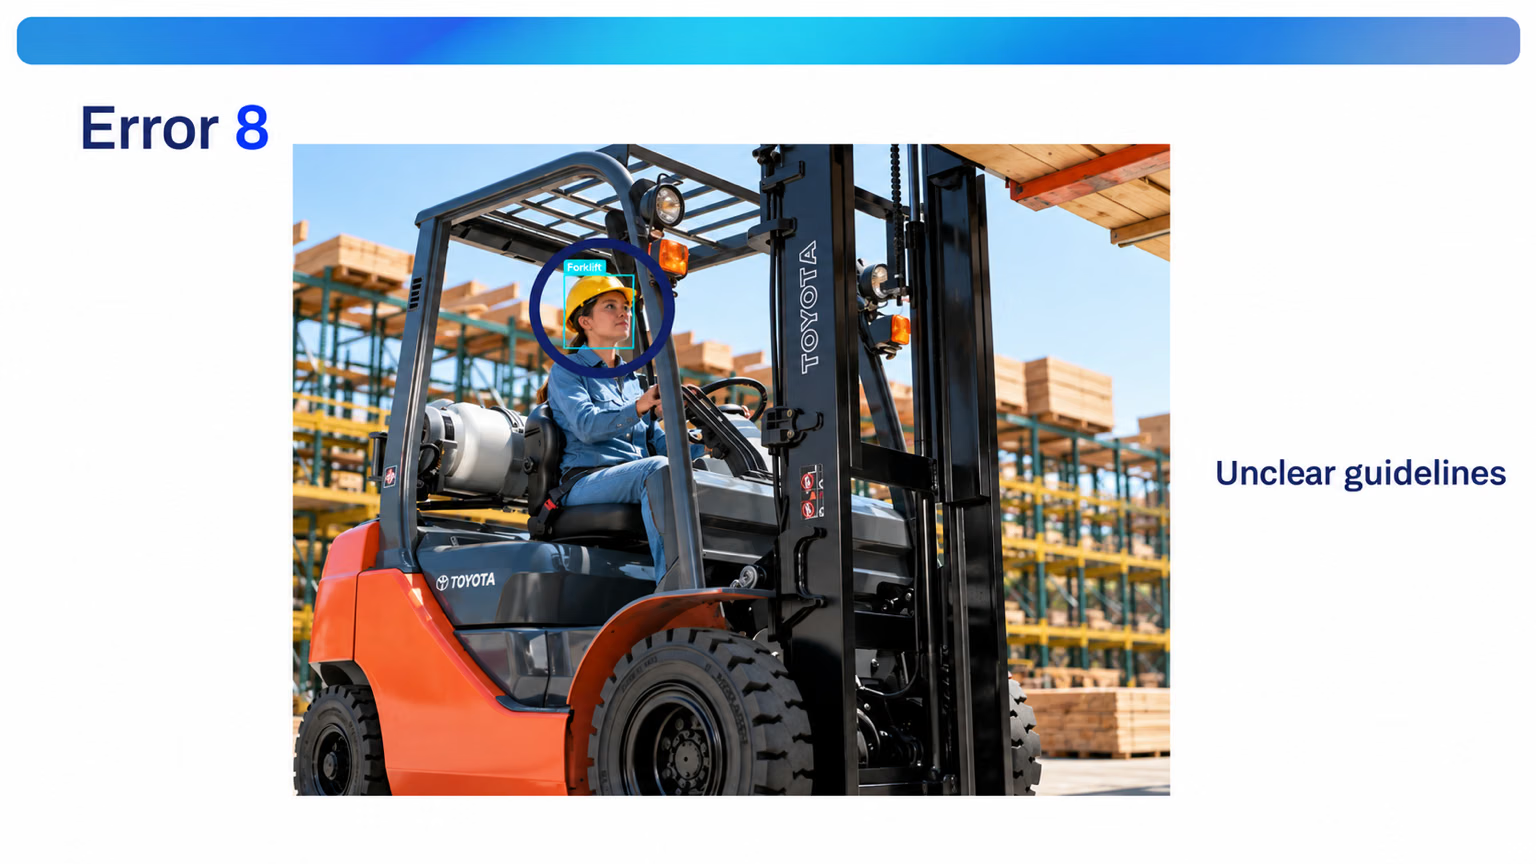
8. ガイドラインが不明確。 文書化されたルールがないと、アノテーターは独自に判断します。ここでは、あるアノテーターが運転手の頭だけを囲み、forklift クラスを付けています。運転手はフォークリフトの一部ですか、それとも別の person ですか?ガイドに一度明記して、答えを定めてください。
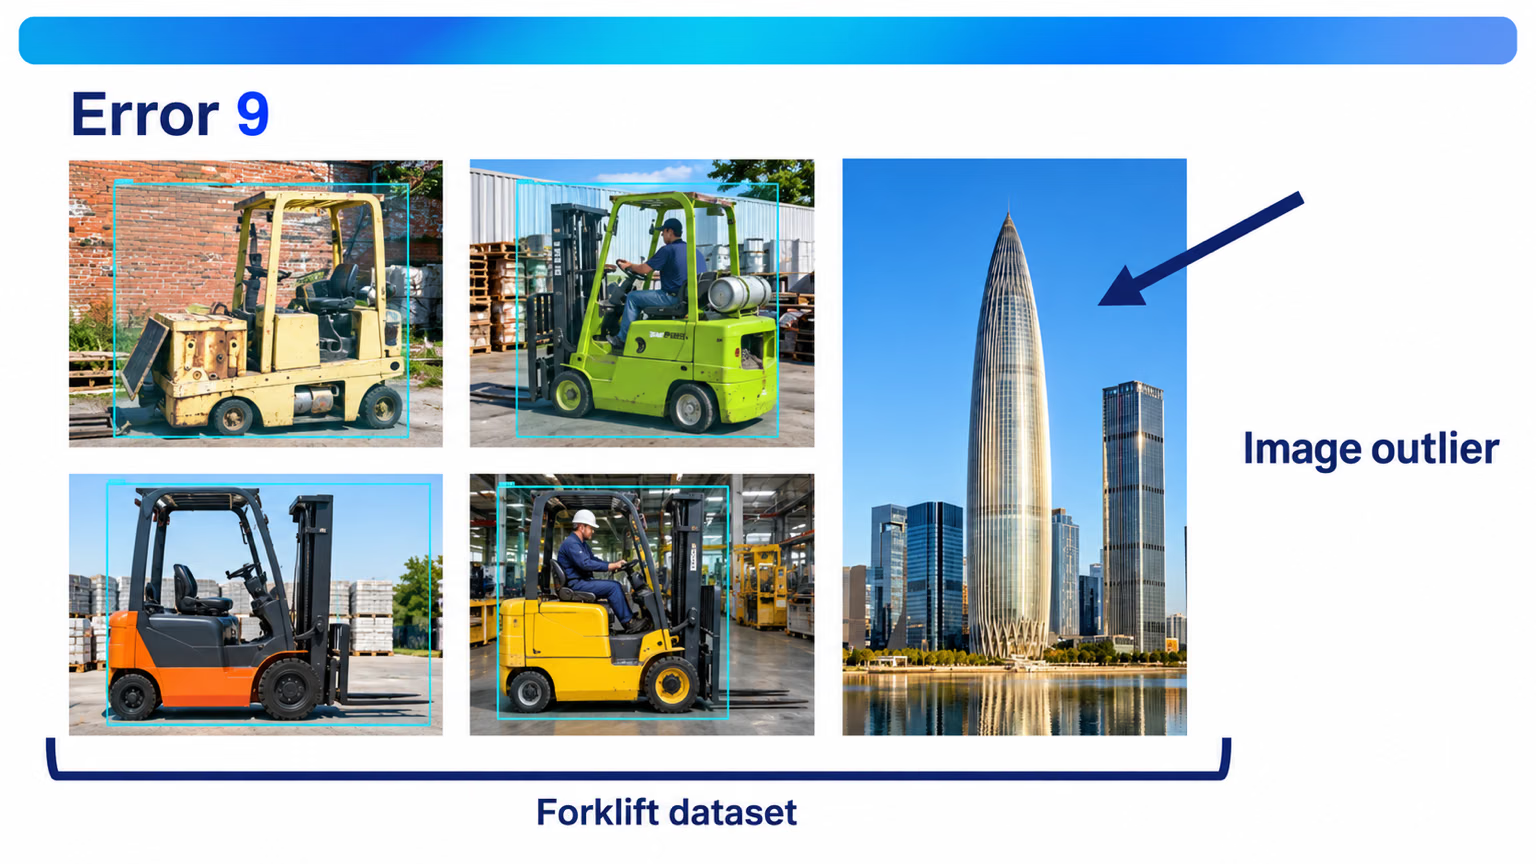
9. 外れ値画像。 デプロイ環境に合わない画像は除外してください。フォークリフトのデータセットに都市のスカイラインの写真を入れても役に立つ学習にはならず、ほかのすべての画像の価値を薄めてしまいます。
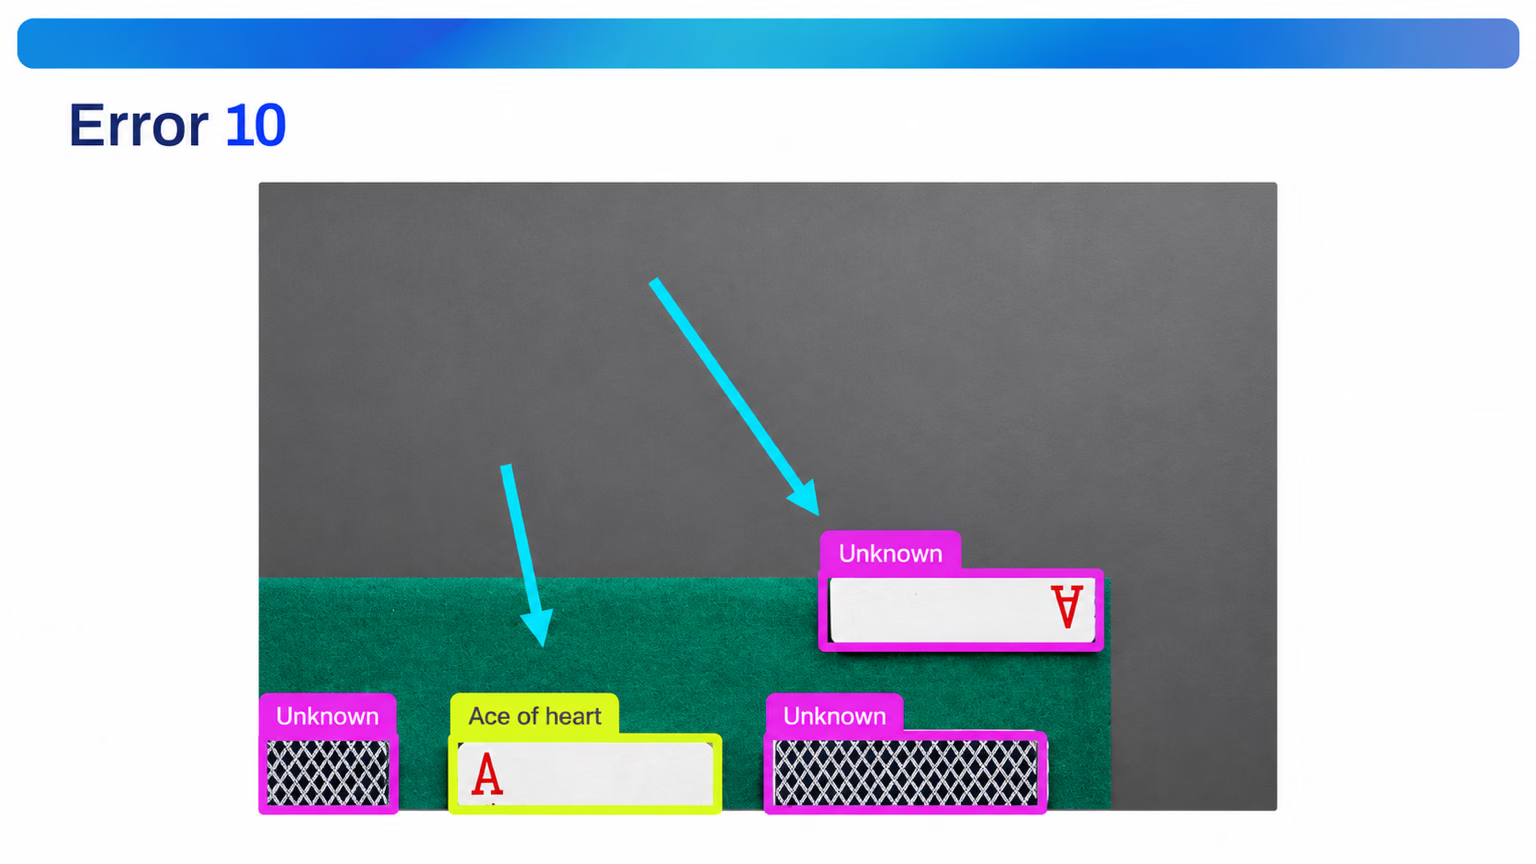
10. データ拡張による曖昧さ。 クロップによってクラスを定義する特徴が失われると、2つのクラスが同じに見えてしまいます。ハートのエースの隅のマークを切り取ると、unknown とラベル付けされたカードに見えます。修正方法については、データ拡張は慎重にをご覧ください。
推測せずに一致度を測定する#
キャリブレーションでは、2人のアノテーターに同じ画像を渡し、オブジェクトごとにラベルを比較します。クラスが同じで、IoUが0.5以上なら、2つのラベルは一致しています。このスクリプトは、COCO8のval画像でスコアを計算します。2人目がいなくても実行できるよう、事前学習済みモデルをアノテーターBとして使います。実際のチームで実施する場合は、Bのボックスをその人のラベルファイルから読み込んでください。
from pathlib import Path

import torch

from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset, img2label_paths
from ultralytics.utils.metrics import box_iou
from ultralytics.utils.ops import xywh2xyxy

data = check_det_dataset("coco8.yaml")
model = YOLO("yolo26n.pt")  # stands in for a second annotator; compare two label folders the same way
names = data["names"]

matched = total = 0
for image in sorted(Path(data["val"]).glob("*.jpg")):
    rows = [r.split() for r in Path(img2label_paths([str(image)])[0]).read_text().splitlines() if r.strip()]
    a_cls = torch.tensor([int(r[0]) for r in rows])  # annotator A: the dataset labels
    a_box = xywh2xyxy(torch.tensor([[float(v) for v in r[1:]] for r in rows]))
    b = model(image, conf=0.5, verbose=False)[0].boxes  # annotator B: confident model proposals
    iou = box_iou(a_box, b.xyxyn)
    used = set()
    for i in range(len(rows)):  # pair each A object with the best unused same-class B box at IoU >= 0.5
        ok = [j for j in range(len(b)) if j not in used and b.cls[j] == a_cls[i] and iou[i, j] >= 0.5]
        if ok:
            used.add(max(ok, key=lambda j: iou[i, j]))
        else:
            print(f"{image.name}: {names[int(a_cls[i])]} labeled by A only")
    for j in set(range(len(b))) - used:
        print(f"{image.name}: {names[int(b.cls[j])]} labeled by B only")
    matched += len(used)
    total += len(rows) + len(b) - len(used)

print(f"agreement: {matched}/{total} objects = {matched / total:.0%}")
000000000049.jpg: person labeled by A only
000000000049.jpg: person labeled by A only
000000000049.jpg: potted plant labeled by A only
000000000049.jpg: person labeled by A only
000000000049.jpg: person labeled by A only
000000000049.jpg: person labeled by A only
000000000061.jpg: person labeled by A only
000000000061.jpg: elephant labeled by A only
000000000061.jpg: person labeled by A only
agreement: 8/17 objects = 47%結果の読み方:
- スコアは、一致したオブジェクト数を、どちらかのアノテーターが描いたすべてのオブジェクト数で割った値です。この例では17個中8個です。
- 不一致は集中しています。 9件すべてが2枚の画像にあり、その大半はフレームの1%にも満たない大きさの人物です。これは無関係な誤りが9件あるのではなく、ルールが1つ不足しているということです。遠くにいる人物にもラベルを付けるのか?
- 解決策はガイドへの記載です。 たとえば、「640ピクセルの画像で高さが10ピクセル以上の人物すべてにラベルを付ける」と記載します。2人のアノテーターがその2枚の画像を再ラベル付けし、スコアを再測定します。
判断基準は、一致度が90%に達した場合にのみ、ラベリングを拡大することです。 それを下回る状態では、アノテーターを増やすたびに不一致が増えていきます。
スマートアノテーションで作業を加速する#
スマートアノテーションでは、YOLOモデルやSAMがラベル候補を提案し、人が承認または修正することで、作業量を数倍に増やせます。段階的に開始します。レビュー済みのバッチで学習し、そのモデルで次のバッチのラベルを提案して、レビュー後に再学習します。これがアクティブラーニングのループです。スマートアノテーションとバッチラベリングでは、Ultralytics Platformでの手順を説明しています。
小さな人物を見落とすモデルは、小さな人物のボックスを提案しません。レビュアーが「すべて承認」をクリックしても、そうした人物は追加されません。そのラベルで学習した次のモデルは、さらに自信を持って見落とすようになります。すべての画像をレビューし、モデルが描画したものを修正するだけでなく、モデルが見落としたものも追加します。
目視で確認する#
Ultralyticsのトレーニング実行では、毎回 labels.jpg と train_batch*.jpg が実行フォルダーに書き込まれます。前者はクラス数とボックスの位置・サイズをプロットし、後者はラベルを重ねた実際のトレーニング画像を表示します。最初のエポックが終わる前に開いて確認してください。メトリクスでは決して分からないことも、目視なら見つけられます。影を囲んだボックス、入れ替わったクラスID、閉じていないポリゴンなどです。
解答を表示
COCO8での不一致は、次のようなガイドの記載に結び付きます。
| 不一致 | ガイドに追加したルール |
|---|---|
000000000049.jpg 内の遠くにいる人物にAだけがラベル付け | 640ピクセルの画像で高さが10ピクセル以上の人物すべてにラベルを付け、それより小さい人物はすべての画像で対象外にします。 |
| 画像の端にある鉢植えにAだけがラベル付け | 画像の端で切れているオブジェクトでも、半分以上が見えていればラベルを付けます。 |
000000000061.jpg 内で別のゾウに一部隠れているゾウ | 頭部または胴体の半分が見えている場合は、オクルージョンされた動物にもラベルを付けます。見えている部分だけを囲みます。 |
人とモデルではなく2人のアノテーターを比較するには、スクリプトがAの行を読み取るのと同じ方法で、2つ目のラベルフォルダーからアノテーターBの行を読み込んでください(Path("labels_b", image.stem + ".txt"))。同じ2行を使って b_cls と b_box を作成し、スクリプトが b.cls と b.xyxyn を読み取る箇所でそれらを使用します。再ラベル付け後に再実行し、スコアが90%を超えたらそのラウンドは完了です。