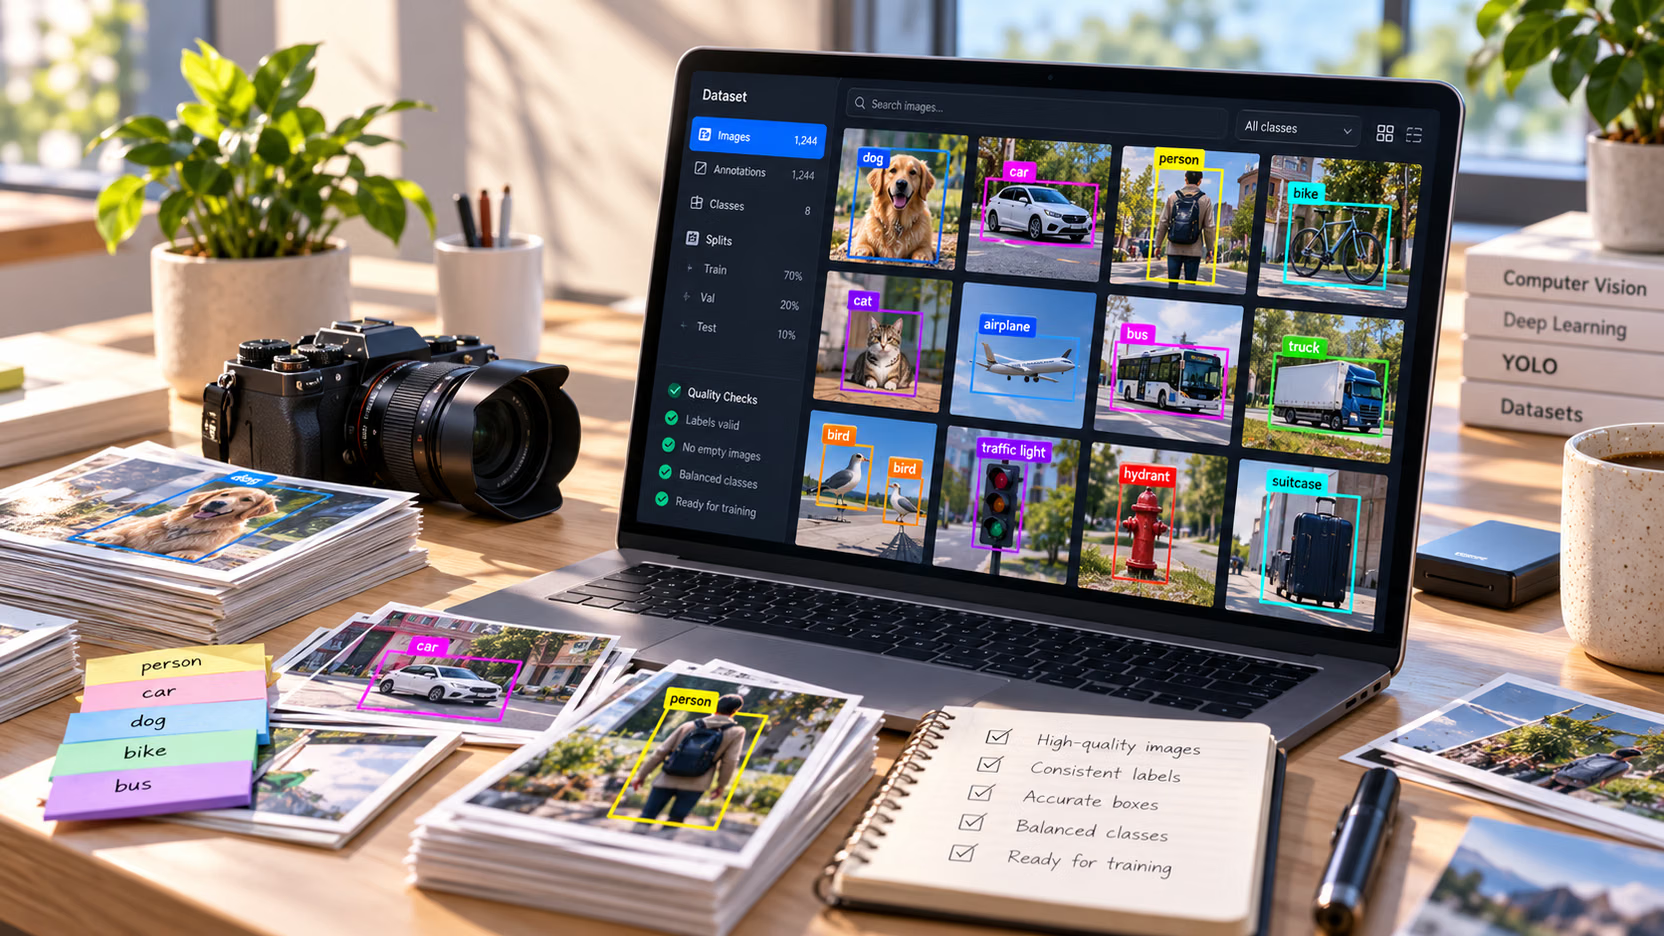
高性能YOLOデータセットの構築
トレーニング前の作業を実践的に解説するガイドです。ビジネス目標を受け入れテストに落とし込み、代表性のあるデータを仕様化して収集し、一貫したラベル付けを行い、スクリプトで品質を監査し、データリークのない分割を行い、データ拡張を調整します。また、準備状況のチェックを通じて、Ultralytics YOLO26の最初のファインチューニングを実施するか判断します。
作成者 Ultralytics Academy
ビジネス目標を、Ultralytics YOLO26のファインチューニングにすぐ使える、文書化済みでバランスが取れ、データリークのないデータセットに落とし込み、準備が整っていない場合に何を修正すべきかを正確に把握します。
ビジネス目標をビジョンタスク、定義済みクラス、コードとして実行できる受け入れテストに落とし込みます。
シナリオ別の割り当てを含むデータセット仕様を作成し、Ultralyticsの目標に合わせて規模を設定します。クラスごとに画像1,500枚以上、ラベル付けされたインスタンス10,000個以上、背景画像は0~10%です。
実際の導入環境でデータを収集し、撮影メタデータをファイル名に保持します。また、データセットを過剰に増やさずに動画からサンプリングします。
文書化されたガイド、測定可能なキャリブレーションラウンド、よくあるアノテーションミス上位10項目を踏まえて、一貫性のあるラベル付けを行います。
短いPythonスクリプトを使って、ラベル、クラスバランス、重複、ラベル漏れの可能性を監査します。
グループ(クリップ、カメラ、日付、場所)単位で分割し、検証スコアが本番環境を反映するようにして、テストセットを固定します。
導入環境に合ったデータ拡張設定を選び、トレーニングバッチで確認します。
8項目の準備状況チェックでトレーニングの実施可否を判断し、ベースラインのファインチューニング結果を次のデータセット修正につなげます。
1ページの目標と、PASSまたはFAILを出力する受け入れテストスクリプト。
シナリオ別の割り当て、エッジケース、背景画像の割合を含むデータセット仕様。
すべてのファイル名に撮影メタデータを含めた練習用データセットと、割り当てに対するカバレッジレポート。
一致率を測定したキャリブレーションラウンドで改善したラベリングガイド。
簡潔なQCメモを添えたQC監査と疑わしいラベルのレビュー。
分割間でクリップ、カメラ、日付を共有しない、グループ化されたtrain / val / testのファイルリスト。
スコア付きの準備状況チェック、クラス別に順位付けした最初のファインチューニング、再利用可能なキックオフチェックリスト。
機械学習の経験は不要です。各概念は使用する前にすべて説明します。
スクリプトの実行にはPython 3.10以降と
pip install ultralyticsが必要です。すべての例はCPUで実行できます。おすすめ:基本用語を学べるComputer Vision Foundations。
コース内容
5個のモジュール · 10件のレッスンモジュール 1
モジュール 3
モジュール 4