ビジネス目標から始める
画像を1枚も収集する前に、ビジネス目標をビジョンタスク、定義済みクラス、コードとして実行できる受け入れテストに落とし込みます。
倉庫チームが1か月間あらゆるものを撮影した後、安全責任者が関心を持っているのは、走行中のフォークリフト付近にいる人だけだと判明し、ラベルの半分をやり直すことになります。最初の撮影前に合意した1ページの目標があれば、こうした事態を防げます。作成には半日かかりますが、このコースで後から行うすべての選択、つまり収集対象、ラベル付け対象、モデルを出荷可能と判断する基準が決まります。
実践的
1ページの目標#

後続のすべてのステップの前提となる問いに、5つの行で答えます。プロジェクト目標の定義のガイドでは、同じ内容をより詳しく解説しています。以下は、このコースで使用する倉庫の記入例です。
| 項目 | 答える質問 | 倉庫の例 |
|---|---|---|
| ビジネス目標 | ビジネスにどのような変化をもたらし、いつまでに達成しますか? | 6か月以内に、搬入口でのニアミス事故を30%削減します。 |
| ビジョンタスク | モデルは何を出力しますか? | 物体検出:フォークリフトと人を囲むボックス。 |
| クラス | 何にラベルを付けますか? | forklift、person、pallet。それ以外はすべて背景です。 |
| 受け入れテスト | 何をもって「出荷可能」と判断しますか? | トレーニングで使用していないカメラの500フレームで、personの適合率が0.85以上の場合、再現率は0.95以上。 |
| 対象範囲外 | v1で対応しないことは何ですか? | 真っ暗な搬入口、ラックの陰に完全に隠れた人、手動式パレットジャッキ。 |
チーム全員が確認できる場所にこのページを掲示します。後から関係者が項目に異議を唱えた場合は、データセットより先にページを変更します。
問いに答えられる最もシンプルなタスクを選ぶ#
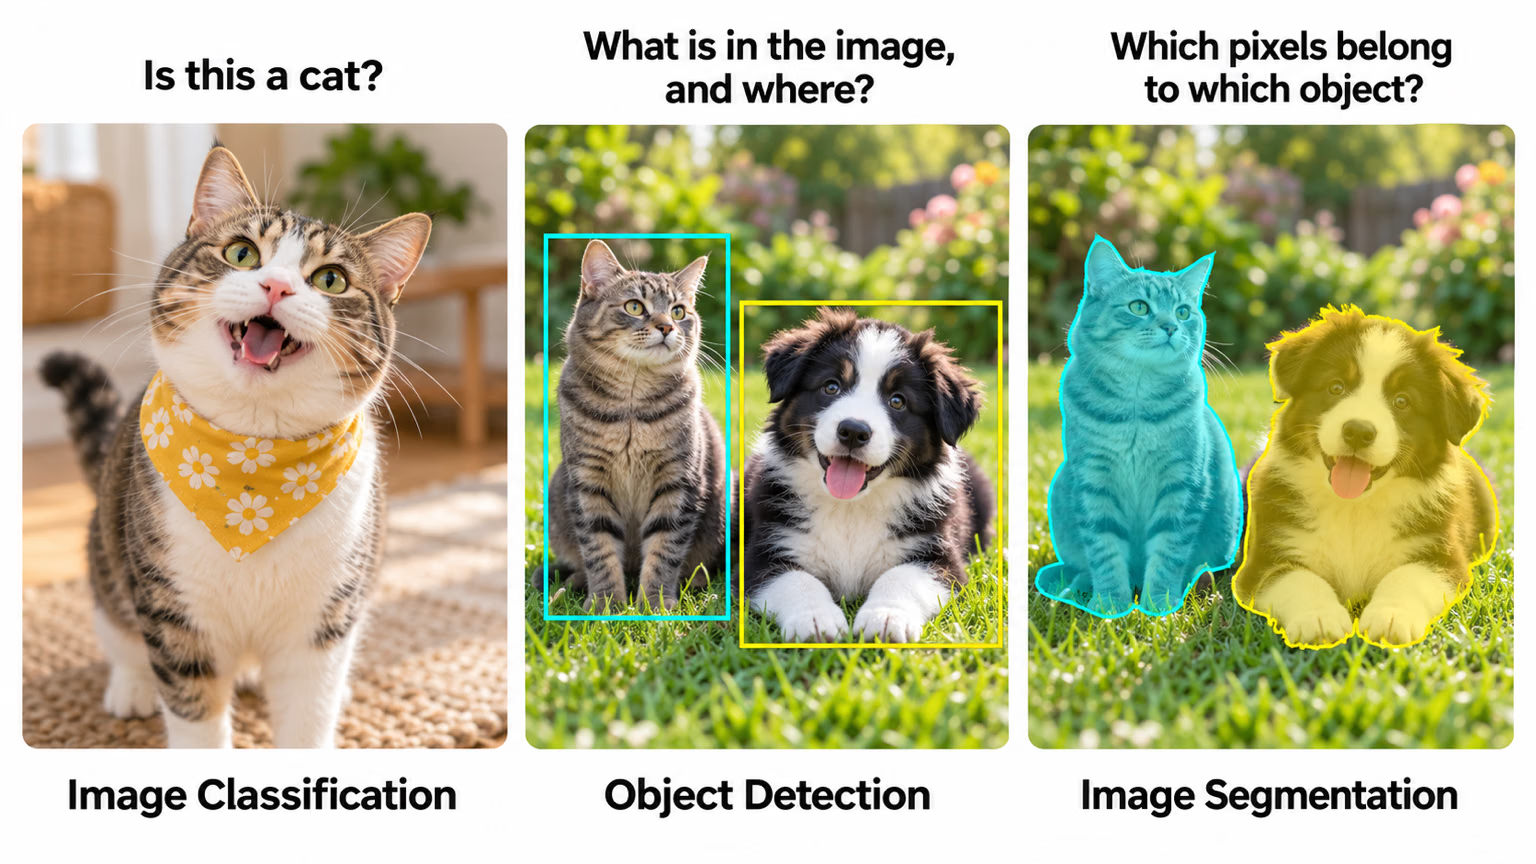
タスクによってアノテーターが描くものが決まり、それがラベリング予算の大部分を左右します。この判断ツリーを順にたどり、ビジネス上の問いに答えられる最初のタスクで止めます。
Ultralytics YOLOは7つのタスクに対応しています。データセットの計画で重要なのは、それぞれのラベル付けにどれほどのコストがかかるかです。Computer Vision Foundationsでは、ビジョンタスクのレッスンで各タスクを詳しく比較しています。
| タスク | アノテーターが作成するもの | ラベリングの工数 | 選択する状況 |
|---|---|---|---|
| 分類 | 画像ごとに1つのラベル | 最小 | 画像ごとに1つの回答で十分な場合 |
| 検出 | 物体ごとにクラスと軸に平行なボックス | 低 | 物体を数える、または位置を特定する必要がある場合 |
| OBB | 物体ごとにクラスと回転ボックス | 中 | 物体が細長い場合、または上から見た場合 |
| 姿勢 | 物体ごとにクラスと名前付きキーポイント | 高 | 関節または部位の位置が重要です |
| インスタンスセグメンテーション | オブジェクトごとにクラスとポリゴン | 高 | 各オブジェクトの輪郭が重要です |
| セマンティックセグメンテーション | すべてのピクセルにクラスを割り当てます | 最高 | 数えられるオブジェクトではなく、領域が必要です |
| 深度推定 | 何も描画しません。通常は深度センサーから取得した、画像ごとの深度マップです | 撮影ハードウェアによって異なります | すべてのピクセルの距離が必要です |
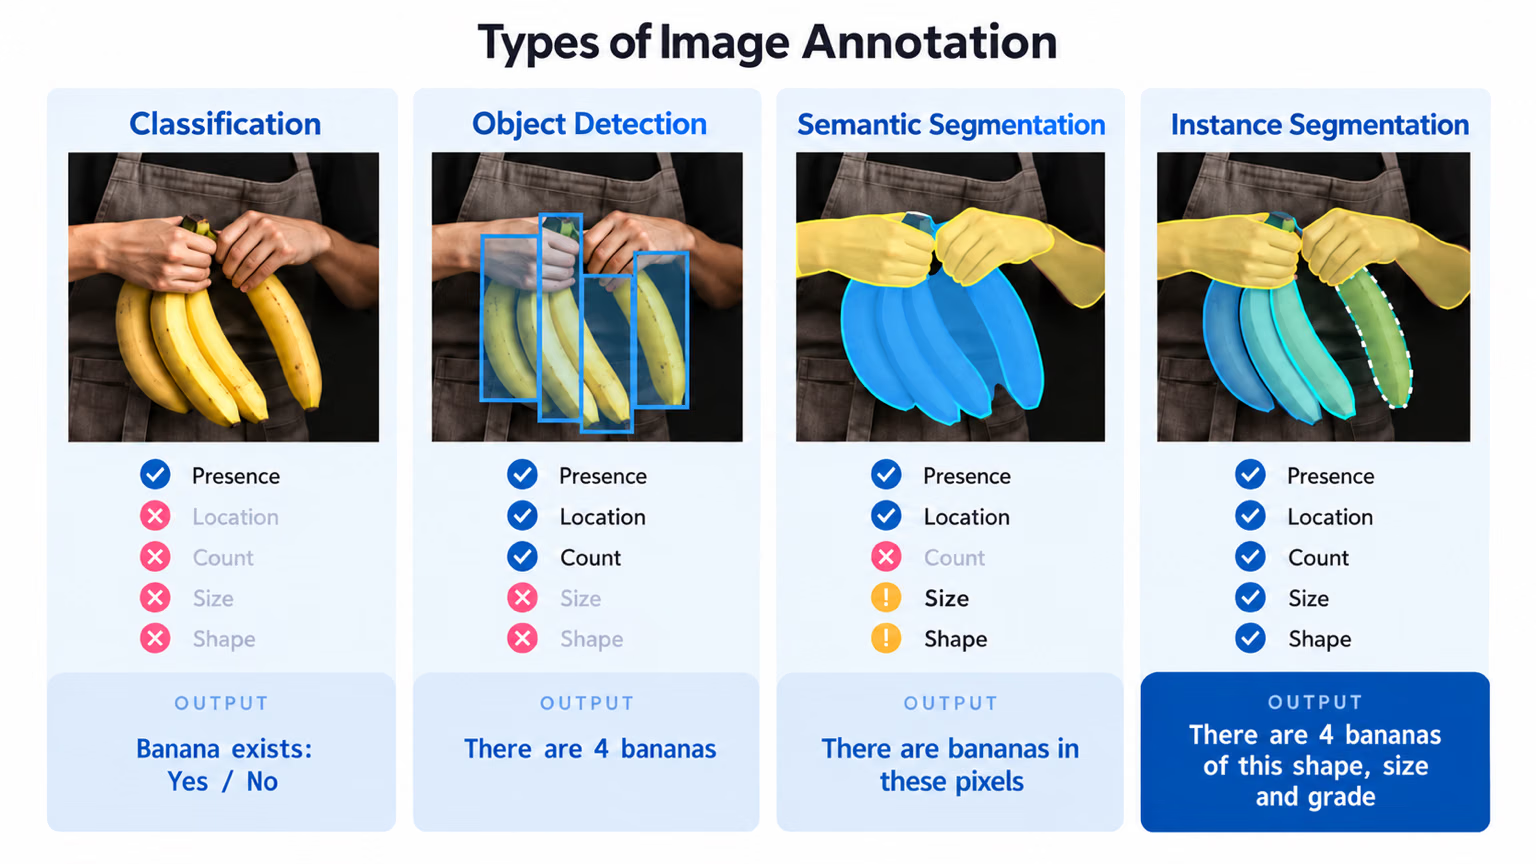
バナナの図を価格表のように見てください。検出だけで存在、位置、個数がわかり、大きさと形状が加わるのは2つのセグメンテーションの図だけですが、アノテーションコストは大幅に高くなります。ビジネス上の要件が「バナナはいくつあるか」だけなら、検出で十分です。ポリゴンは予算の無駄になります。
チームは、より精密に見えるという理由でセグメンテーションを選びがちですが、夜勤、雨、2つ目の拠点を網羅する前にラベル付け予算が尽きてしまいます。ポリゴンは、物体1つあたりボックスの数倍のコストがかかります。面積の測定やマスクによる切り抜きなど、目的の項目で輪郭自体が必要な場合に限ってセグメンテーションを選択します。
アノテーターが適用できるクラスを定義します#
2人のアノテーターが同じオブジェクトに同じラベルを付けられる場合に限り、そのクラスは有用です。各クラスについて、紛らわしい対象のうち何を含めないかを明記した一文の定義を書きます。
forklift:フォークとマストを含む動力式フォークリフトです。ハンドパレットトラックは含みません。person:一部が見えている人、座っている人、車両の運転席内にいる人を含む、あらゆる人です。反射像とポスターは含みません。pallet:積載状態や空の状態を問わない、木製またはプラスチック製の輸送用パレットです。パレットの土台がない積み重ねたコンテナは含みません。
次に、粒度を意図的に選びます。「車両」のような粗いクラスはコストが低く、収束も速くなります。「セダン」「ピックアップ」のような細かいクラスは後工程で役立ちますが、一貫性を保つのが難しくなります。まずはビジネス上の要件に合わせてください。細かいラベルは後から1行のコードで粗いクラスに統合できますが、粗いラベルを分割するには再ラベリングが必要です。
「危険そうに見えるものすべて」や「通路をふさいでいるもの」はクラスではありません。アノテーターごとの判断に委ねることになり、ばらつきのある判断で学習したモデルは、そのばらつきを学んでしまいます。定義だけを見て新しいアノテーターが適用できるよう、曖昧なクラスを書き直すか、検出後に適用するルールに変えます(たとえば、「通路のポリゴン内にあるpalletすべて」)。
指標を実行可能な受け入れテストに変えます#
ミスのコストに合った指標を選びます。
- 見逃しのコストが高い(安全、欠陥):そのクラスの再現率を合格基準にします。
- 誤検知のコストが高い(部品の自動却下、スタッフへの通知):適合率を合格基準にします。
- すべてのクラスを同等に重視する(カウント、在庫管理):クラスごとのAPを合格基準にし、平均値の陰に隠れるクラスがないようにします。
YOLOの性能指標ガイドでは、各指標を解説しています。次に、「十分な性能か」という問いが議論にならないよう、テストをコードで記述します。このスクリプトは、事前学習済みモデルを使ってCOCO8のデモデータセットで今すぐ実行でき、後で独自のチェックポイントとホールドアウトデータにも使えます。
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # later: your fine-tuned runs/detect/train/weights/best.pt
metrics = model.val(data="coco8.yaml", classes=[0], verbose=False)  # 0 = person; later: your holdout YAML

precision, recall = metrics.box.mp, metrics.box.mr
print(f"person: precision={precision:.2f} recall={recall:.2f}")
print("PASS" if recall >= 0.95 and precision >= 0.85 else "FAIL: below the acceptance test")
all 4 10 0.939 0.8 0.848 0.387
person: precision=0.94 recall=0.80
FAIL: below the acceptance test各行でわかること:
classes=[0]はpersonだけを評価するため、ほかのクラスの結果でスコアが底上げされることはありません。安全性に関わる独自のクラスIDを使用してください。- 検証結果の行には、4枚の画像とラベル付けされた10人が表示されます。
mpとmrは、適合率と再現率のバランスが最もよい信頼度しきい値(F1最大値)での適合率と再現率です。 - COCOで事前学習したモデルは10人中8人を検出するため、再現率は0.80です。適合率は高いものの、安全性の要件を満たすには不十分です。このFAILこそがテストの役割です。このコースでは、FAILになった場合はハイパーパラメーターではなくデータを見直します。
学習時と同じカメラや日付から抽出したテストは、実用性ではなく記憶を測定します。目的の中でホールドアウト条件を明記し(「学習に使っていないカメラ」「直近2週間の映像」など)、データセットを正しく分割するに従って構築します。
v1で対応しないことを書き出します#
完璧なモデルはないため、許容できる見逃しをあらかじめ明確にします。保証しない条件(濃霧、完全な暗闇)、混同しても許容する類似対象、v2まで対応を見送るロングテールクラスを挙げてください。この行があれば、目標を達成したモデルが明文化されていない100%基準で評価されるのを防げます。また、現時点で収集チームが労力をかける必要のない対象も明確になります。
解答を表示
別のプロジェクト、つまり食料品チェーンが棚の空きスペースを検出する場合の目標例:
| 項目 | 回答 |
|---|---|
| ビジネス目標 | 四半期以内に、売上上位200商品の欠品時間を25%削減します。 |
| ビジョンタスク | 検出です。店舗が必要としているのは各空きスペースの位置であり輪郭ではないため、ポリゴンよりバウンディングボックスが適しています。 |
| クラス | gap:商品の幅以上の空の棚スペースです。買い物客やカートに隠れているスペースは含みません。price_tag:棚の縁に付けられたラベルです。販促用ステッカーは含みません。 |
| 受け入れテスト | 学習に使用していない5店舗の400枚の画像で、gapの再現率が0.90以上、適合率が0.80以上。 |
| 対象範囲外 | 反射のある冷凍庫の扉、エンド陳列、青果売り場。 |
空きスペースの見逃しは販売機会の損失につながる一方、誤検知によるコストはスタッフの短い移動時間だけなので、まず再現率を重視します。acceptance_test.pyで変更するのは3か所だけです。data="holdout_stores.yaml"(未使用の5店舗)、classes=[0](0がgapに変更)、しきい値のrecall >= 0.90 and precision >= 0.80です。