最初のファインチューニングと反復ループ
デフォルト設定で事前学習済みYOLO26の重みをファインチューニングし、APと見逃し数・混同数に基づいてクラスを順位付けして、最も弱いクラスを次のデータセット修正につなげます。
このレッスンの練習実行では0.66 mAP50となり、学習率の問題のように見えます。しかし、クラスごとの表を見ると別の原因が分かります。cupでは、valにラベル付きオブジェクトが14個あるのに、モデルは1つも検出していません。これはデータの問題であり、ハイパーパラメーターでは解決できません。最初の実行は、次にどのクラスを修正すべきかを示す診断として扱ってください。
実践的
事前学習済みの重みから開始する#
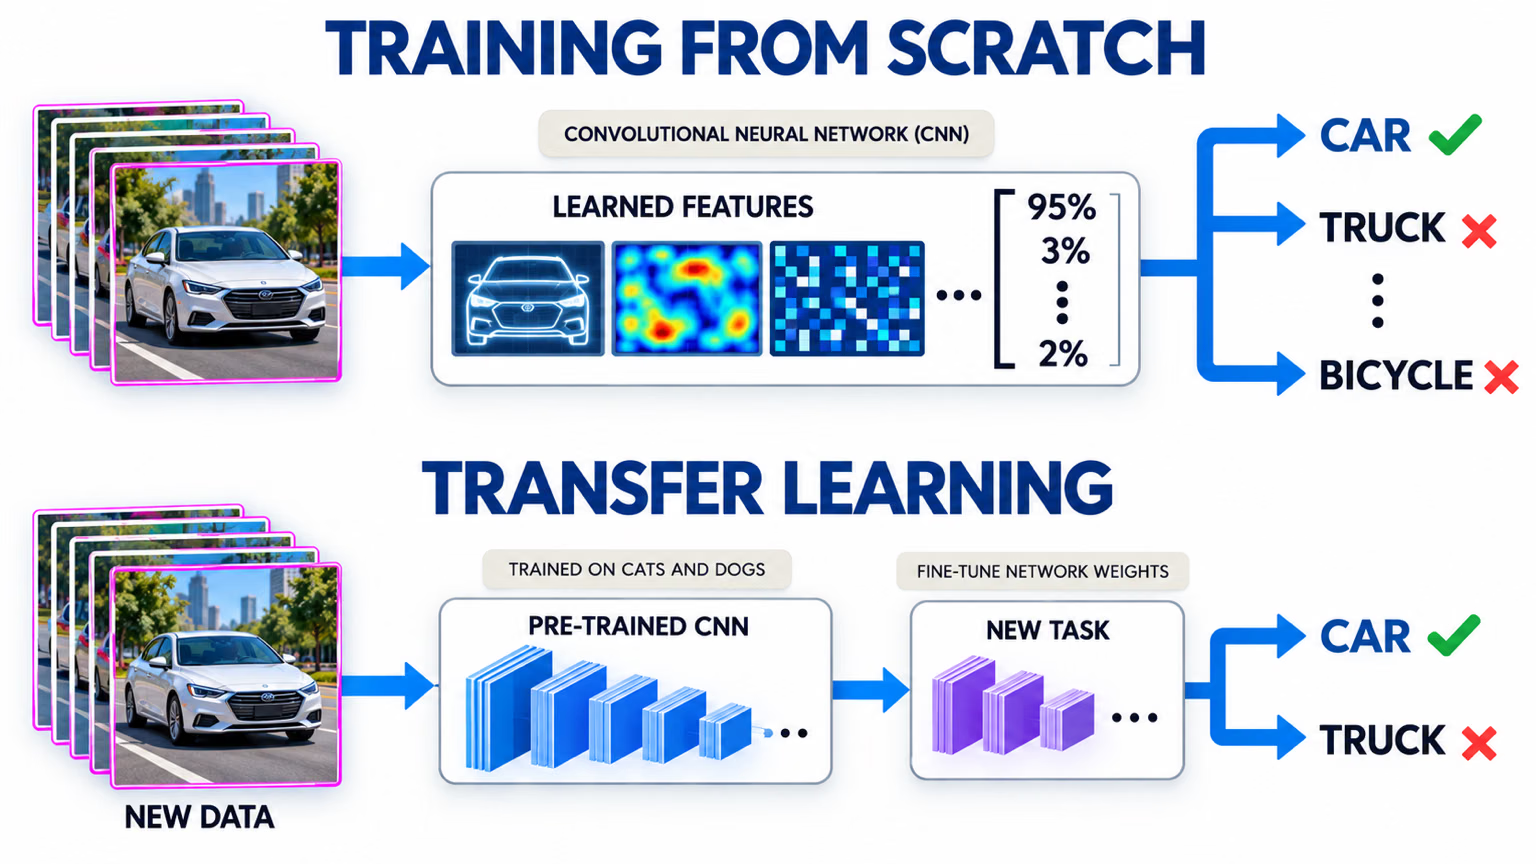
ファインチューニングでは、エッジ、テクスチャ、形状をすでに認識する重みから開始するため、ランダムな重みからのトレーニングよりも速く収束し、必要なデータも大幅に少なくなります。タスクに合ったYOLO26チェックポイントを選んでください。
| タスク | 事前学習済みチェックポイント | 事前学習に使用したデータ |
|---|---|---|
| 検出 | yolo26n.pt | COCO |
| セグメンテーション | yolo26n-seg.pt | COCO |
| セマンティック | yolo26n-sem.pt | Cityscapes |
| 姿勢 | yolo26n-pose.pt | COCOキーポイント |
| OBB | yolo26n-obb.pt | DOTAv1 |
| 分類 | yolo26n-cls.pt | ImageNet |
| 深度推定 | yolo26n-depth.pt | 屋内外の大規模な深度データの混合 |
バックボーンとネックはそのまま転用され、タスクヘッドはクラス数に合わせて一部が再初期化されます。スクラッチからのトレーニングが有効なのは、データセットが非常に大規模で、ドメインが極めて特殊な場合に限られます。まずはnano(n)モデルでベースラインをすばやく作成し、データ改善を続けても効果が得られなくなってから、大きなモデルに切り替えてください。ファインチューニングガイドでは、内部で何が起きるかを説明しています。
ベースラインを実行する#
デフォルト設定でトレーニングします。最初の実行の目的は記録を更新することではなく、ベースラインを得ることです。ここではデータセットを正しく分割するで作成した練習用セットの分割データを使い、まずデータYAMLを記述します。
from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset
from ultralytics.utils import YAML

names = check_det_dataset("coco128.yaml")["names"]  # # 練習用セットではCOCOのクラス名をそのまま使用します
YAML.save("practice.yaml", {"path": "datasets/practice", "train": "train.txt", "val": "val.txt", "test": "test.txt", "names": names})

model = YOLO("yolo26n.pt")  # # COCOで事前学習済みです。タスクに合ったチェックポイントを使用してください
model.train(data="practice.yaml", epochs=3, imgsz=320)  # # 実際の実行例:epochs=100、imgsz=640
Class Images Instances Box(P R mAP50 mAP50-95)
all 20 143 0.614 0.6 0.664 0.486実行フォルダー(runs/detect/train/)にweights/best.ptが保存されます。最初の実行で検討する価値がある引数は3つだけです。
| 引数 | デフォルト | 変更するタイミング |
|---|---|---|
epochs | 100 | ごく小規模なデータセットでは少なくし、非常に大規模なデータセットでは200~300にします |
imgsz | 640 | フレーム内に小さなオブジェクトが多い場合は1024または1280にします |
batch | 16 | 自動バッチサイズには-1を指定し、メモリ不足エラーが発生する場合は値を下げます |
最初のモデルをトレーニングするでは、トレーニングの呼び出し方法と実行中のログを詳しく説明しています。
クラスを順位付けし、見逃しを読み解く#
全体のmAPでは問題の箇所が分かりません。AP50-95に基づいてクラスを順位付けし、混同行列を使って、各クラスのエラーをモデルが完全に見逃したオブジェクトと、別のクラスとして判定したオブジェクトに分けます。
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")  # your fine-tuned checkpoint
metrics = model.val(data="practice.yaml", imgsz=320, verbose=False)  # same data YAML and imgsz as training

matrix = metrics.confusion_matrix.matrix  # rows: predicted class, columns: true class; last row = background
for ap, cls in sorted(zip(metrics.box.ap, metrics.box.ap_class_index))[:5]:  # weakest five classes first
    total, missed, correct = matrix[:, cls].sum(), matrix[-1, cls], matrix[cls, cls]
    print(f"{model.names[cls]:>8}  AP50-95={ap:.3f}  {total:2.0f} labeled: {correct:2.0f} found, "
          f"{missed:2.0f} missed, {total - correct - missed:2.0f} called another class")
car AP50-95=0.000 4 labeled: 0 found, 4 missed, 0 called another class
fork AP50-95=0.000 1 labeled: 0 found, 0 missed, 1 called another class
handbag AP50-95=0.025 1 labeled: 1 found, 0 missed, 0 called another class
cup AP50-95=0.039 14 labeled: 0 found, 10 missed, 4 called another class
sink AP50-95=0.075 1 labeled: 1 found, 0 missed, 0 called another classエラーの種類ごとに、必要なデータセット修正は異なります。
- valのインスタンスが少なすぎる(
fork、handbag、sinkは各1件):APはノイズにすぎません。valに各クラスのインスタンスが少なくとも数十件含まれるまでは、そのクラスに対して対処しないでください。まずvalのグループを追加収集します。 - 見逃し(
carは4件中4件、cupは14件中10件):モデルはオブジェクトをまったく検出できていません。そのシナリオがtrainで十分にカバーされているか確認し、suspect_labels.pyを使ってラベルの欠落を探します。 - 別のクラスとして判定(
cupは14件中4件):クラス定義が重複しています。該当画像を開き、定義を明確にし、ガイドに類似対象を記載します。
ここで対応すべき点はcupです。ラベル付きインスタンスが14件あるのに、1件も検出されていません。
実行フォルダーをデータのフィードバックとして読み解く#

各トレーニング実行で次のファイルが保存されます。Ultralytics Platformでは、クラウドトレーニング中に同じ曲線がリアルタイムでプロットされます。
| ファイル | データについて分かること |
|---|---|
confusion_matrix_normalized.png | どのクラス同士が混同されているか、または背景として見逃されているか |
BoxPR_curve.png | クラスごとの適合率・再現率。曲線が低いクラスは性能が弱いことを示します |
val_batch0_pred.jpg | 実際のval画像に対する予測。体系的な見逃しがないか確認します |
labels.jpg | モデルがトレーニングに使用したクラス数とバウンディングボックスのサイズ |
results.png | 損失と指標の曲線。train損失が下がる一方でval損失が上がる場合は、過学習を示しています |
検証と診断では各プロットを説明しています。ここで常に問うべきなのは、データに何が不足しているかです。
データ優先の反復ループ#
一般的な反復の流れ:valのインスタンスが十分にあるクラスのうち、最も弱いクラスを選び、そのクラスを含む約50枚の画像を監査してデータを修正します。同じ設定とデータ分割で再トレーニングし、クラスごとのAPを比較します。その後、次に弱いクラスに移ります。
画像を300枚追加し、同じ再学習でimgszも引き上げると、どちらの変更がスコアに影響したのか分かりません。データを反復改善する間は設定と分割を同じに保ち、比較のたびに1つのデータ変更だけを評価します。
ハイパーパラメーターを調整するタイミング#
データに関する反復を2~3回行い、残る弱いクラスの問題がカバレッジ、ラベル、定義に起因しなくなったら、調整によって最後の数ポイントを伸ばせる場合があります。ファインチューニングガイドでは、レイヤーの凍結、学習率、オプティマイザーの選択について説明しています。ただし、データが整う前に調整すると、誤ったデータセットを対象にモデルを最適化することに何週間も費やすことになります。
ロック済みテストセットでモデルがacceptance_test.pyに合格したら、Ultralytics YOLO in Productionでエクスポートとサービングを、Build with Ultralytics Platform内の健全性と精度を監視するおよび再トレーニングループを自動化するで再トレーニングループを扱います。
解答を表示
試行の結果、対応が必要なのは cup クラスです。検証データではラベル付き画像が14枚あり、検出できた画像は0枚、見逃した画像は10枚、別のクラスと判定した画像は4枚でした。規模を定めた計画は次のとおりです。
| 所見 | データセットに対するアクション | 規模 |
|---|---|---|
| 14枚中10枚のカップを見逃し | 学習データのカバレッジを確認します。撮影日・カメラごとにカップが写っている学習画像を数え、該当画像がないグループでカップを収集します。 | カップが写った新しい画像を40枚、4つの撮影日・カメラにわたって収集 |
| 14枚中4枚を別のクラスと判定 | val_batch0_pred.jpg と混同行列で該当画像を確認します。wine glass または bowl と判定されている場合は、類似する両方のクラスを cup の定義に追加します。 | 新しいルールに基づいて、学習画像を約30枚再ラベル付け |
| インスタンスが1つのクラス | まだ対応せず、該当クラスを含む検証グループを追加します。 | 次回の収集 |
その後、epochs、imgsz を使い、データ分割は変更せずに再学習します。rank_classes.py を再実行し、cup のAPを前後で比較します。値が上がればボトルネックはデータにあり、上がらなければハイパーパラメーターに手を加える前に、次の50枚を監査します。