ヘルスと精度を監視する
Platformのエンドポイントメトリクスと予測統計を確認し、スケジュールされたヘルスチェックでアラートを通知し、ホールドアウトジョブで精度のドリフトを検知します。
夜勤時に照明が暗くなったことで精度が5ポイント低下しても、エンドポイントはすべてのリクエストに200 OKを返すことがあります。Platformでは各エンドポイントの動作を確認できますが、誰かに通知する機能はなく、ラベルがなければ精度も把握できません。このレッスンでは、このギャップを埋める2つの定期チェックを作成し、夜勤をシミュレートして精度アラートを練習します。
実践的
Platformで確認できる情報#

| シグナル | 場所 | 保持期間 |
|---|---|---|
| HTTPリクエスト、エラー率(4xxと5xx)、P95レイテンシ | デプロイメントページとDeploymentsタブのカード。毎分更新 | カードでは過去24時間を確認できます。APIでは1時間から30日分を取得できます |
| ヘルス | Overviewタブの Endpoint カード | リアルタイム。ヘルス異常中は自動で再試行 |
| ログ | Logs タブ:直近20件、Errors フィルター | APIはページネーションに対応し、リクエストごとに最大200件を返します |
| 予測統計と一時的な例(最大100枚の画像) | Monitoring タブ | サービングインスタンスのメモリ上のみ |
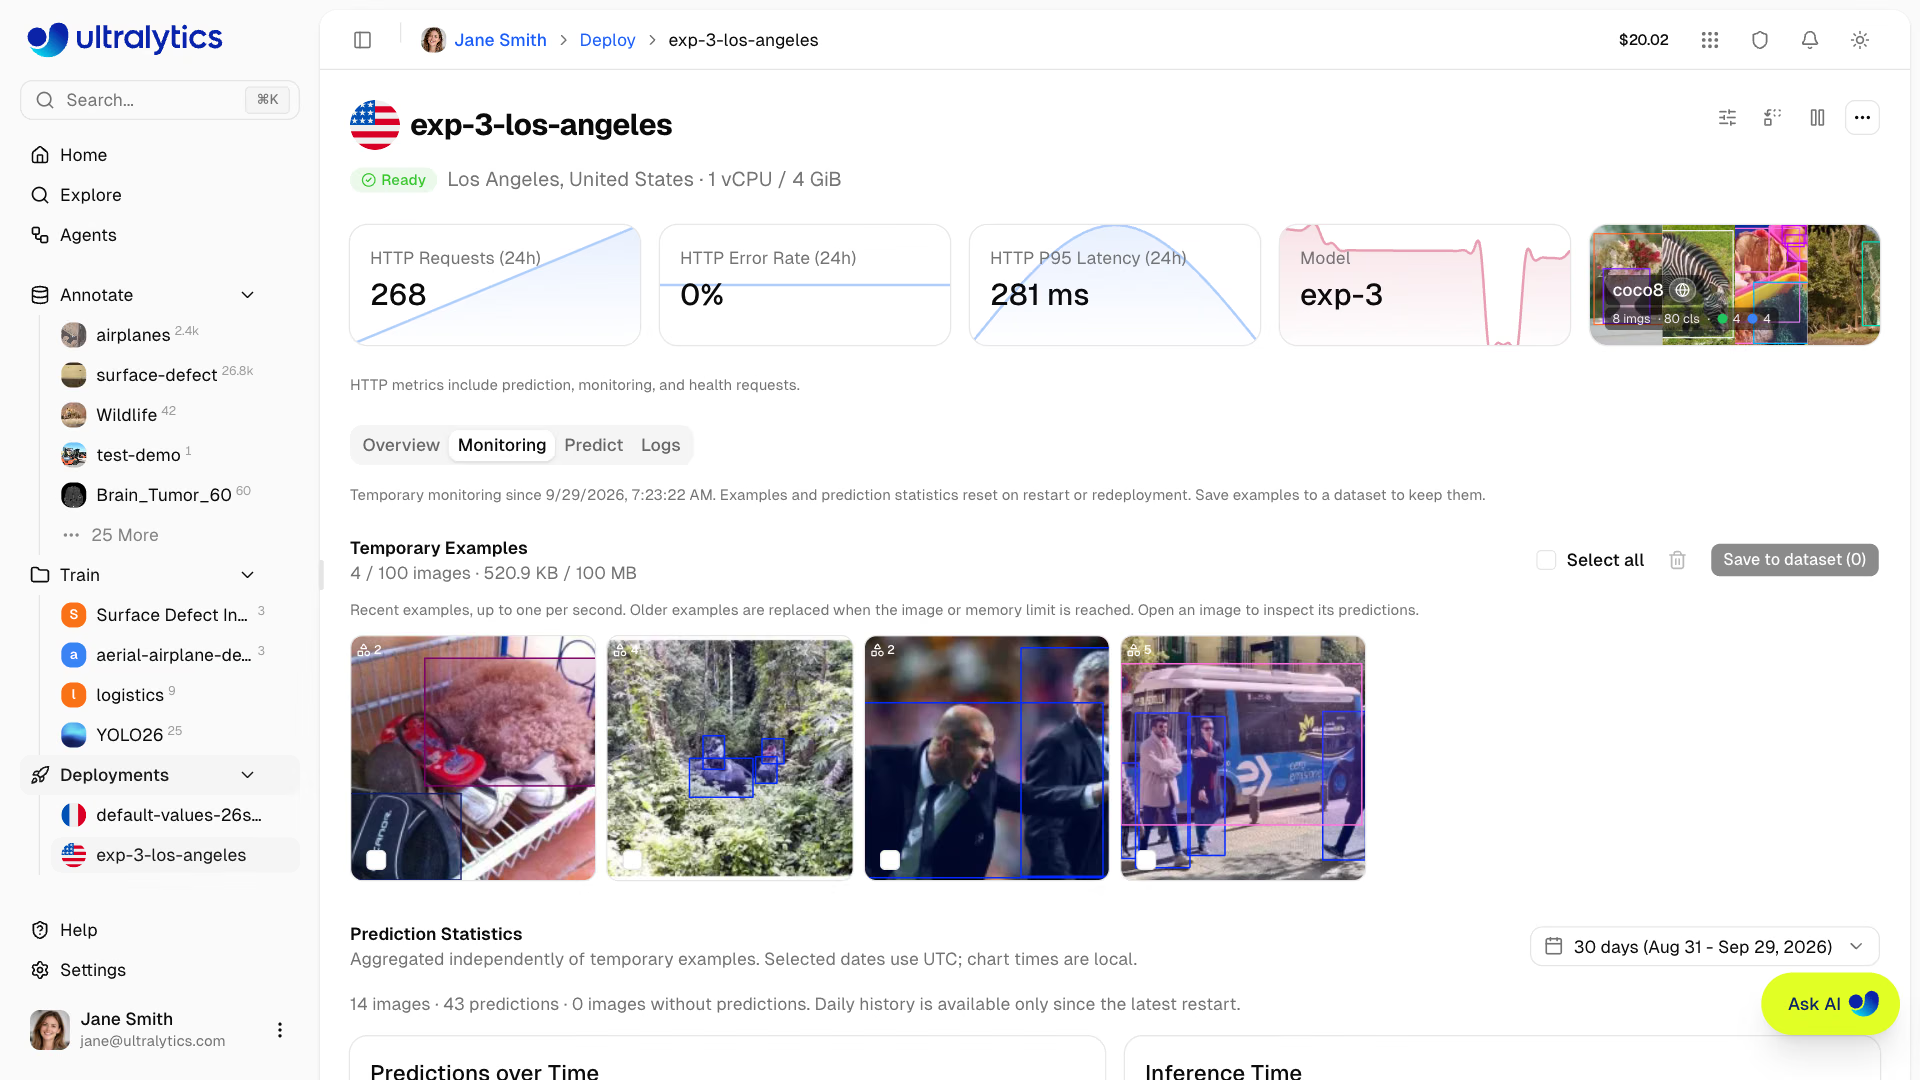
以降のすべてに影響する注意点が2つあります。メトリクスが収集されるのはエンドポイントが Ready の間だけで、デプロイメントを削除すると履歴にアクセスできなくなります。Monitoringタブの統計と例は、エンドポイントの停止、再起動、サイズ変更、モデルの置き換えのたびに失われます。これはライブビューであり、アーカイブではありません。
実例:定期エンドポイントチェック#
Platformではエラー率が5%を超えるとカードが赤くなり、デプロイメントの準備完了時や起動失敗時にはSlackで通知できますが、しきい値アラートはありません。このチェックをcron、CI、または監視エージェントから5分ごとに実行し、終了コードが0以外の場合にページャー通知を送ります。
from ultralytics_platform import Platform

OWNER, DEPLOYMENT = "your-username", "yolo26n-iowa"  # from the deployment page URL
P95_BUDGET_MS, MAX_ERROR_RATE = 300, 1.0  # errorRate is a percentage

with Platform() as client:  # reads ULTRALYTICS_API_KEY
    health = client.deployments.health(OWNER, DEPLOYMENT)
    summary = client.deployments.metrics(OWNER, DEPLOYMENT, range="1h", view="overview")["summary"]
    print(
        f"healthy={health['healthy']} requests={summary['totalRequests']} "
        f"p95={summary['p95LatencyMs']:.0f} ms errors={summary['errorRate']:.2f}%"
    )
    if not health["healthy"] or summary["p95LatencyMs"] > P95_BUDGET_MS or summary["errorRate"] > MAX_ERROR_RATE:
        for entry in client.deployments.logs(OWNER, DEPLOYMENT, severity="ERROR,WARNING", limit=5)["entries"]:
            print(entry["timestamp"], entry["severity"], entry["message"][:120])
raise SystemExit(1) # non-zero exit lets cron, CI, or your pager treat it as an alertヘルスが正常なエンドポイントを返すスタブAPIに対して実行すると、1行を出力して終了コード0を返します。P95_BUDGET_MS = 100 の場合は、同じデータでも終了コード1を返します。
healthy=True requests=1200 p95=180 ms errors=0.40%healthはエンドポイントにpingを送り、healthy、status、latencyMsを返します。また、ゼロまでスケールしたエンドポイントを起動するため、5分間隔のチェックはウォーム状態を保つpingとしても機能します。metrics(..., view="overview")は範囲のtotalRequests、errorRate(パーセンテージ)、p95LatencyMsを返します。logsは最新のエラーと警告を取得するため、最初の手がかりとともにアラートを受け取れます。
pip install -U ultralytics-platform を使ってSDKをインストールします(SDKにはPython 3.11以降が必要です)。継続的な問題のみを通知し、たとえばチェックが3回連続で失敗した場合に通知します。また、各アラートに1行のランブック項目を用意します。
実例:ホールドアウトで精度を追跡する#
リクエストメトリクスでは精度を確認できませんが、ホールドアウトなら確認できます。本番環境を反映した画像を200~500枚用意し、丁寧にラベル付けして、独自のプライベートデータセットバージョンに保存します。トレーニングには使用しません。デプロイ済みチェックポイントを毎週評価し、履歴ファイルに追記します。
import json
import sys
from datetime import date
from pathlib import Path

from ultralytics import YOLO

DEPLOYED = "pills-v1.pt"  # the exact best.pt behind the endpoint
HOLDOUT = sys.argv[1] if len(sys.argv) > 1 else "medical-pills.yaml"  # labeled, never trained on

metrics = YOLO(DEPLOYED).val(data=HOLDOUT, split="val", plots=False, verbose=False)
history = Path("holdout_history.jsonl")
rows = [json.loads(line) for line in history.read_text().splitlines()] if history.exists() else []
row = {"date": date.today().isoformat(), "data": HOLDOUT, "map50_95": round(float(metrics.box.map), 4)}
history.write_text("".join(json.dumps(r) + "\n" for r in [*rows, row]))

baseline = rows[0]["map50_95"] if rows else row["map50_95"]
drop = baseline - row["map50_95"]
print(f"holdout mAP50-95 {row['map50_95']:.3f} (baseline {baseline:.3f}, drop {drop:+.3f})")
if drop > 0.01:  # more than 1 mAP point below the deployment-day baseline
    raise SystemExit("ALERT: holdout accuracy regressed - open the retraining runbook")
初回実行では、デプロイ当日のベースラインを記録します。必要になる前にアラートを試験するため、次のスクリプトで、同じラベルと画像を使用し、明るさを15%にした「夜勤」用のホールドアウトコピーを作成します。
import shutil
from pathlib import Path

import cv2

from ultralytics.data.utils import check_det_dataset

src = Path(check_det_dataset("medical-pills.yaml")["path"])
dst = Path("pills-night")
(dst / "images/val").mkdir(parents=True, exist_ok=True)
for img in (src / "images/val").glob("*.jpg"):  # darken every holdout image to mimic a dim night shift
    cv2.imwrite(str(dst / "images/val" / img.name), (cv2.imread(str(img)) * 0.15).astype("uint8"))
shutil.copytree(src / "labels/val", dst / "labels/val", dirs_exist_ok=True)  # same labels, darker pixels
Path("pills-night.yaml").write_text(f"path: {dst.resolve()}\ntrain: images/val\nval: images/val\nnames:\n  0: pill\n")
print("wrote pills-night.yaml")
$ python holdout_check.py
holdout mAP50-95 0.659 (baseline 0.659, drop +0.000)
$ python simulate_night_shift.py
wrote pills-night.yaml
$ python holdout_check.py pills-night.yaml
holdout mAP50-95 0.609 (baseline 0.659, drop +0.050)
ALERT: holdout accuracy regressed - open the retraining runbook夜勤中のすべてのリクエストはミリ秒単位で200を返しますが、モデルのmAPは5ポイント低下しています。これを検知できるのはホールドアウトだけです。四半期ごとに新たにラベル付けした本番画像でホールドアウトを更新し、新しいモデルをデプロイするたびにベースラインをリセットします。モデル監視ガイドと可観測性とドリフトのレッスンでは、統計的なドリフト検定を解説します。
Monitoringタブでドリフトを確認する#
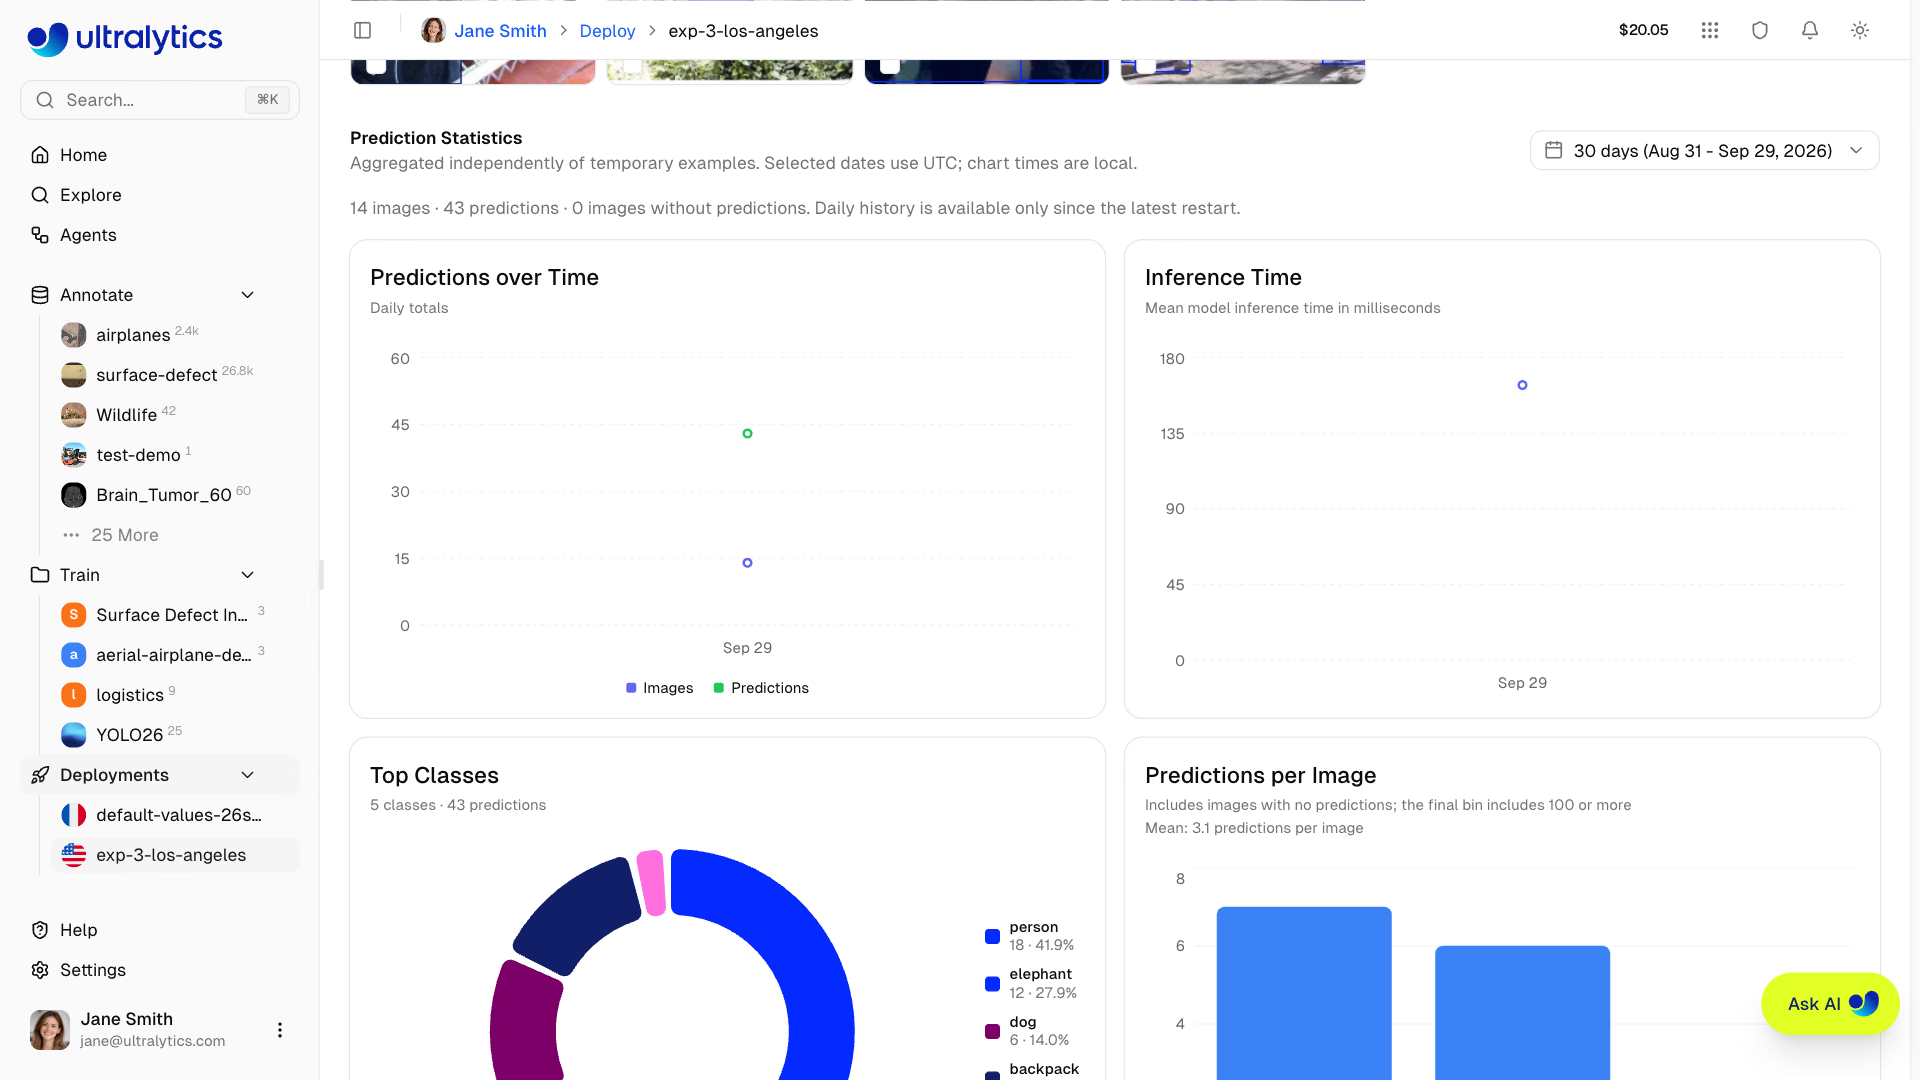
デプロイした週に各チャートの形状を記録し、その後の状態と比較します。信頼度は確信の度合いを示すもので、正しさを示すものではありません。ホールドアウトとあわせて確認してください。
| パターン | 考えられる原因 | 対応 |
|---|---|---|
| 信頼度は低下しているが、ホールドアウトの精度は維持 | 問題のないドメインシフト | 経過を監視し、次のデータセットバージョン用に例を保存 |
| 信頼度とホールドアウトの精度がともに低下 | 実際の精度低下 | 再トレーニング(レッスン10) |
| ボックスのサイズまたは位置が突然変化 | カメラの移動、レンズまたは設置場所の変更 | モデルに手を加える前にカメラを確認 |
| 画像あたりの予測数は減少、信頼度は安定 | カメラのオフライン化、シーンの変化、またはクライアントのバグ | 上流を調査 |
| P95レイテンシは上昇、推論時間は横ばい | リクエスト処理、ペイロードサイズ、または容量 | モデルではなくインフラストラクチャ |
本番画像をフィードバックする#
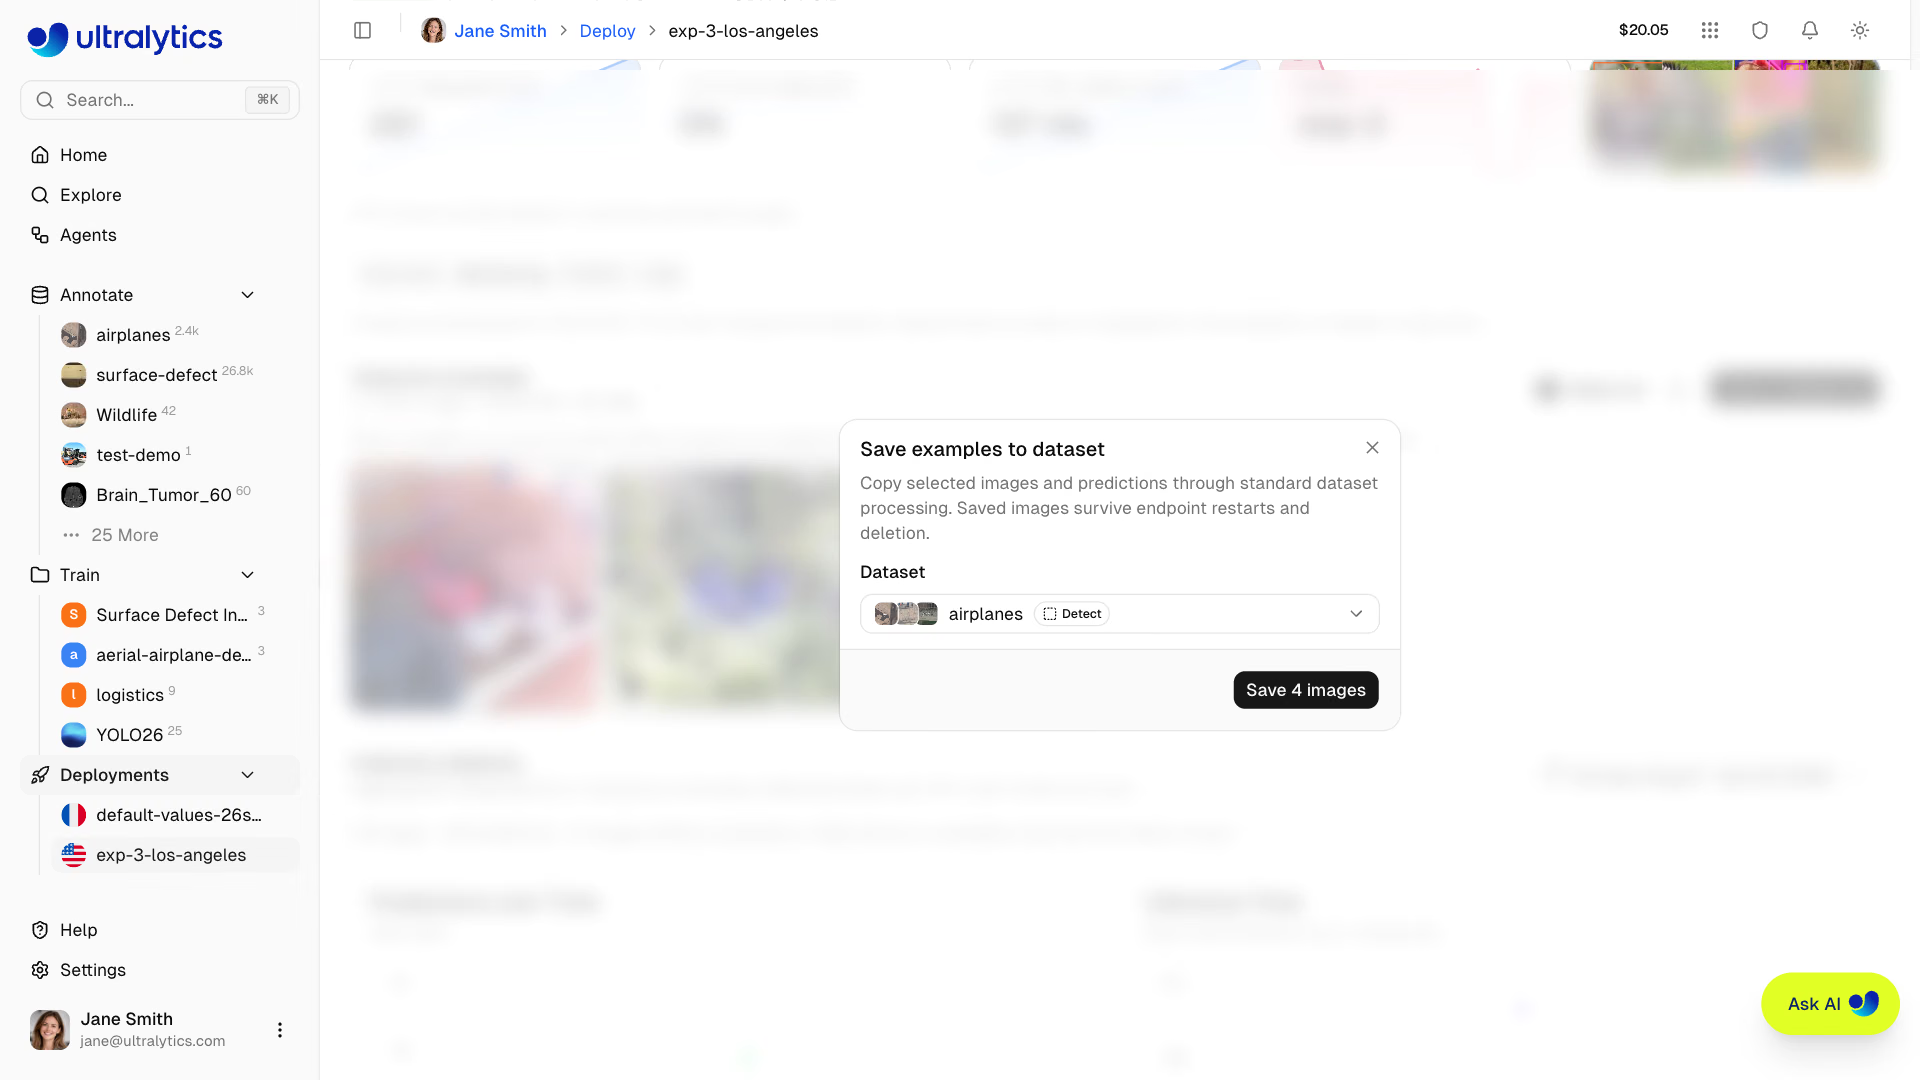
Monitoringタブで例を選択し、Save to dataset をクリックします。例は予測とともに通常の取り込み処理に送られ、メタデータに deploymentId とリージョンが保持されます。Agentsの Collect Uncertain Detections テンプレートも、データセット全体に対して同じ処理を行います。デプロイメントで予測し、信頼度範囲内の検出結果がある画像をレビュー用データセットにコピーします。
よくある落とし穴#
症状: ラベル付けする予定だったサンプルが、サイズ変更やモデルの切り替え後に消えています。対処法: サンプルはサービングインスタンスのメモリ上にあります。データセットに保存し、停止、サイズ変更、またはモデルの置き換えを行う前に、取り込みが完了するまで待ってください。
症状: より良いモデルをリリースした直後にホールドアウトのアラートが発生するか、以後まったく発生しなくなります。対処法: ベースラインは履歴の最初の行です。モデルを置き換えるたびに、新しい holdout_history.jsonl を開始するか、新しいベースライン行を記録してください。
症状: ヘルスステータスが正常なのに、トラフィック急増時にエラー率が上昇します。対処法: 429 の応答はエラーとしてカウントされますが、意味するのは「容量上限に達しています」です。ログを確認し、429 が発生している場合は、複数のエンドポイントにトラフィックを分散するか、より大きなカスタムサイズを使用してください。
解答を表示
pillエンドポイントの実施例:P95_BUDGET_MS = 300とMAX_ERROR_RATE = 1.0を含むcronエントリ*/5 * * * * python endpoint_check.py || ./page-oncall.shを設定します。実際のP95が180 msの環境で予算を100 msに設定すると、終了コード1で終了してページャー通知が送信されるため、設定が機能していることを確認できます。週次CIジョブでは、300枚の非公開ホールドアウトデータのバージョンに対してholdout_check.pyをDEPLOYED = "pills-v2.pt"とともに実行し、ベースラインは0.69です。夜勤時のリハーサルではスコアが0.05低下し、終了コード1とともにALERT行が出力されます。これによりCIジョブが失敗し、チャンネルに通知されます。夕勤のMonitoringサンプル12件は、「Save to dataset」からpill-reviewに保存し、それぞれにdeploymentIdとeurope-west1のタグを付けます。