実行を比較して最適なモデルを選ぶ
Platformプロジェクト内で実行を比較し、それぞれの実行目的を記録して、スクリプトによる昇格ゲートで候補モデルをリリースするか判断します。
大きなモデルは主要メトリクスで勝つことが多い一方、誰も確認していなかったクラスで性能が低下することもあります。事前にルールを決めていなければ、誰かが最も気に入った実行がリリースされてしまいます。このレッスンでは、後から判断の根拠を確認できるよう、すべての実行を記録し、「より良いか」という問いをPASSまたはFAILを返すゲートスクリプトに置き換えます。
実践的
プロジェクト内で実行を比較する#
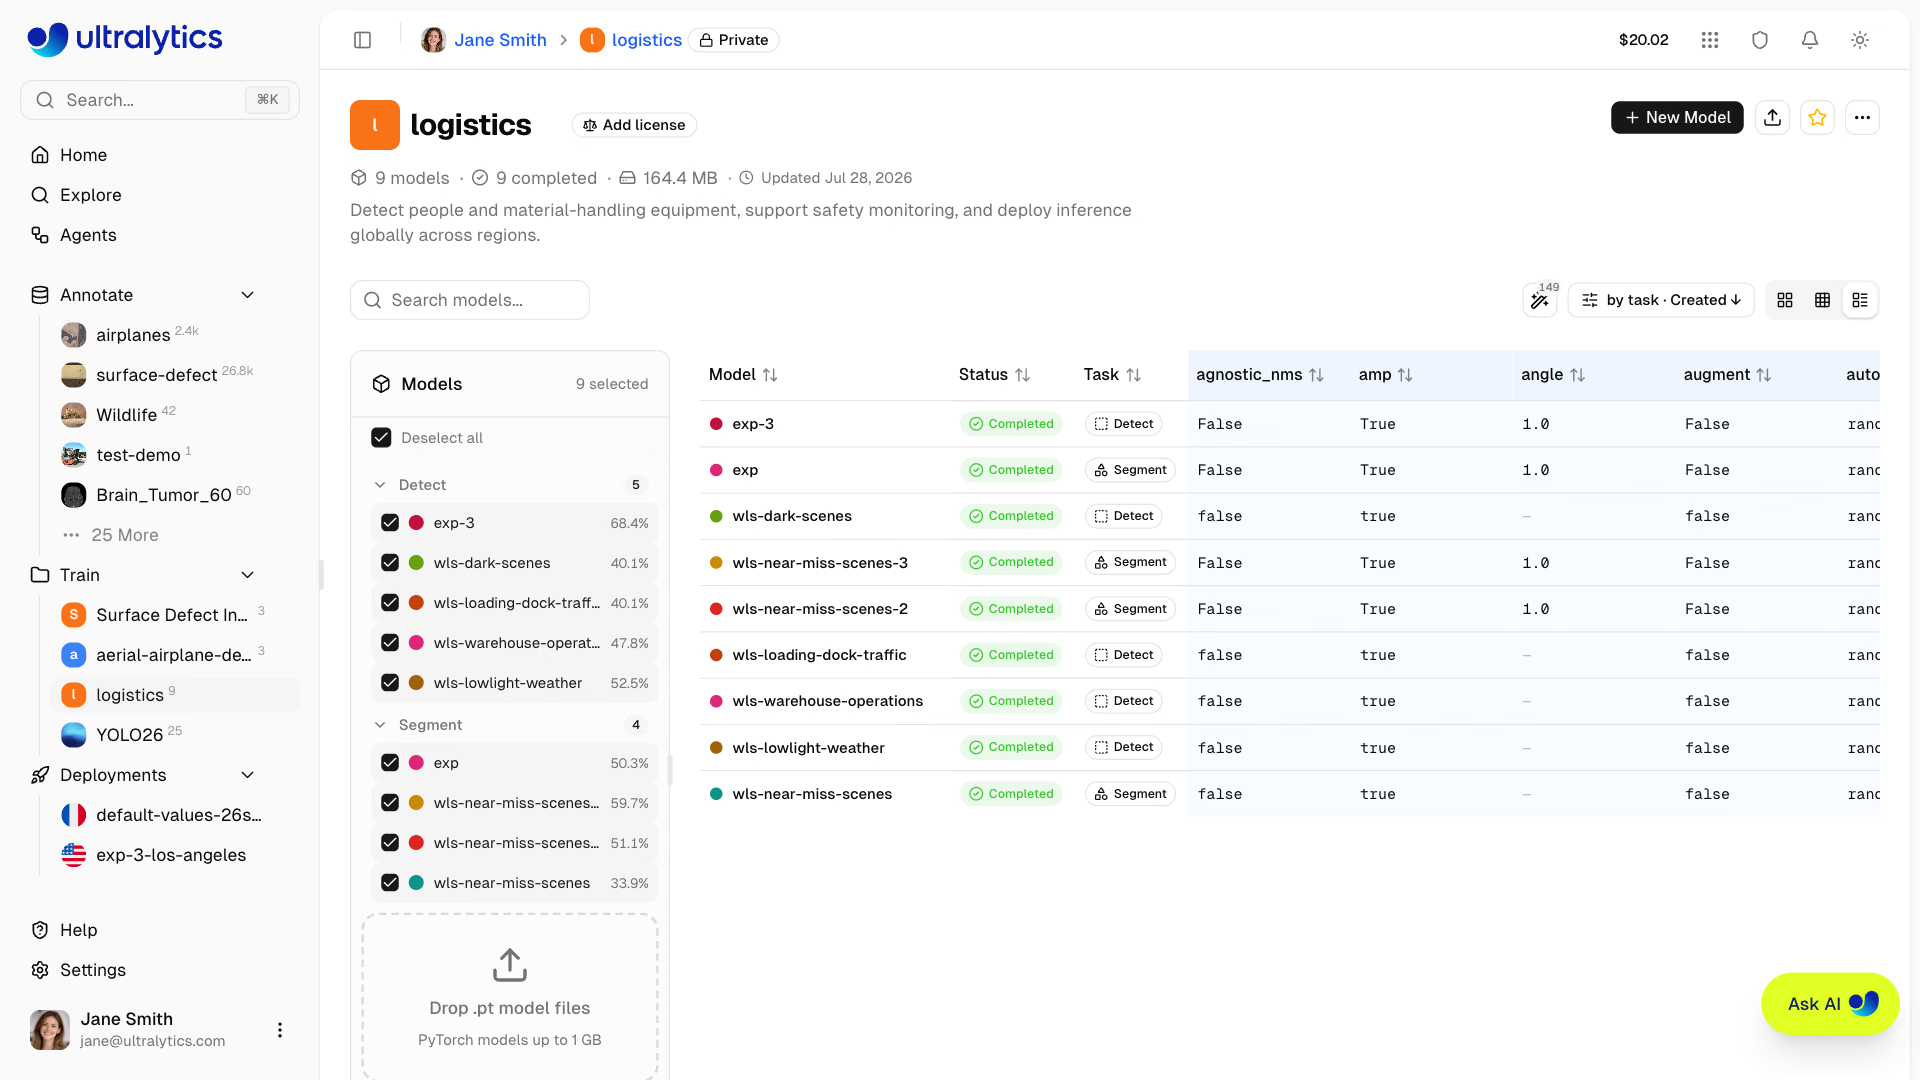
プロジェクトには、チェックボックス付きでモデルが一覧表示されます。チェックしたモデルは Charts ダッシュボードに重ねて表示されます。Table ビューでは学習引数と最終メトリクスが並び、Diff を使うと同一の列が非表示になるため、2つの実行で異なるのが imgsz だけだと一目でわかります。比較は同じプロジェクト内で行うため、関連する実験はまとめてください(モデルはプロジェクト間で切り取り、貼り付けできます)。曲線を確認するときは、最終値、そこに到達するまでの速さ、推移の滑らかさを比較します。

完了済みモデルが2つ以上ある場合、Compare with AI を使うと Ask AI が差異を要約し、次の実験を提案します。その提案は判定ではなく、次の実行に向けた仮説として扱ってください。
すべての実行を説明可能にする#
名前に意味を持たせましょう。run_5 では何もわかりませんが、v3_pallets_added と v4_imgsz1024 なら、データセットのバージョンと変更内容がわかります。判断の根拠を記録するには、モデルページの More actions > Information を開き、JSON形式のメモを Custom Metadata として保存します。
{
  "hypothesis": "Pallet AP is low because val holds only 7 pallets",
  "change": "Dataset v3: +80 pallet images from cam03 and cam07; fine-tuned from v2",
  "result": "Pallet AP 0.31 -> 0.58, overall mAP50-95 0.51 -> 0.59",
  "next": "Forklift recall drops at night; collect dawn and dusk footage"
}そのほかの情報はPlatformに記録されます。Run Information カードには、GPU、時間単価、合計費用、ultralytics のバージョン、ホスト、親モデル、固定されたデータセットバージョン、利用可能な場合はGitコミット、コピー可能な yolo train コマンドが表示されます。比較が公平になるのは同じデータセットバージョンで実行した場合のみです。そのため、すべての実行でデータセットバージョンを固定してください。
結果を見る前にメトリクスとゲートを決める#
| 指標 | 適しているケース |
|---|---|
| mAP50-95 | detect、segment、pose、OBBのデフォルト:適切なボックスを高く評価し、比較にも十分安定しています |
| mAP50 | ボックスの精度がそれほど重要でない、大きくて明確に分離した物体 |
| 1クラスのクラス別AP | 1つのクラスがビジネス価値を左右する場合 |
| precisionを固定した場合のrecall | 安全システムやアラームシステム |
| 対象環境での推論レイテンシ | 常にハードリミットとして設定します |
YOLOのパフォーマンスメトリクスガイドでは各項目を説明しています。候補モデルは、すべてのゲートを通過した場合にのみリリースします。
実例:昇格ゲートのスクリプト#
最終候補の best.pt ファイルをダウンロードし、同一のデータとコードで評価します。この例では、どの環境でも実行できるよう、公式チェックポイントを2つ使用します。
from ultralytics import YOLO

DATA = "coco8.yaml"  # identical held-out data for both runs; use your test split for the final call
BASELINE, CANDIDATE = "yolo26n.pt", "yolo26s.pt"  # e.g. best.pt from two Platform runs
NOISE, CLASS_FLOOR, LATENCY_BUDGET_MS = 0.005, 0.90, 100.0

def evaluate(weights):
    m = YOLO(weights).val(data=DATA, plots=False, verbose=False)
    per_class = {m.names[int(c)]: ap for c, ap in zip(m.box.ap_class_index, m.box.ap)}
    return m.box.map, per_class, m.speed["inference"]

(base_map, base_ap, _), (cand_map, cand_ap, cand_ms) = evaluate(BASELINE), evaluate(CANDIDATE)
weak = [n for n, ap in base_ap.items() if cand_ap.get(n, 0) < CLASS_FLOOR * ap]
gates = {
    f"mAP50-95 {base_map:.3f} -> {cand_map:.3f} beats noise": cand_map - base_map > NOISE,
    f"every class keeps {CLASS_FLOOR:.0%} of its AP (weak: {', '.join(weak) or 'none'})": not weak,
    f"inference {cand_ms:.1f} ms within {LATENCY_BUDGET_MS:.0f} ms": cand_ms <= LATENCY_BUDGET_MS,
}
for name, ok in gates.items():
    print("PASS" if ok else "FAIL", name)
print("verdict:", "ship the candidate" if all(gates.values()) else "keep the baseline, run more experiments")
raise SystemExit(0 if all(gates.values()) else 1)  # non-zero exit blocks a CI release step
PASS mAP50-95 0.669 -> 0.693 beats noise
FAIL every class keeps 90% of its AP (weak: elephant, potted plant)
PASS inference 44.1 ms within 100 ms
verdict: keep the baseline, run more experiments結果:大きいモデルは全体で2.4ポイント上回りますが、2つのクラスでAPが10%を超えて低下するため、不合格です。これは主要メトリクスだけの比較では見逃される性能低下です。クラス別辞書は ap_class_index と ap から取得し、データに含まれるクラスのみを対象とします。レイテンシはスクリプトを実行しているマシンで計測されるため、デプロイ先に近いハードウェアでゲートを実行してください。COCO8の検証画像はわずか8枚で、実際の判断にはまったく不十分です。少なくとも数百枚のホールドアウトセットを使用し、最終判断のために split="test" を一度だけ渡してください。
性能の低い画像を詳しく調べる#
保存済みデータセットバージョンを使って学習した検出実行では、Validation ビューに Validation insights が追加されます。正解ラベルとともに表示される、画像ごとのF1が最も低い画像と最も高い画像、F1と画像サイズ・アスペクト比・インスタンス数の相関を示す特性エクスプローラー、失敗との関連性が最も高いクラスを確認できます。性能の低い画像で Find similar を使うと、類似画像をラベルなし画像として学習セットに追加でき、ゲートの失敗を具体的なデータ作業につなげられます。
よくある落とし穴#
症状: 報告されたテスト mAP は非常に高いのに、本番環境の結果は劣っています。対処法: チューニングには val を使用してください。テストで 10 回の実行を比較した場合、テストはすでにチューニングに使われており、その数値は実際より高く見積もられています。最終候補のスコアは、最後に一度だけテストで評価してください。
症状: ある実行が 4 ポイント差で「勝った」のに、理由を誰も再現できません。対処法: 各実行の Run Information カードで、固定されたデータセットバージョンを確認してください。異なる場合は、比較する前に新しいバージョンでベースラインを再実行してください。
症状: 新しいシードで再トレーニングするたびに、勝者が変わります。対処法: ほとんどのデータセットでは、約 0.5 mAP ポイント未満の差は実行ごとのノイズです。ゲートではノイズのしきい値を維持し、結果がこれほど僅差の場合は、より大きなホールドアウトを使用してください。
解答を表示
pillモデルでの回答例:ベースライン v1-baseline(10エポック)と候補 v2-finetune(さらに5エポック、SGD、lr0 0.001)を比較します。DATA = "medical-pills.yaml" と2つの重みを gate.py で設定します。出力:PASS mAP50-95 0.659 -> 0.687 beats noise、PASS every class keeps 90% of its AP (weak: none)、PASS inference 4.0 ms within 100 ms。判定は「候補をリリース」です。v2のCustom Metadataには、仮説「v1はエポック10でも改善が続いていた」、変更「5エポックのファインチューニング、SGD lr0 0.001」、結果「mAP50-95 0.659 -> 0.687」を記録します。メタデータには注意事項も記録してください。medical-pillsのvalデータも学習の判断に使われているため、本番環境に移行する前に別のホールドアウトセットで確認が必要です。