エンドポイントをデプロイして呼び出す
42か所のリージョンから専用エンドポイントを作成し、トラフィックに合わせてサイズを設定します。コールドスタート、429エラー、無効なキーに対応するクライアントから呼び出します。
ゼロまでスケールする無料エンドポイントでは、最初のリクエストへの応答に最大1分かかることがあり、単純なクライアントではユーザー向けのタイムアウトにつながります。キーが漏えいすると、削除後も使い続けられます。このレッスンでは、最適なモデルをデプロイし、エンドポイントのサイズを慎重に選び、本番環境のすべての統合に必要な小さなクライアントを作成します。
実践的
共有推論または専用エンドポイント#
すべてのモデルはPlatformの共有推論APIを通じてすでに呼び出すことができ、テストに適しています。本番トラフィックには専用エンドポイントを使用します。
| 共有推論 | 専用エンドポイント | |
|---|---|---|
| サービス | Platformユーザー間で共有 | 単一テナントで1モデル |
| リージョン | データリージョン(US、EU、またはAP) | 42か所のリージョンから選択 |
| レート制限 | キーごとに1分あたり20リクエスト | 直接呼び出しにPlatformの制限なし |
| リクエストサイズ | 約4.5 MB | 32 MB、リクエストあたり最大1時間(動画にも対応) |
| 認証 | 任意のワークスペース API キー | デプロイメントに紐付けられたキーのみ |
エンドポイントを作成してサイズを設定する#
モデルの Deploy タブを開きます。ブラウザーが全42リージョン(南北アメリカ14、ヨーロッパ13、アジア太平洋12、中東・アフリカ3)へのレイテンシを測定し、その値でテーブルを並べ替えます。
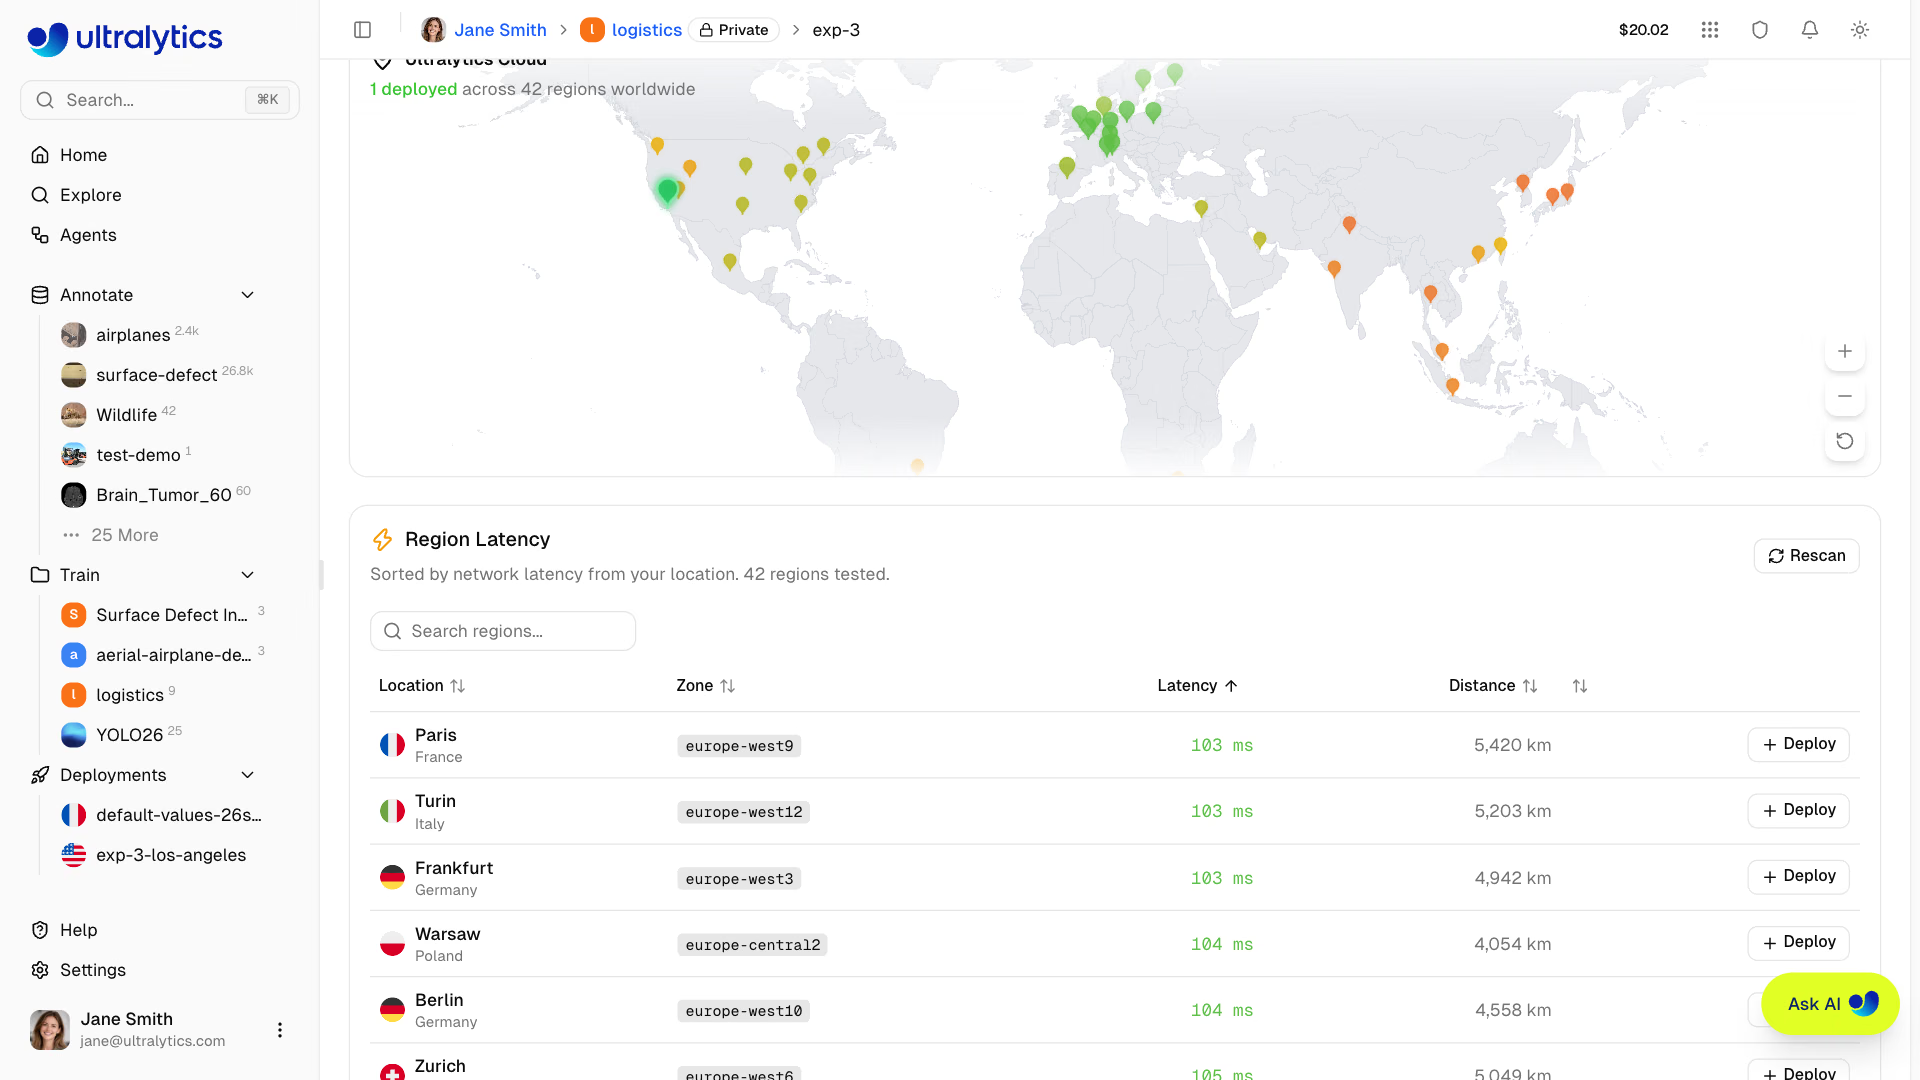
呼び出し元に最も近い行の Deploy をクリックし、CPU、メモリ、料金、生成された名前(yolo26n-iowa など)を確認して、Create Deployment をクリックします。プロフィールのDeploymentsタブにある New Deployment から開始することもできます。
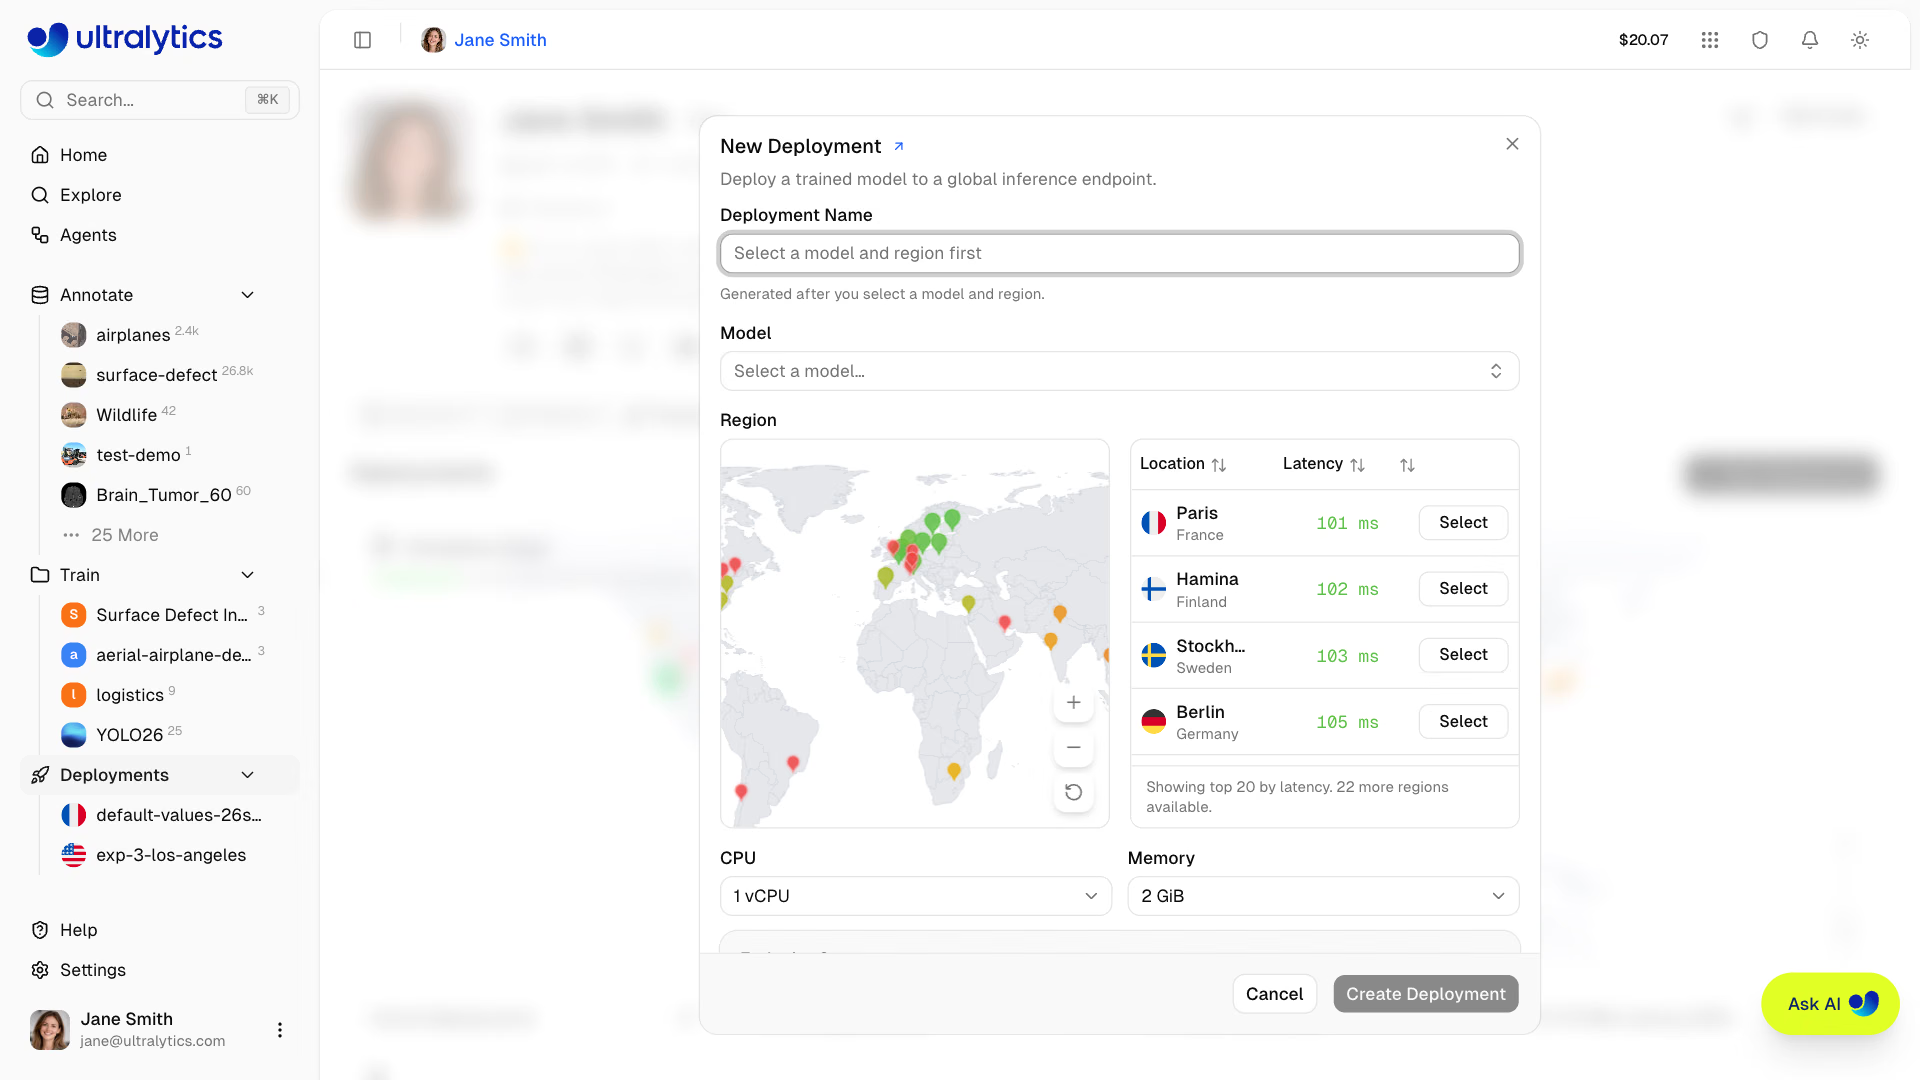
トラフィックパターンに応じたサイズ設定:
| トラフィック | 規模 | 費用 |
|---|---|---|
| バッチジョブ、社内ツール、断続的に負荷が高まるデモ | デフォルトは1 vCPU、2 GiB。ゼロまでスケールします | すべてのプランで無料 |
| コールドスタートを待てない、安定したリアルタイムトラフィック | カスタムサイズ(1~8 vCPU、2~32 GiB)で、ウォーム状態のインスタンスを1つ維持 | 利用可能になってから停止するまで、アイドル時間も含めて時間単位で課金されます。アイオワでは1 vCPU、4 GiBで約$0.12/時です |
| 複数の大陸にいるユーザー | 独自のルーターの背後にリージョンごとに1つのエンドポイント | 各エンドポイントはサイズに応じて課金 |
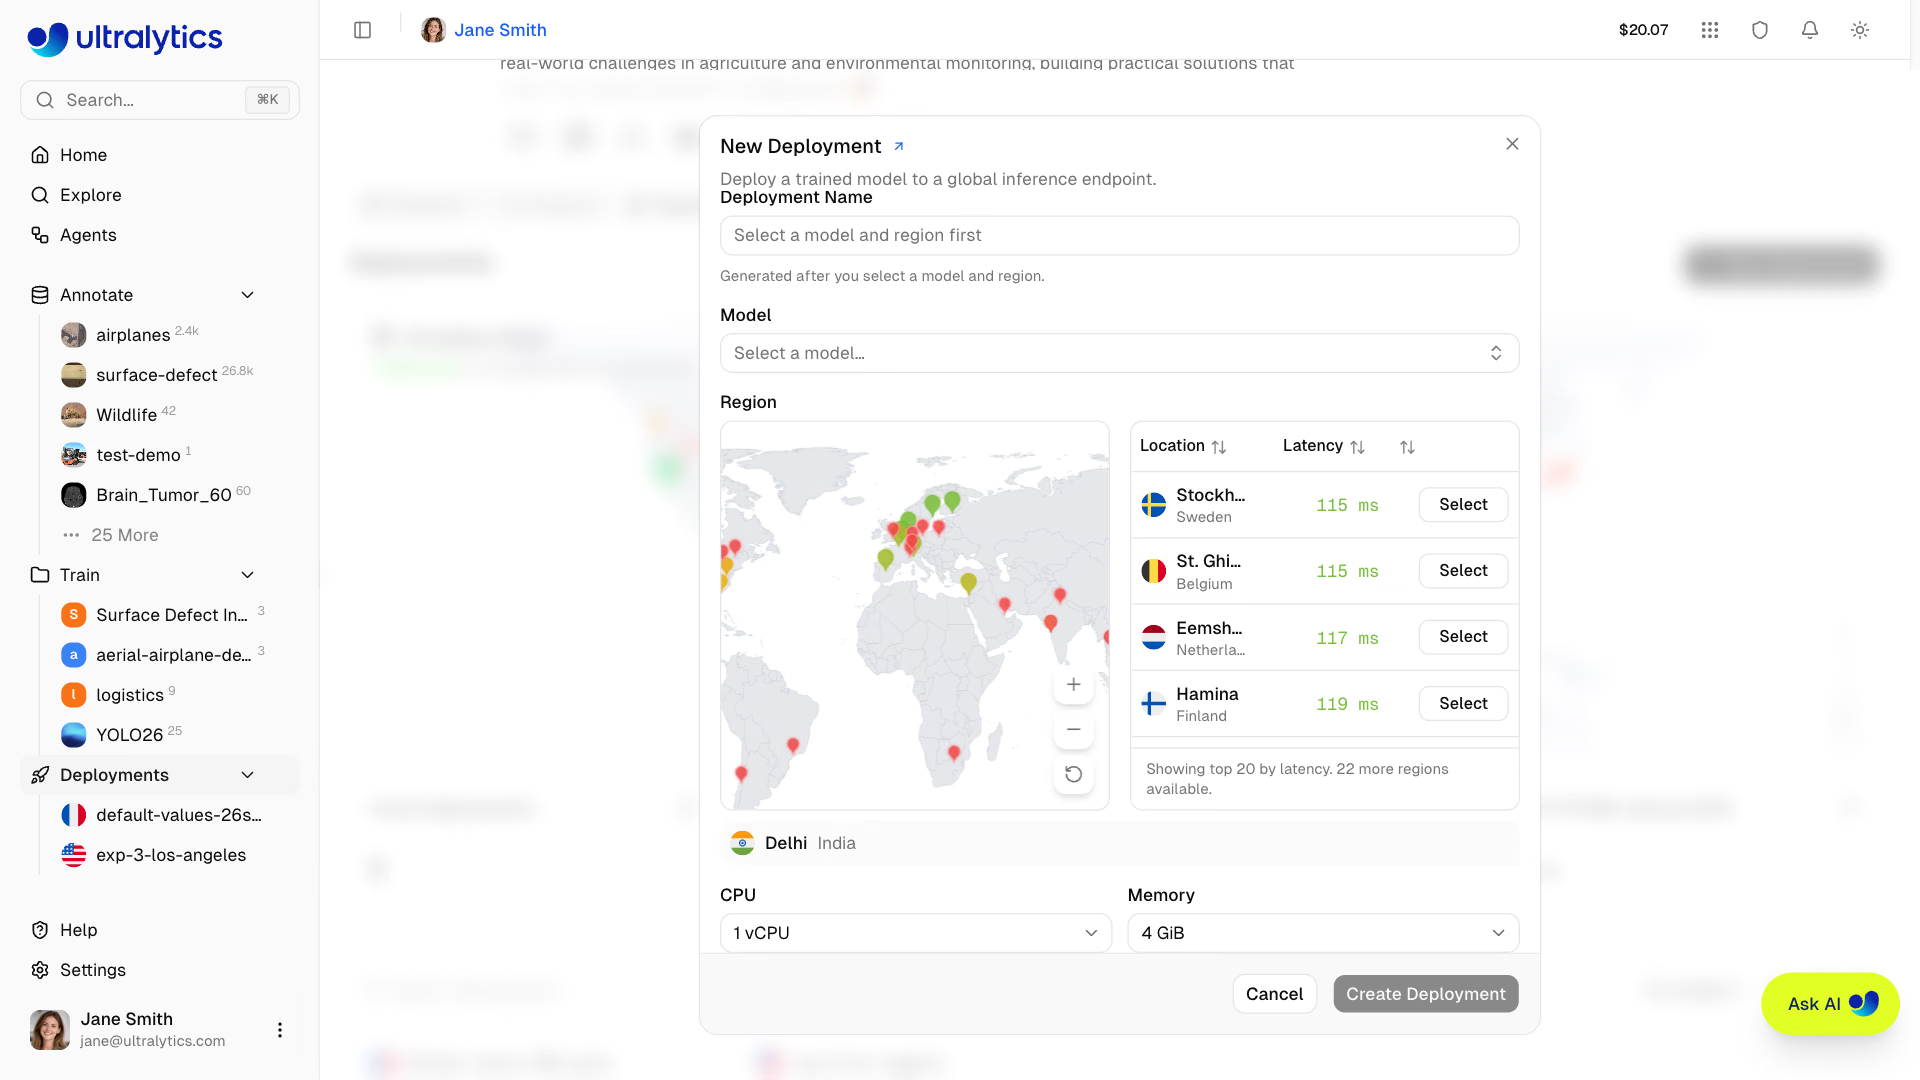
プランごとのデプロイメント数は、Freeで3、Proで10、Enterpriseで無制限です。停止中のエンドポイントも数に含まれます。バッジが Ready になると、エンドポイントでトラフィックを受け付けます。
実例:本番環境に耐えるクライアント#
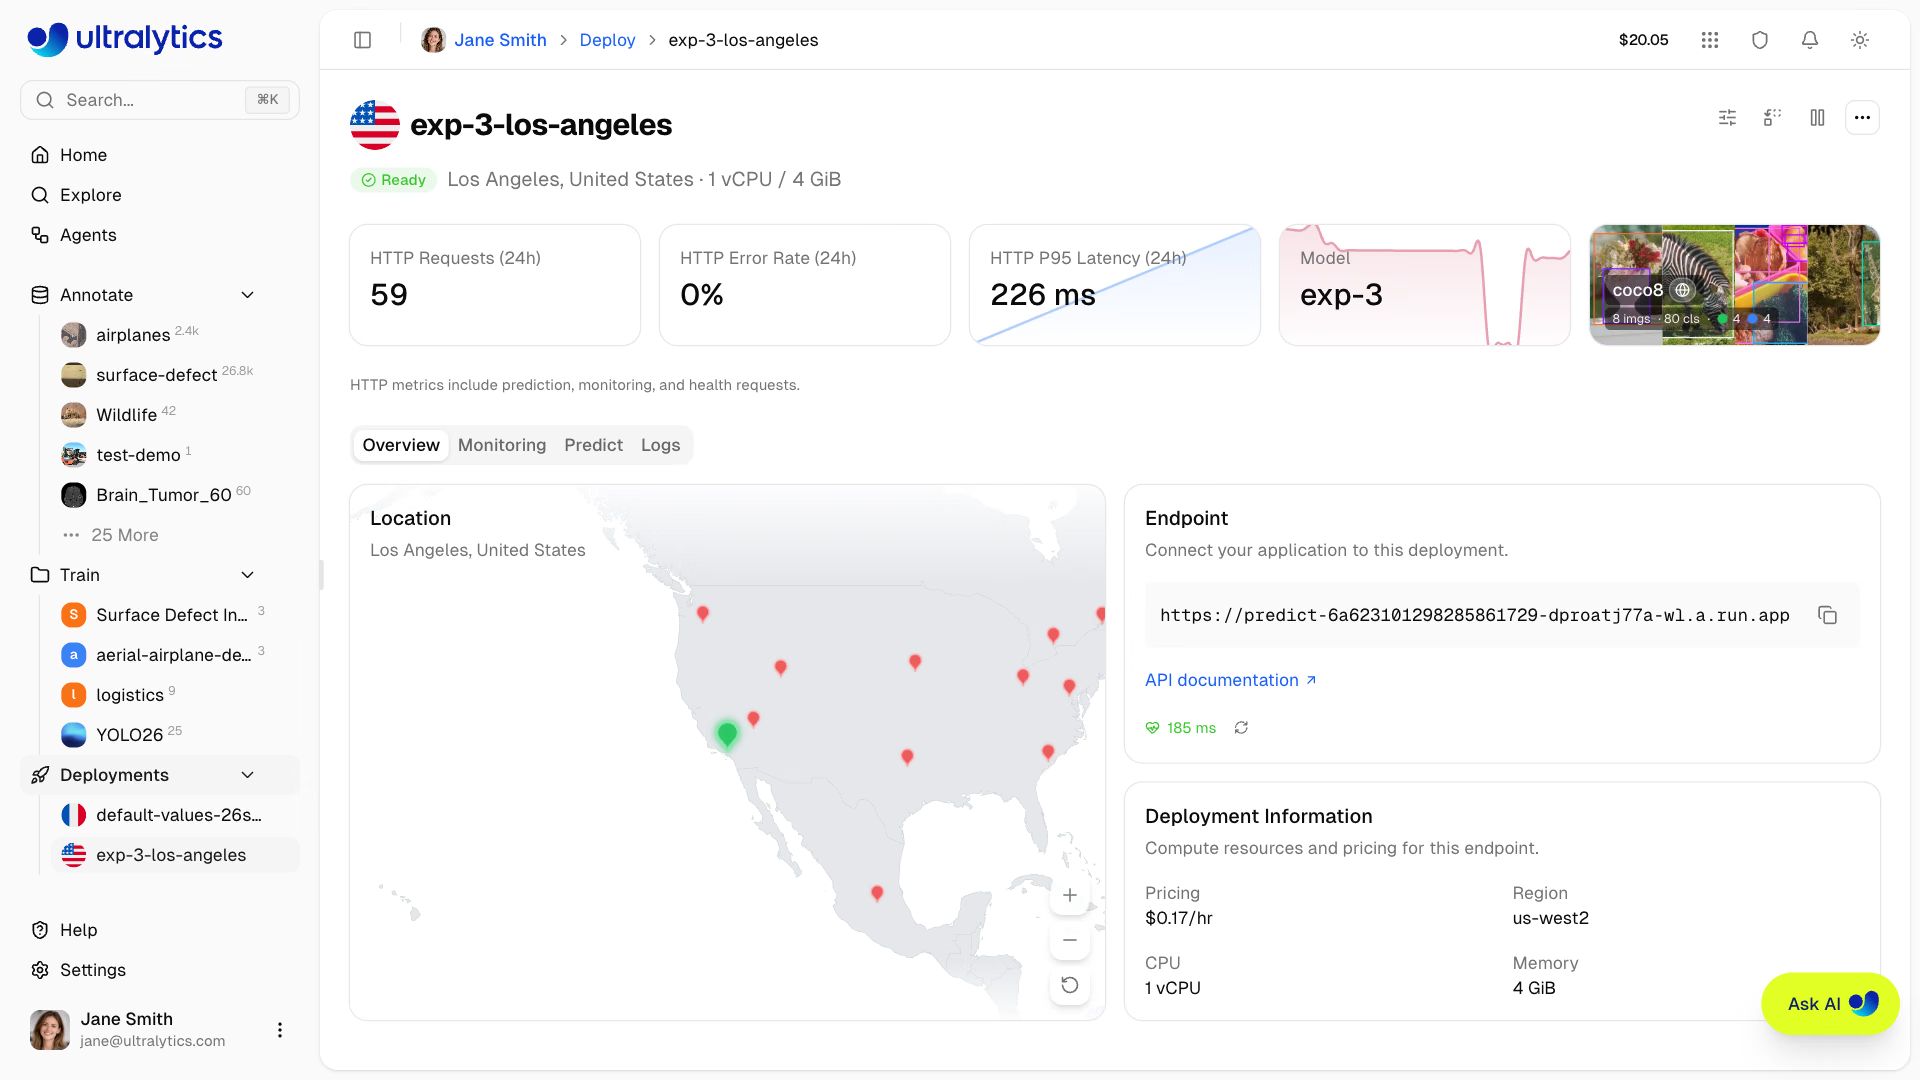
各エンドポイントには https://predict-<id>-<hash>-<region>.a.run.app のようなURLがあり、/predict(POST)、/health、インタラクティブな /docs ページを提供します。作成時に紐付けられたAPIキーのみを受け付けます。ワークスペースのオーナーには、そのキーがデプロイメントの Predict タブの Docs にあらかじめ入力され、Python、JavaScript、cURLのスニペットとともに表示されます。スニペットはリクエストを1回送るだけです。本番コードでは、コールドスタートやインスタンスの高負荷にも対処する必要があります。
import os
import time
from collections import Counter

import httpx

URL = "https://YOUR_DEPLOYMENT_URL.run.app/predict"
HEADERS = {"Authorization": f"Bearer {os.environ['ULTRALYTICS_API_KEY']}"}  # the deployment's bound key, server-side only

def predict(client, path, conf=0.25, attempts=4):
    """POST one image; retry timeouts, 429, and 5xx with backoff; fail fast on other errors."""
    for attempt in range(attempts):
        try:
            with open(path, "rb") as f:
                r = client.post(URL, headers=HEADERS, data={"conf": conf}, files={"file": f}, timeout=90)
            if r.status_code < 400:
                return r.json()
            if r.status_code != 429 and r.status_code < 500:
                r.raise_for_status()  # 401 wrong key, 413 too large: retrying won't help
            wait, reason = float(r.headers.get("Retry-After", 2**attempt)), r.status_code
        except httpx.TimeoutException:  # a scaled-to-zero endpoint can take up to a minute to wake
            wait, reason = 2**attempt, "timeout"
        print(f"attempt {attempt + 1}: {reason}, retrying in {wait:.0f} s")
        time.sleep(wait)
    raise RuntimeError(f"endpoint still unavailable after {attempts} attempts")

with httpx.Client() as client:
    response = predict(client, "bus.jpg")
for image in response["images"]:
    counts = Counter(d["name"] for d in image["results"])
    print(f"{sum(counts.values())} objects {dict(counts)} in {image['speed']['inference']:.1f} ms")
ローカルスタブでテストしました。このスタブは 429 に一度応答した後、エンドポイントのレスポンス形式で bus.jpg に対する実際のYOLO26nの結果を返します。
attempt 1: 429, retrying in 2 s
5 objects {'bus': 1, 'person': 4} in 34.9 ms
重要な判断ポイントを1行ずつ見ていきます。
timeout=90は最大約1分のコールドスタートに対応します。一般的なHTTPクライアントのデフォルトのタイムアウトは、これより大幅に短く設定されています。- 429と5xxは再試行されます。エンドポイントから送信された場合は
Retry-Afterに従います。各エンドポイントは単一のインスタンスでリクエストを処理し、負荷が高い場合は429で負荷を抑えます。 - その他の4xxエラーは即座に失敗します。
401はキーの誤り、413は32 MBを超えるボディを意味し、どちらも再試行しても解決しません。 - レスポンスには、
imagesに画像(または動画フレーム)ごとに1つのエントリーが含まれます。各エントリーにはresults(class、name、confidence、boxとx1、y1、x2、y2)と、ミリ秒単位のspeedが含まれます。
任意のフォームフィールドは conf(デフォルト0.25)、iou(0.7)、imgsz(モデルのトレーニングサイズ)、動画用の vid_stride、0~1の座標用の normalize=true です。cURLの場合、各フィールドを1行で指定します。
curl -X POST "https://YOUR_DEPLOYMENT_URL.run.app/predict" \
  -H "Authorization: Bearer $ULTRALYTICS_API_KEY" \
-F "file=@bus.jpg" -F "conf=0.25" -F "iou=0.7" -F "imgsz=640"URLを変えずに新しいバージョンをリリースする#
デプロイメントページの Replace model では、同じワークスペース内で学習が完了した別のモデルに切り替えられます。新しいモデルの準備ができるまでは古いモデルが引き続きリクエストを処理し、URL、リージョン、キーは変わりません。ロールアウトに失敗した場合は、以前のモデルが引き続き稼働します。ロールバックは、以前のモデルを指定して同じ操作を行うだけなので、そのモデルはプロジェクト内に保持してください。Update configuration ではその場でサイズを変更でき、Stop ではURLを維持したまま課金を一時停止できます。
一部の変更には新しいエンドポイントが必要です。リージョンは固定されているため、移動するには削除して再作成する必要があり、新しいURLになります。また、カスタムドメインには対応していません。呼び出し元に一貫したブランド名のホスト名が必要な場合は、独自のゲートウェイを前段に配置してください。Platformの外部で実行するには、モデルをエクスポート(デプロイメント用にエクスポート)するか、Triton Inference Serverの背後でセルフホストしてください。
よくある落とし穴#
症状: エンドポイントに、原因を特定できないトラフィックが届いています。対処法: キーを Web アプリやモバイルアプリに含めず、バックエンドからエンドポイントを呼び出してください。紐付けられたキーを削除または無効化しても、そのキー文字列を引き続き受け付けるため、エンドポイントは保護されません。アクセスを取り消すには、デプロイを停止または削除し、新しいキーを紐付けて新たにデプロイしてください。
症状: 朝一番のリクエストは失敗しますが、再試行すると成功します。対処法: デフォルトサイズのエンドポイントは、インスタンス数がゼロまでスケールします。タイムアウトを少なくとも 90 秒に設定するか、予想されるトラフィックの前に /health 呼び出しでエンドポイントをウォームアップするか、すべてのリクエストに高速な応答が必要な場合はカスタムサイズに切り替えてください。
症状: アップロードが 413 で失敗します。対処法: 専用エンドポイントが受け付けるリクエストボディの上限は 32 MB です。長い動画は短いクリップに分割するか、サンプリングしたフレームを送信し、vid_stride を渡してサーバー側でフレームをスキップしてください。
解答を表示
錠剤のラインカメラの回答例:v2-finetune を europe-west1(ドイツ工場からのレイテンシが最も低いサン=ギスラン)にデフォルトサイズでデプロイします。1時間アイドル状態にした後のコールドリクエストは38秒で、90秒のタイムアウト内に収まります。ウォーム状態のリクエストは0.3秒です。シフト中、ラインのPLCは30秒ごとにフレームを送信するため、エンドポイントはシフト中ずっとウォーム状態を保ち、コールドスタートが発生するのは最初のフレームだけです。各シフトの2分前にラインコントローラーから /health を呼び出せば、コールドスタートも解消できるため、無料のデフォルトサイズを維持できます。これにより、カスタムの1 vCPU、4 GiBインスタンスと比べて月額約90ドルを節約できます。モデルを v1-baseline に戻すと、同じURLから v1 の結果が返されます。最後に、もう一度 v2 に置き換えます。