キュレーション、重複排除、分割
2つの短いスクリプトで分割間の重複とクラスの不足を検出し、重要な単位ごとに分割して、監査済みデータセットのバージョンを固定します。
検証スコアの信頼性は、分割の適切さに左右されます。人気のデモ用データセットであるCOCO128は、設計上、同じ128枚の画像をtrainとvalの両方に使用しています。独自のデータでこれを誤って再現すると、次のカメラでは機能しない「優れた」モデルができてしまいます。このレッスンでは、実データに対して重複チェックとクラスごとの分割監査という2つの監査を実施し、カメラごとに分割したうえで、両方の監査に合格したバージョンを固定します。
実践的
実例:分割間で共有されている画像を見つける#
Platformでは、アップロード時の競合への対処方法を確認し、分割ごとに画像のコピーを1つだけ保持します。しかし、同じ画像やシーンがtrainとvalの両方に入るのを防ぐ仕組みはありません。アップロード前と、データセットのマージ後に確認してください。
import hashlib
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("coco128.yaml")  # any local YOLO dataset YAML before you upload it

def hashes(split_dir):
    return {hashlib.md5(p.read_bytes()).hexdigest(): p.name for p in Path(split_dir).rglob("*.jpg")}

train, val = hashes(data["train"]), hashes(data["val"])
shared = train.keys() & val.keys()
print(f"train {len(train)} images, val {len(val)} images, identical in both: {len(shared)}")
print("examples:", sorted(val[h] for h in shared)[:3])
train 128 images, val 128 images, identical in both: 128
examples: ['000000000009.jpg', '000000000025.jpg', '000000000030.jpg']COCO128の検証画像はすべてトレーニング画像でもあります。これはスモークテスト用データセットとして意図的に設定されたものであり、その検証mAPが汎化性能を示さない理由でもあります。独自のデータで件数が0でなければ、リークがあります。トレーニング前に、各画像のコピーを1つ移動または削除してください。
Clusteringで類似画像を検出する#
ハッシュで検出できるのは、バイト列が完全に同一の画像だけです。連続する動画フレーム、連写写真、再エンコードされたコピーは、数ピクセル異なります。ギャラリーのツールバーにある散布図アイコンを開き、Analyze Datasetをクリックします(画像数20~200,000枚、アップロード済みデータセットのみ)。
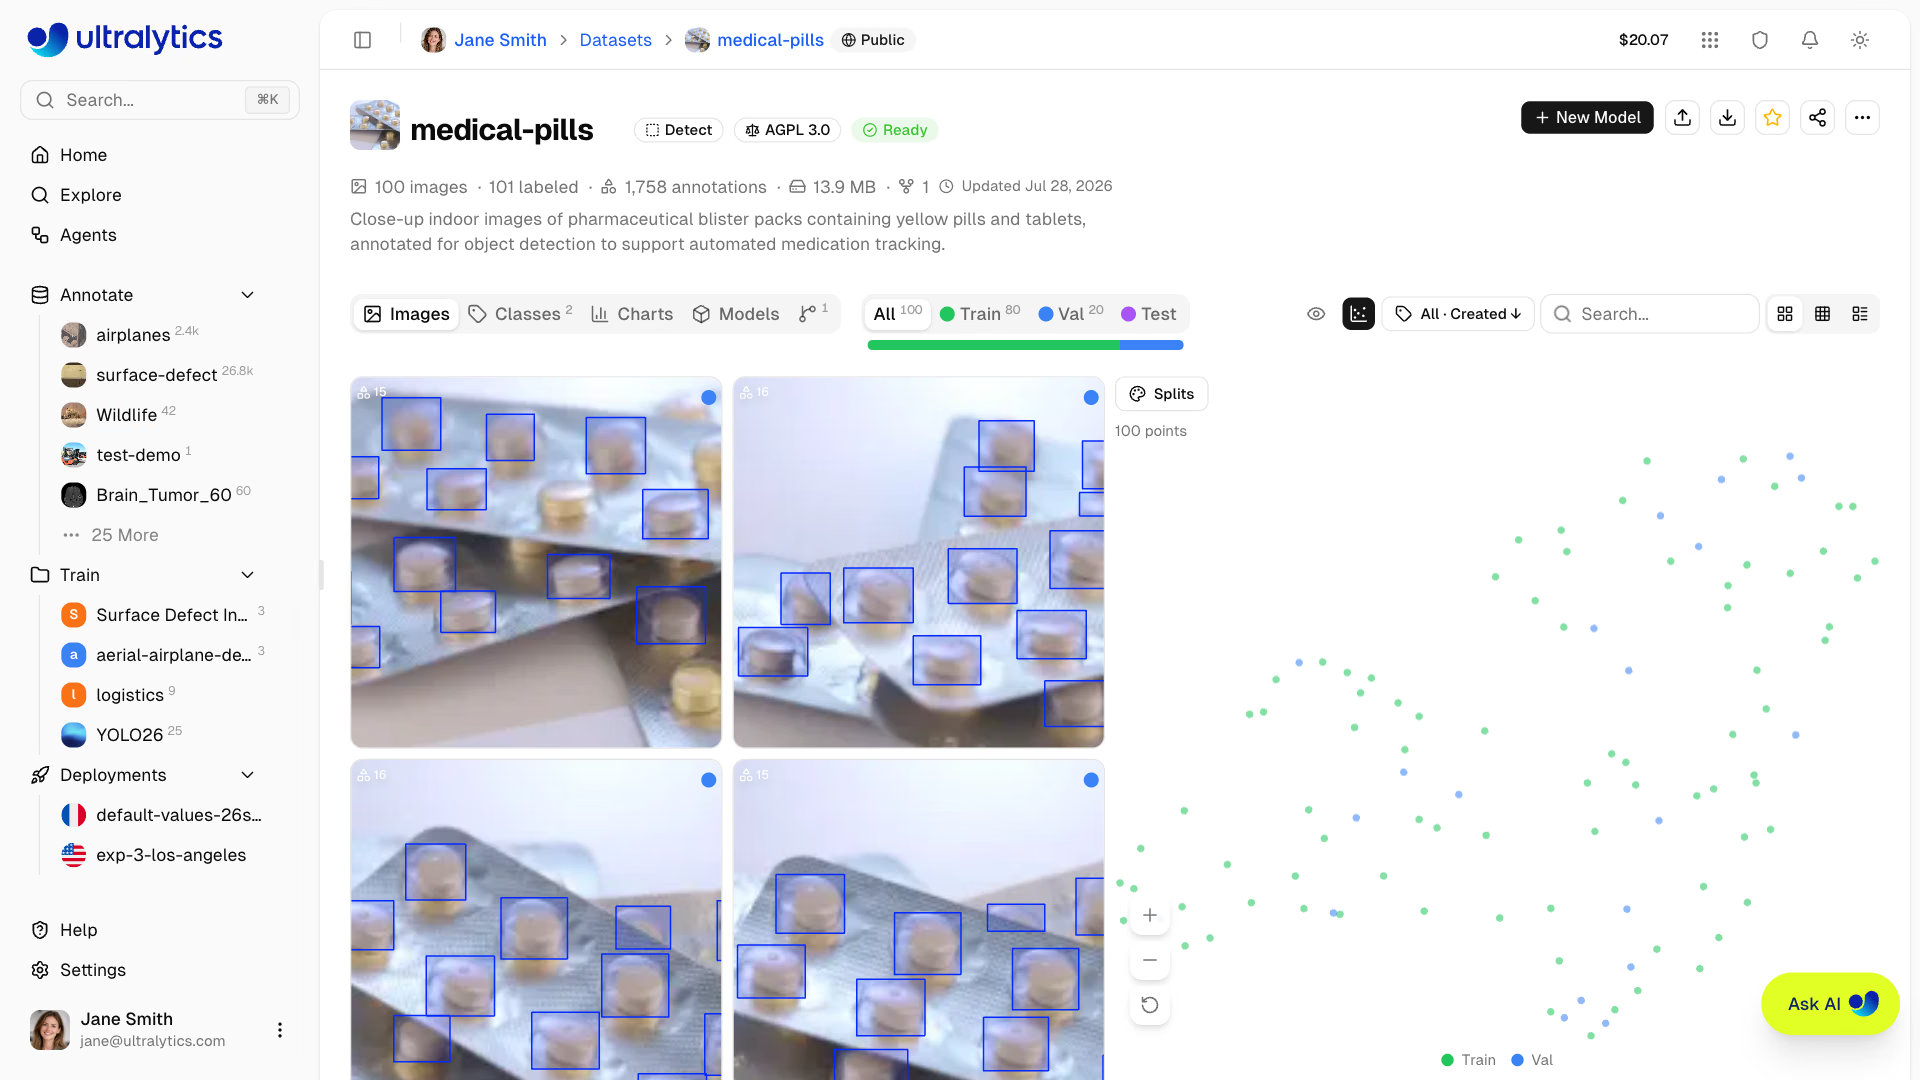
- 分割で色分け:trainとvalの点が混在する密集した島は、類似画像によるリークを示しています。
- クラスターまたはクラスで色分け:単一クラスの大きな島は、データセット内で過剰に含まれている対象を示します。孤立した点は外れ値(異なるカメラ、破損フレーム、誤ラベル画像)です。
- 領域をなげなわ選択またはクリックすると、ギャラリーをその画像(最大1,000枚)に絞り込めます。その後、画像を削除、移動、または再ラベル付けします。
同じ埋め込みは、画像のコンテキストメニューにある類似画像を検索でも使われます。この機能は、公開データセットやチームのデータセットから類似画像を未ラベル画像としてtrainに追加します。以下の監査で見つかった不足を補う最速の方法です。
実例:分割ごとのクラスを監査する#
データセットのヘッダーまたはVersionsタブからNDJSONエクスポートをダウンロードします。ヘッダーの後に続く各行には、分割とラベルを含む1枚の画像が記録されているため、数行のPythonで各分割の各クラスをカウントできます。ここでは、公開されているCOCO8のエクスポートを使います。
import json
from collections import Counter, defaultdict

counts = defaultdict(Counter)  # split -> class name -> instances
images = Counter()
with open("coco8.ndjson") as f:  # the NDJSON export from the dataset header or Versions tab
    header = json.loads(f.readline())
    names = header["class_names"]
    for line in f:
        record = json.loads(line)
        images[record["split"]] += 1
        for box in (record.get("annotations") or {}).get("boxes", []):
            counts[record["split"]][names[str(box[0])]] += 1

print("images per split:", dict(images))
for name in sorted(set(counts["train"]) | set(counts["val"])):
    train, val = counts["train"][name], counts["val"][name]
    flag = "missing in train" if not train else "too few in val" if val < 10 else ""
    print(f"{name:<14} train {train:>3}  val {val:>3}  {flag}")
images per split: {'train': 4, 'val': 4}
bowl train 3 val 0 too few in val
broccoli train 1 val 0 too few in val
dog train 0 val 1 missing in train
elephant train 0 val 2 missing in train
giraffe train 2 val 0 too few in val
horse train 0 val 2 missing in train
orange train 4 val 0 too few in val
person train 0 val 10 missing in train
potted plant train 1 val 1 too few in val
umbrella train 0 val 1 missing in train
vase train 1 val 0 too few in val
zebra train 1 val 0 too few in val読み方:ヘッダー行にはclass_namesが含まれ、各検出ボックスは[class, x, y, w, h]です。trainに不足している場合、モデルはそのクラスをまったく学習できず、そのクラスのval APは0になります。valの件数が少なすぎる場合、実行のたびにAPが大きく変動します。valにパレットが7個ある場合、パレットを1個見逃すと、パレットAPは約14ポイント変動します。COCO8は8枚の画像を使ったスモークテストなので、すべてのクラスが条件を満たしません。本番用のバージョンでは、フラグが一切出ない状態を目指してください。不足はチューニングではなく、例を追加して解消します。
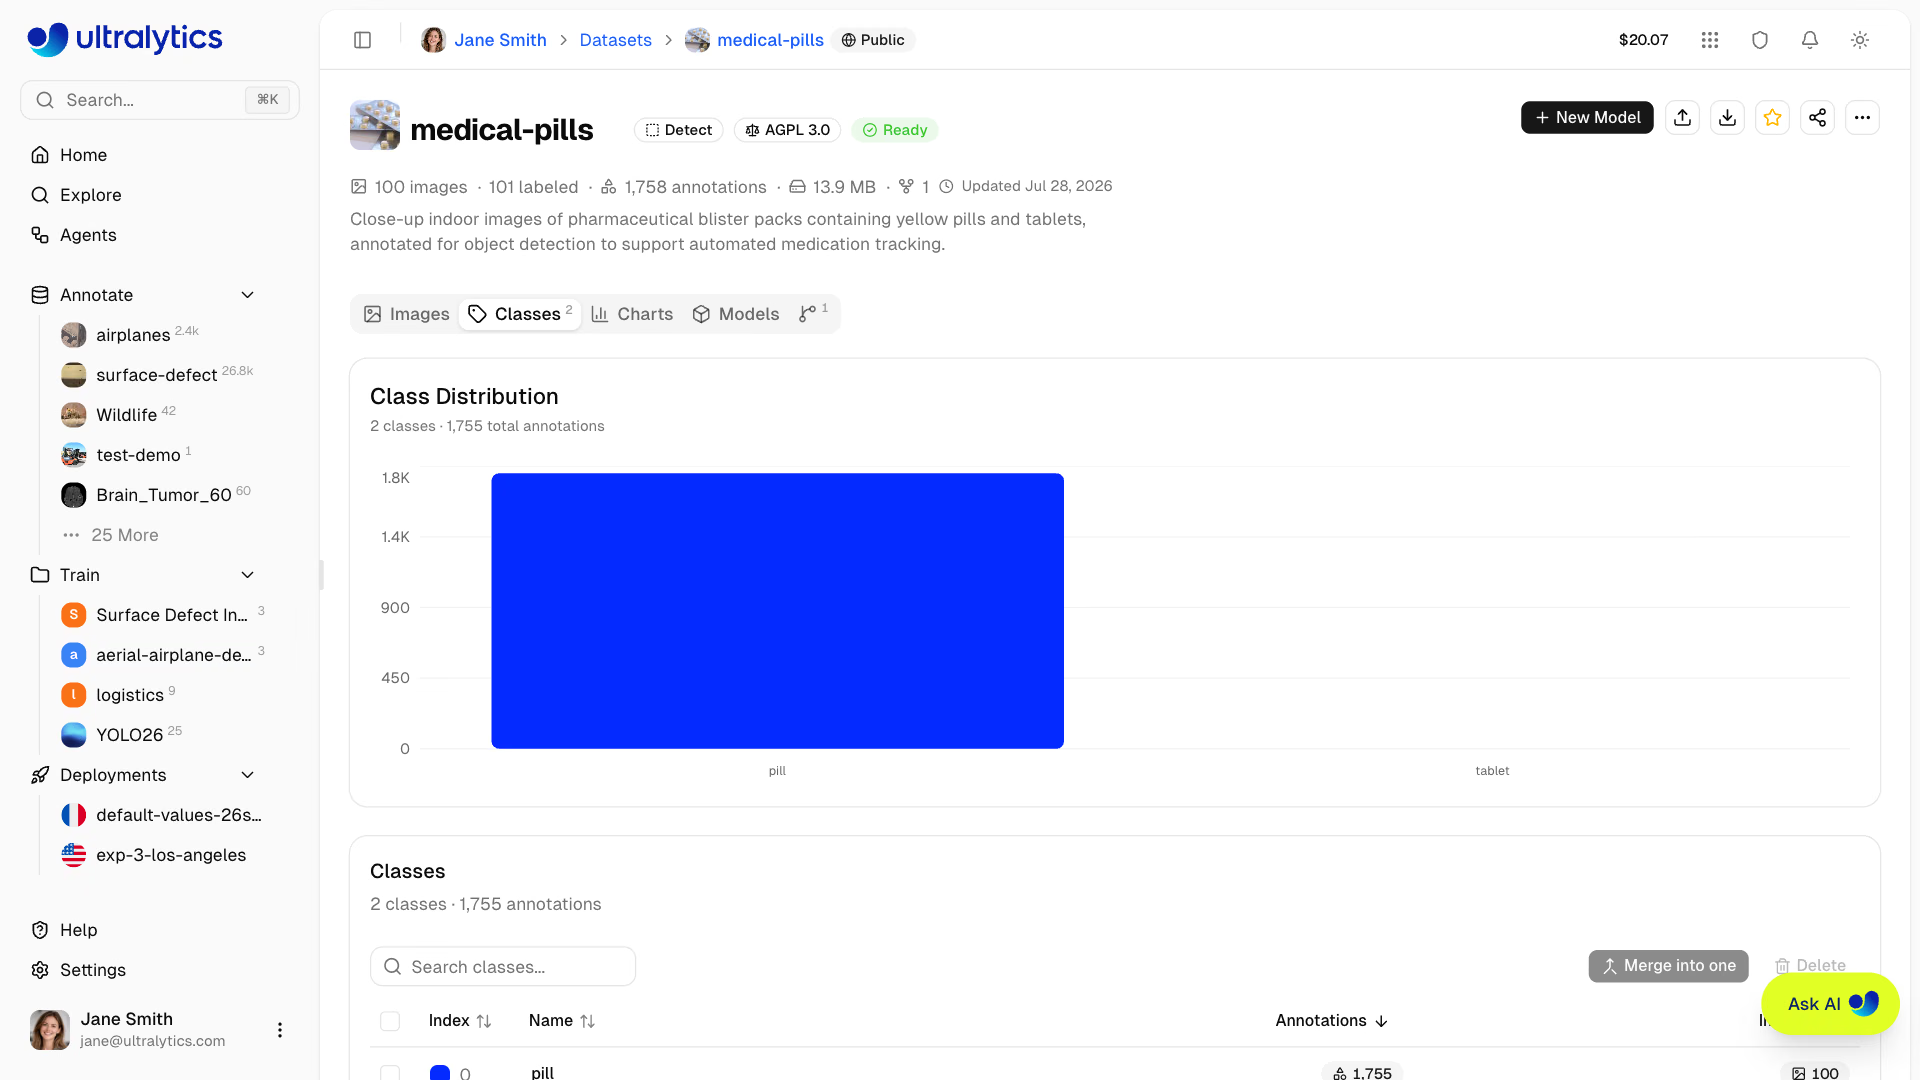
Classesタブには、ライブデータセットの同じ集計が表示されます。不均衡なデータには対数スケールを切り替えて使用できます。1つに統合すると、car、automobile、vehicleなどの重複クラスを、アノテーションを失わずに1つのクラスへまとめます。削除すると、クラスとそのすべてのアノテーションが削除されます。
汎化させる対象の単位ごとに分割する#
同じカメラ、セッション、または日に撮影されたフレームには相関があります。それらがtrainとvalの両方に含まれると、モデルはすでに見たシーンで評価されます。本番環境で変化する要素に応じて、単位全体をホールドアウトします。新しいカメラに対応する必要があるならカメラ単位で、同じカメラの別の日に対応する必要があるなら日単位でホールドアウトします。
Platformの分割ツールは、まさにこの点で異なります。
| ツール | 割り当て方法 | 用途 |
|---|---|---|
アップロード内のtrain/、val/、test/フォルダー | 指定した割り当てを維持します | オフラインで準備したグループ分割 |
| アップロード前に分割フィルターを設定 | アップロード内のすべてのファイルを、選択した分割に割り当てます | 分割ごとに1台のカメラをアップロード |
| テーブルビューの分割に移動 | 選択した画像を移動します | 特定の画像を修正 |
| 分割バーの分割を再分配 | すべての画像をランダムに再割り当てします | 独立した写真のみ |

データセットを正しく分割するレッスンでは単位の選び方を説明しています。非常に小さなデータセットでは、k分割交差検証でより多くの情報を引き出せます。アップロード後にグループを確認するには、クラス監査にグループキーを追加します(たとえば、cam07_000123.jpgという名前のファイルにはrecord["file"].split("_")[0]を使うか、画像メタデータのcameraフィールドを使います)。2つの分割にまたがっているグループをすべて報告します。
監査に合格したバージョンを固定する#
トレーニングには固定されたスナップショットが必要です。Versionsタブで説明(「v5: cam07をホールドアウト、パレット画像を80枚追加」など)を入力し、New Versionをクリックします。各バージョンは、ダウンロード、比較、復元が可能な、変更されない番号付きNDJSONスナップショットです。トレーニングダイアログのSave Dataset Versionも、トレーニング開始時に同じ操作を行い、変更がなければ一致するバージョンを再利用します。接続済みのクラウドデータセットまたはOn Premiseデータセットでは、バージョンを利用できません。
よくある落とし穴#
症状: Auto 80/20 をクリックした後、検証 mAP が急上昇する一方で、本番環境の精度は上がりません。対処法: Redistribute Splits はすべての画像をランダムに再割り当てし(その際に完全一致する重複も削除します)、隣接するフレームが train と val に分かれるようにします。グループ化されたデータには、アップロードフォルダーまたは Move to split を使用してください。
症状: 古いエクスポートやモデルの予測で、突然誤ったクラス名が表示されます。対処法: クラス ID は位置に基づくため、クラスを統合または削除すると、それより後のすべてのインデックスが 1 つずつ下がります。クラスを変更する前にバージョンを作成し、古いラベルファイルを再利用せずに再トレーニングしてください。
症状: 新しい実行のスコアが 5 ポイント下がったのに、ほかには何も変更していません。対処法: 指標を比較できるのは、同じ分割を使用している場合だけです。分割を変更したときは、その内容をバージョンの説明に記録し、比較する前に新しいバージョンでベースラインを再実行してください。
解答を表示
カメラ8台のフォークリフトデータセットでの回答例です。重複チェックで、再アップロードされたフォルダーに由来するtrainとval間の同一画像41枚が見つかるため、val側のコピーを削除します。group = record['file'].split('_')[0]を追加した監査ではcam02がtrainとvalの両方にあると分かるため、テーブルビューでcam02のval画像を選択し、分割に移動 > Trainを選びます。また、pallet: train 63, val 7, too few in valにもフラグが立つため、パレット画像2枚でFind similar imagesを実行して類似画像を未ラベルの状態で40枚追加し、ラベル付けします。その後、cam07を分割しないよう、cam07のパレット画像15枚をvalに移動します。再実行の結果は、重複0件、リークしているグループ0件、パレットのval画像22枚です。分割で色分けしたClusteringにも、混在する島は表示されません。v5: cam07 val, cam08 test, +40 palletsを保存します。