スマートアノテーションと一括ラベリング
レビュー作業量を測定してラベリングモデルと信頼度しきい値を選択し、その後、一括アノテーションを実行して編集率を確認します。
手作業でボックスを描画すると、1時間あたり100枚程度が目安です。一方、精度の高い事前ラベルをレビューする場合、数倍の速さで進められることがあります。ただし、信頼度しきい値が適切でないラベリングモデルは、削減できる作業量を上回る負担を生みます。また、レビューをしないまま使うと、次のモデルに誤りまで学習させてしまいます。このレッスンでは、実際にラベル付けされたデータを使ってしきい値ごとのレビュー作業量を測定し、勘ではなく数値に基づいてしきい値を選びます。
実践的
事前ラベル付けの3つの方法#
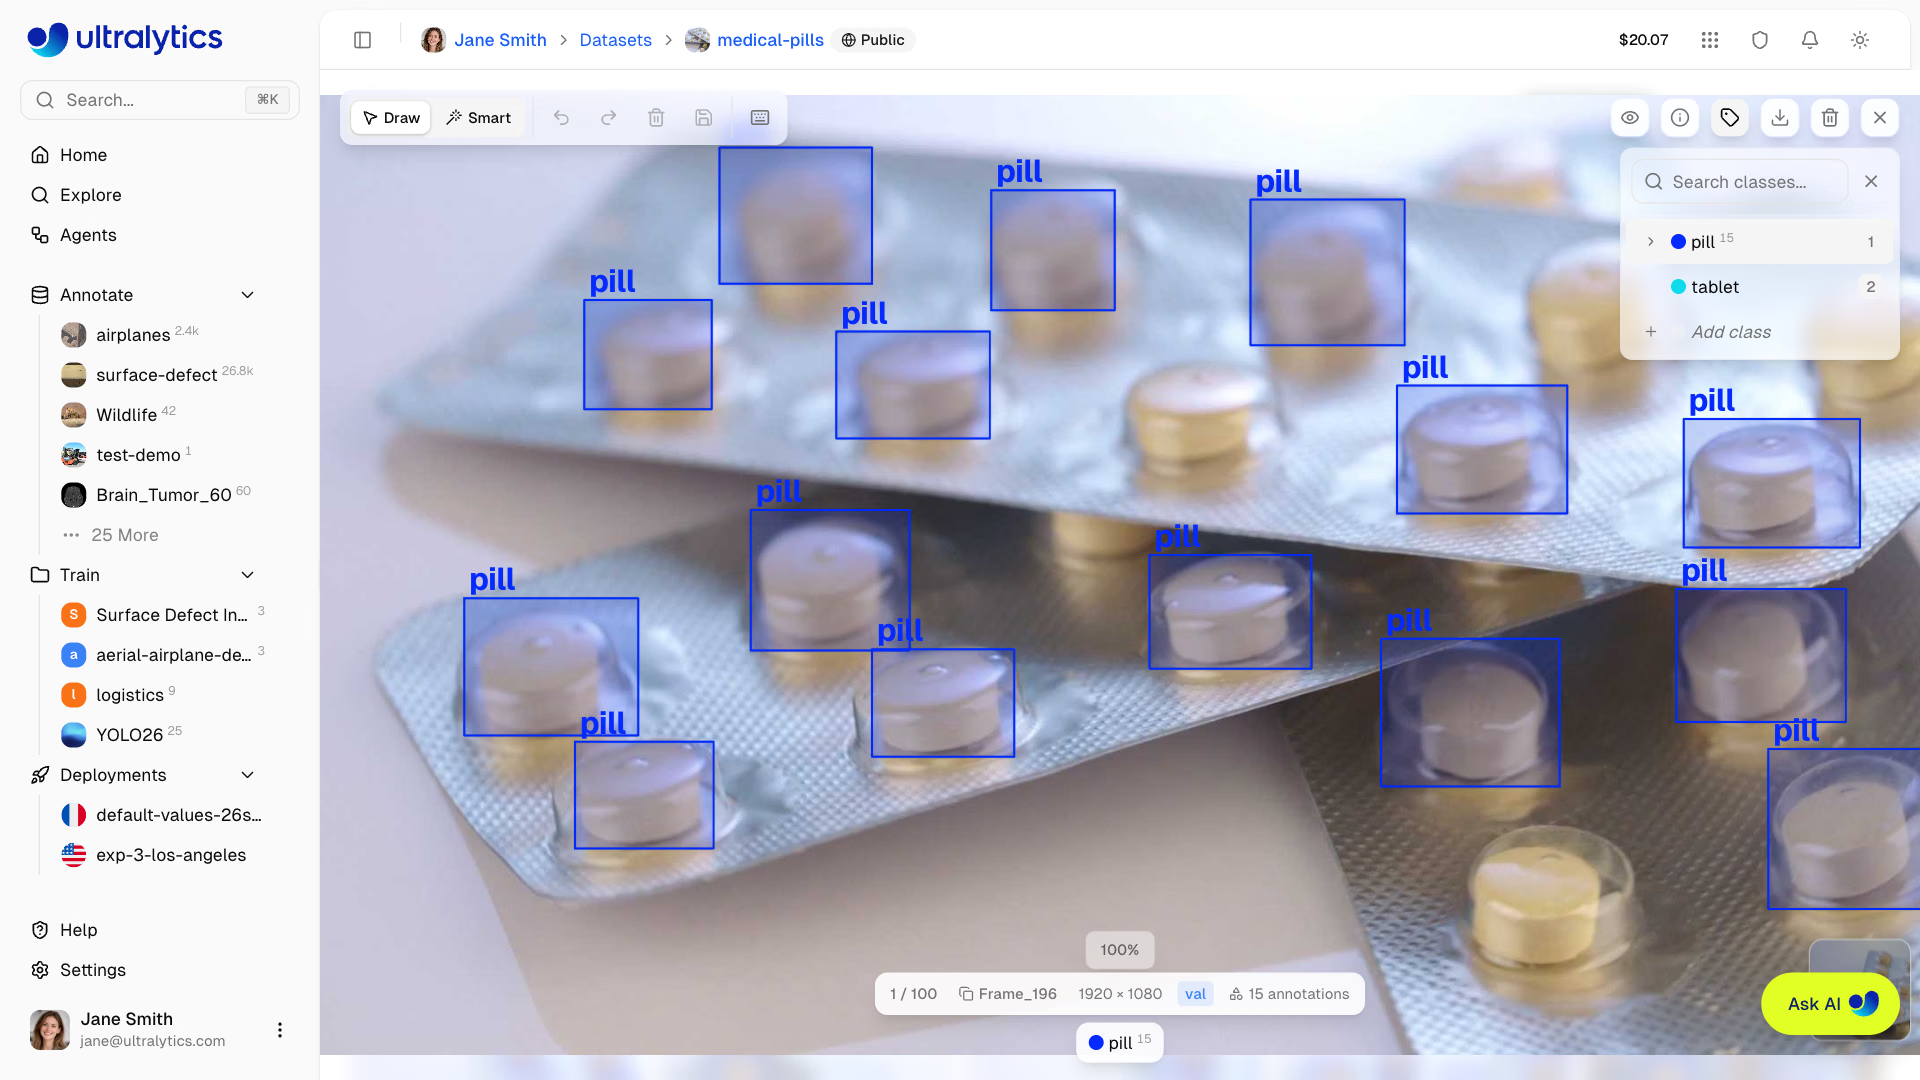
アノテーションエディターでは、Drawモード(V)は手動方式、Smartモード(S)はモデルがラベルを提案する方式です。
| ファミリー | 仕組み | タスク | 費用 |
|---|---|---|---|
| SAM(SAM 2.1 TinyからLarge、SAM 3、デフォルトはSAM 3.1) | オブジェクトをクリックしてマスクを作成します。追加するには外側を、削除するには内側をクリックします。Aで自動適用を切り替えます。 | 検出、セグメンテーション、セマンティック、OBB | Free |
| YOLO(公式モデルまたは独自モデル) | Predictでモデルの検出結果を追加します。Map classesはモデルのクラスとデータセットのクラスを対応付けます。IoUが0.7以上の重複はスキップされます。 | 検出、セグメンテーション、セマンティック、OBB、ポーズ | エディターでは無料 |
| クラスプロンプト対応(デフォルトはMoondream 3.1、YOLOE-26x、SAM 3 Textなど) | 画像内からデータセットのクラス名に該当する対象を検出します。有料のプロバイダーモデルは、自分のAPIキーを使って実行します。 | 1~200クラスの検出データセット | ホスト型モデルは無料 |
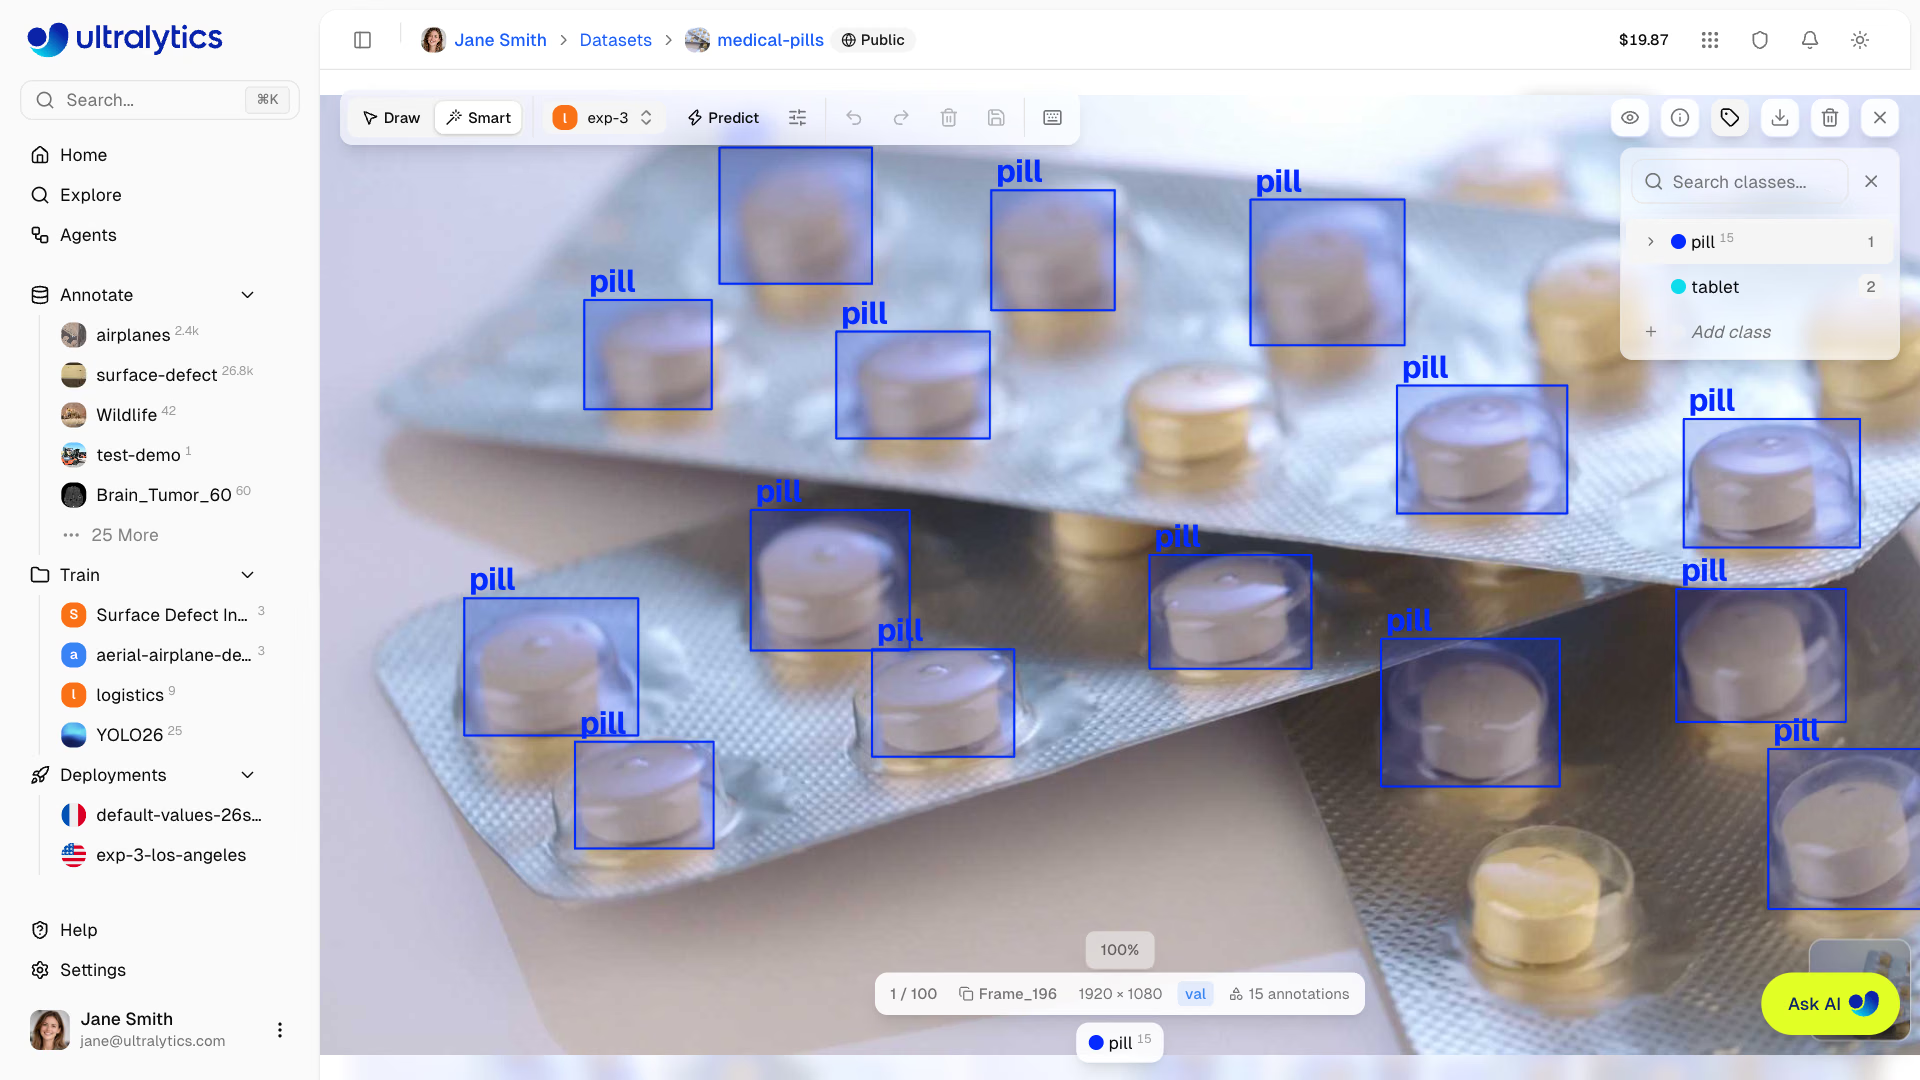
SAMはオブジェクトごとに1回クリックする必要がありますが、最も精密な形状を作成できます。モデル予測は画像ごとに1回クリックするだけですが、精度はモデル次第です。そのため、このレッスンの残りではモデルの選択と調整について説明します。
ラベリングモデルを選択する#
手作業で100~200件のラベルを付けて学習させた性能の低いv0でも、最初から描画するより有効です。v1になると、通常は有用なアクティブラーニングのパートナーになります。クラスプロンプト対応モデルの性能はドメインによって大きく異なります。一般的な写真ではほぼすべてを検出できても、PCB、X線、小売画像ではほとんどのオブジェクトを見逃すモデルもあるため、信頼する前に10件の予測を確認してください。
実例:しきい値ごとのレビュー作業量を測定する#
信頼度しきい値によって、レビュー担当者が何に時間を使うかが決まります。低すぎると誤検出ボックスの削除に、高すぎるとモデルが見逃したボックスの描画に時間を取られます。すでに正しいラベルが付いた画像で測定します。ここでは、事前学習済みYOLO26nをラベリングモデルとして、COCO128のラベル付き画像128枚を使います。
from pathlib import Path

import torch

from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset
from ultralytics.utils.metrics import box_iou
from ultralytics.utils.ops import xywhn2xyxy

data = check_det_dataset("coco128.yaml")  # 128 labeled images, downloaded on first use
images = sorted(Path(data["train"]).glob("*.jpg"))
results = YOLO("yolo26n.pt").predict(images, conf=0.05, verbose=False)  # your labeling model

def review_work(result, image, conf):
    """Return (kept, delete, draw): correct pre-labels, false positives to delete, missed objects to draw."""
    label = Path(str(image).replace("images", "labels")).with_suffix(".txt")
    lines = label.read_text().splitlines() if label.exists() else []  # no label file = background image
    gt = torch.tensor([[float(x) for x in line.split()] for line in lines]).reshape(-1, 5)
    h, w = result.orig_shape
    gt_boxes, gt_cls = xywhn2xyxy(gt[:, 1:], w=w, h=h), gt[:, 0]
    boxes = result.boxes[result.boxes.conf >= conf]
    iou = box_iou(boxes.xyxy, gt_boxes) * (boxes.cls[:, None] == gt_cls[None])  # IoU with same-class boxes only
    matched = set()
    for row in iou:  # greedily match each prediction to its best unmatched ground-truth box
        for j in row.argsort(descending=True).tolist():
            if row[j] >= 0.5 and j not in matched:
                matched.add(j)
                break
    return len(matched), len(boxes) - len(matched), len(gt) - len(matched)

print("conf  kept  delete  draw  edits/image")
for conf in (0.1, 0.25, 0.4, 0.5, 0.7):
    kept, delete, draw = (sum(t) for t in zip(*(review_work(r, i, conf) for r, i in zip(results, images))))
    print(f"{conf:<5} {kept:>4} {delete:>7} {draw:>5} {(delete + draw) / len(images):>12.1f}")
conf kept delete draw edits/image
0.1 590 490 339 6.5
0.25 468 138 461 4.7
0.4 386 58 543 4.7
0.5 328 35 601 5.0
0.7 230 6 699 5.5仕組みと結果の見方:
- モデルは低い
conf=0.05で一度だけ予測します。その後、各しきい値で同じ予測をフィルタリングするため、スイープをすばやく実行できます。 review_workは、各予測を同じクラスの正解ボックスと照合し、IoUが0.5以上のものを一致とみなします。一致しない予測はレビュー担当者が削除するボックスで、一致しない正解データはレビュー担当者が描画するオブジェクトです。- 画像あたりの編集数は0.25~0.4で最小になり、4.7です。それより低いと削除数が急増し、高いと見逃しが増えます。
- 最適なしきい値でも、レビュー担当者は画像あたり約3.6個のボックスを描画します。これは、COCOにおける小さなオブジェクトのロングテールがnanoモデルにとって難しいためです。
判断の目安:画像あたりの編集数が最も少ないしきい値を選んでください。どのしきい値でも描画が多い場合、ラベリングモデルの性能がデータに対して不十分です。より大きなモデルを使うか、ファインチューニングしたモデルを使ってください。0.5でも削除が多い場合、モデルが似たクラスを混同しています。さらにラベリングを進める前に混同行列を確認してください。自分のプロジェクトでは、すでにラベル付けした50~100枚の画像を使って、ファインチューニング済みモデルでスイープを実行してください。
一括アノテーションを実行する#
一括アノテーションは、1つのYOLOモデルまたはクラスプロンプト対応モデルでデータセット全体を処理します。その他のアクション > 一括アノテーションから開くか、エディターで予測した後に表示されるトーストですべてにアノテーションを選択します。
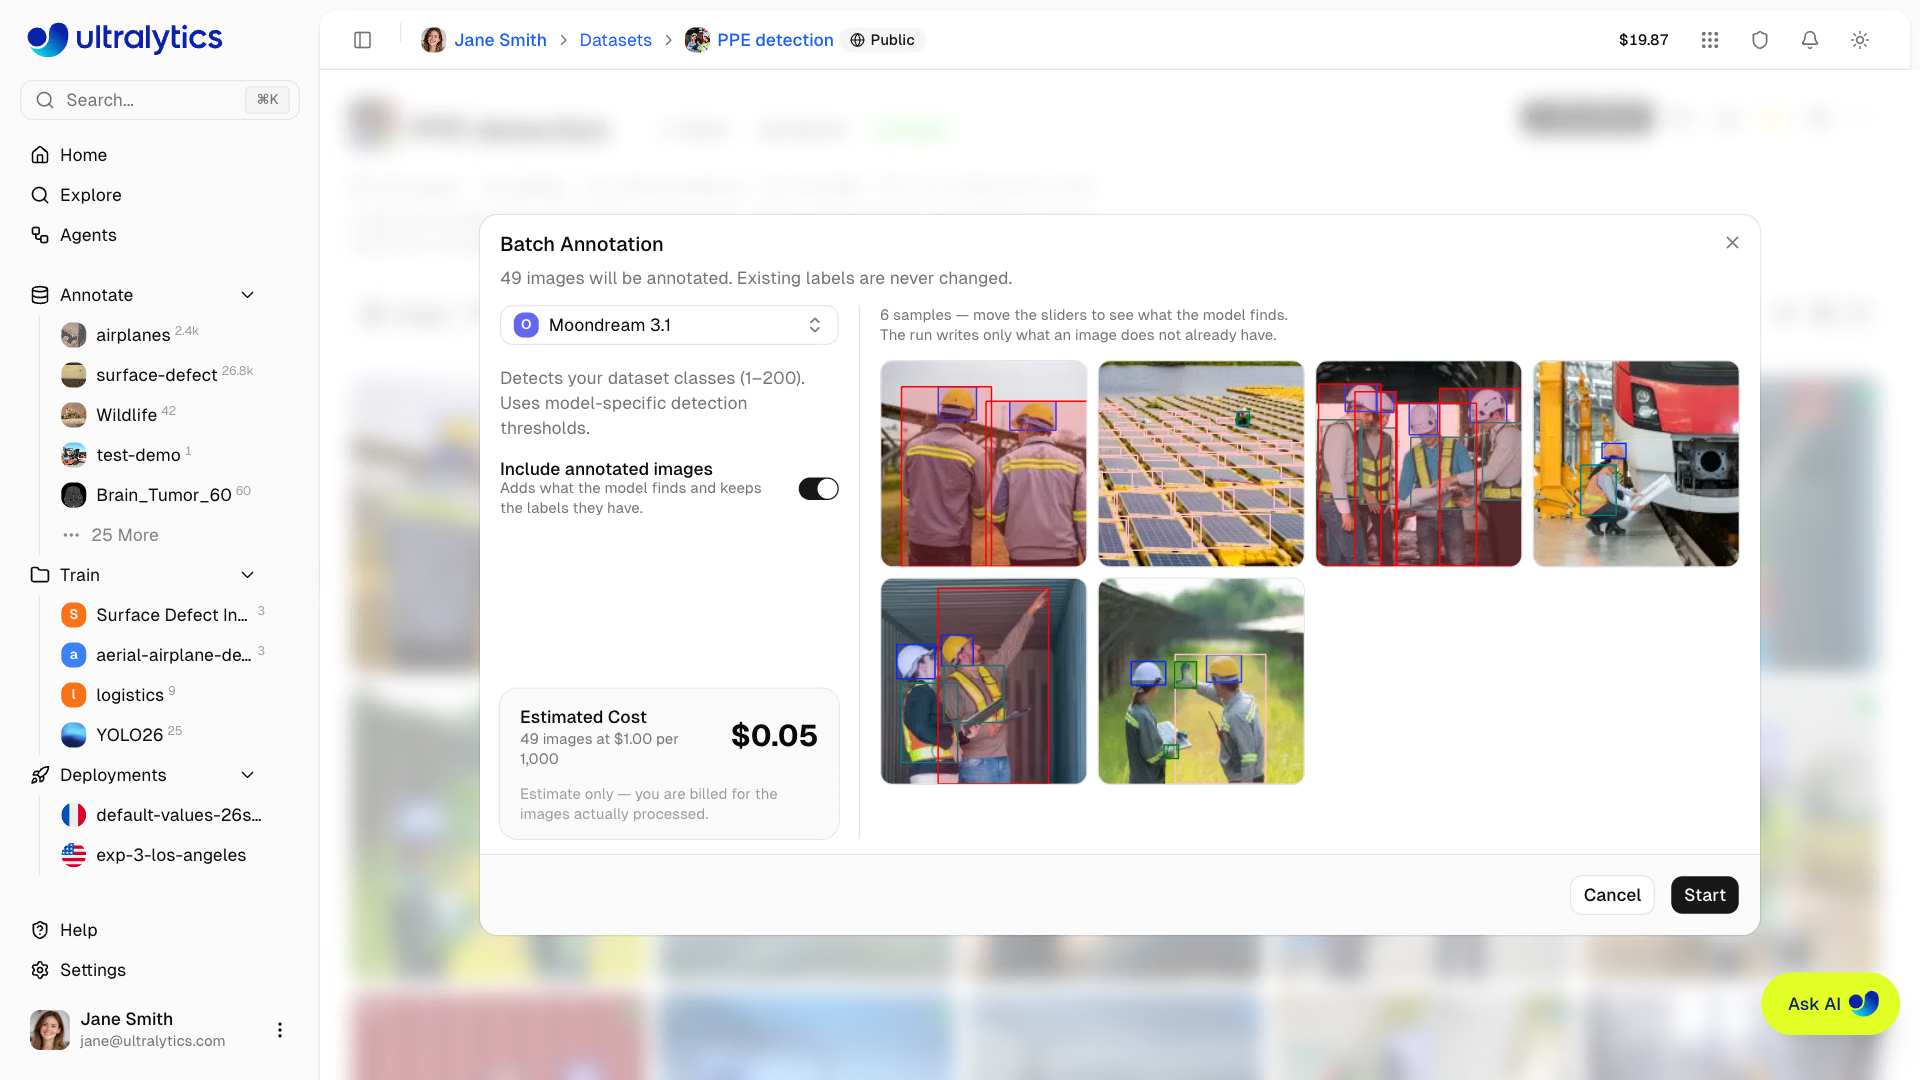
- モデルを選択します。検出データセットではMoondream 3.1が選択された状態で開くため、ファインチューニング済みモデルまたはYOLOモデルに切り替えてください。
- YOLOモデルの場合、信頼度をスイープで選んだしきい値(デフォルトは
0.25)に設定し、IoU(0.7)も設定して、サンプルのプレビューを確認してください。 - ラベルのない画像だけを対象にするには、アノテーション済み画像を含めるをオフにします。
- 推定費用(画像1,000枚あたり$1.00、最低$0.01)を確認し、開始をクリックします。
実行を開始すると、最初にデータセットのバージョンが保存されるため、実行前の状態に復元できます。停止すると、そこまでに処理された画像は保持され、課金されます。
レビューしてから編集率を測定する#
予測結果は通常のアノテーションとして追加されるため、未レビューであることを示す印はありません。クラスでフィルターして希少クラスを先に確認し、アノテーション数を昇順(見逃しの可能性が高い画像)、次に降順(ボックスが重なる可能性がある混雑したシーン)で並べ替えます。その後、バージョンを作成し、Versionsタブでバージョンを比較を開いて、比較元にv_autoを選択します。
| 件数 | 意味 |
|---|---|
| 追加 | モデルが見逃したオブジェクトと、修正した各ボックスの置き換え分 |
| 削除 | 誤検出と、修正した各ボックスの元データ分 |
| 編集率 | (追加 + 削除)÷ v_autoのアノテーション数。修正したボックスは2回カウントされるため、上限値です。 |
バッチごとに編集率を追跡してください。編集率の上昇は、新しい画像がラベリングモデルの学習済みデータから乖離し始めたことを示す早期警告です。アノテーションのベストプラクティスのレッスンでは、ラベリングガイドとレビュー担当者間の一致について説明します。
よくある落とし穴#
症状: 再学習してもスコアがほぼ変わらず、同じ物体がいつも見逃されます。 対処: レビューしていない事前ラベルを使うと、ラベリングモデルの系統的な誤りが正解としてデータセットに取り込まれます。たとえば、見た目が似たクラス、常に緩いボックスの端、まったく検出できない物体などです。学習バージョンに追加する前に、すべての画像をレビューしてください。
症状: Batch Annotationは完了しましたが、ほとんどの物体にラベルが付いていません。 対処: まず、代表的な画像を10枚使ってエディターでモデルを実行します。いくつか以上の物体を見逃す場合は、まずシードセットを手動でラベル付けし、v0を学習させます。
症状: 予測ボックスに誤ったクラス名が表示されます。対処法: モデルのクラスとデータセットのクラスが異なる場合、Map classes ステップで各モデルクラスをデータセットのクラスにマッピングするか、スキップします。慎重にマッピングしてください。誤ったマッピングをすると、そのクラスのすべてのボックスのラベルが誤って付け替えられます。
解答を表示
実例:スイープの結果、錠剤検査のファインチューニングには0.35が選ばれます。Batch Annotationでv4を保存し、1,240件のアノテーションを保持します。確認後、Compare versionsのv4 → v5では96件の追加と152件の削除が示されるため、編集率は(96 + 152) ÷ 1,240 = 20%です。削除数が追加数を上回っているため、過剰予測が発生しています。削除されたボックスを調べると、モデルがブリスターパックの反射を錠剤としてマークしていることが分かります。次の2つの対応を行います。次のバッチでは信頼度を1段階上げて(0.35 → 0.45)、編集率が下がることを確認します。また、光沢のあるパックの確認済み画像を30枚、次のトレーニングバージョンに追加し、ファインチューニングで違いを学習させます。