データセットを正しく分割する
ランダム分割によるデータ漏洩を測定し、スクリプトでクリップ、カメラ、日付などのグループ全体を分割して、クラスの網羅性を確認し、テストセットを固定します。
不注意な分割では、信頼している指標が実態を反映しなくなります。隣接する動画フレームがtrainとvalの両方に入ると、val mAPは汎化性能ではなく、記憶力を測定することになり、その差は本番環境で初めて明らかになります。モデルについて報告する数値はすべてこの分割に左右されるため、一度慎重に決めて固定してください。
実践的
3つの分割とそれぞれの役割#
| 分割 | 一般的な割合 | 用途 |
|---|---|---|
| Train | 70% | モデルがここから重みを学習します |
| Val | 15% | 最良のエポックを選び、実行を比較して、設定を調整します |
| Test | 15% | 受け入れテストに基づき、最終的な実施可否を一度だけ判断します |
Ultralyticsのガイドでは、trainを70~80%、valとtestをそれぞれ10~20%としています。CVプロジェクトの手順ではそれぞれ10~15%を提案し、前処理ガイドでは70/20/10を採用しています。画像だけでなくオブジェクト単位でも割合を数えてください。密集した画像1枚に、疎な画像10枚分より多くのラベルが含まれる場合があるためです。正確な割合よりも、それぞれの分割を何に使うかがはるかに重要です。
相関のあるデータではランダム分割によって漏洩が生じます#
同じクリップのフレーム124と125はほぼ同一です。一方がtrain、もう一方がvalに入ると、モデルが実質的にすでに見た画像でvalの評価を行うことになります。高品質で代表性のあるデータを収集するの練習用セットで測定してください。このセットのファイル名は、カメラと日付のグループキーで始まります。
import random
from pathlib import Path

images = sorted(Path("datasets/practice/images").glob("*.jpg"))
random.Random(0).shuffle(images)
train, val = images[:90], images[90:109]  # a random per-image 70/15 split

def group(image):
    return image.stem.rsplit("_", 1)[0]

shared = {group(p) for p in train} & {group(p) for p in val}
print(f"{len(shared)} of {len({group(p) for p in val})} val groups also appear in train")
13 of 13 val groups also appear in trainval内のすべてのカメラ・日付の組み合わせがtrainにも含まれています。実際の映像では、valのフレームがtrainのフレームと同じ照明や背景を共有し、同一のオブジェクトが含まれることもよくあります。そのためval mAPは高く見えても、本番環境のmAPはそうなりません。
分割単位を選ぶ#
デプロイ時に必要な汎化性能に合ったグループを選びます。
迷ったときは、許容できる範囲で最も大きな単位で分割してください。最も信頼できる数値が得られます。画像ごとのランダム分割が安全なのは、数週間の間隔を空けて撮影した製品写真のように、すべての画像が独立して撮影された場合に限られます。
コードでグループ単位に分割する#
このスクリプトは、各分割が70/15/15の割合に達するまでグループ全体を割り当て、データYAMLで使用できるファイルリストを書き出し、クラスの網羅性を報告します。
import random
from collections import Counter, defaultdict
from pathlib import Path

root = Path("datasets/practice")  # contains images/ and labels/

def group(image):
    return image.stem.rsplit("_", 1)[0]  # "cam2_2026-05-01_000124" -> "cam2_2026-05-01"

groups = defaultdict(list)
for image in sorted((root / "images").glob("*.jpg")):
    groups[group(image)].append(image)

keys = sorted(groups)
random.Random(0).shuffle(keys)  # fixed seed: the same split on every run
total, assigned = sum(len(v) for v in groups.values()), 0
splits = {"train": [], "val": [], "test": []}
for key in keys:  # assign whole groups until each split reaches its 70/15/15 share
    share = assigned / total
    splits["train" if share < 0.70 else "val" if share < 0.85 else "test"] += groups[key]
    assigned += len(groups[key])

counts = {}
for split, images in splits.items():
    (root / f"{split}.txt").write_text("".join(f"./images/{p.name}\n" for p in images))
    labels = [root / "labels" / f"{p.stem}.txt" for p in images]
    counts[split] = Counter(int(r.split()[0]) for f in labels if f.exists() for r in f.read_text().splitlines() if r.strip())

all_classes = set().union(*counts.values())
for split, images in splits.items():
    missing = len(all_classes - set(counts[split]))
    print(f"{split:>5}: {len(images):3d} images, {len({group(p) for p in images}):2d} groups, {missing} of {len(all_classes)} classes missing")
train: 90 images, 11 groups, 5 of 71 classes missing
val: 20 images, 2 groups, 36 of 71 classes missing
test: 18 images, 3 groups, 41 of 71 classes missing結果の読み方:
- 構成上、グループが分割をまたぐことはありません。これで漏洩を防げます。
- valには2つのグループしかなく、36クラスが含まれないため、それらのAPは測定できません。128枚の画像に71クラスがある場合、シードを変えても解決しません。本当の解決策はグループ(カメラや日付)を増やすことです。これを実現するのが、1クラスあたり1,500枚以上の画像を含む本番用データセットです。
- trainには5クラスが含まれていません。これらのクラスはvalまたはtestにしかないため、モデルはこの分割から学習できません。
判断基準は、ある分割にクラスが含まれていない場合、単一フレームではなく、そのクラスを含むグループ全体を追加または移動することです。単一フレームを動かすと漏洩が再発します。データYAMLのtrain、val、testキーを、3つの.txtファイルに設定してください。ファイルの残りの部分については、データセットYAMLを書くを参照してください。
分割間でクラスのバランスを取る#
分類では、scikit-learnのtrain_test_split(..., stratify=labels)を使うと、1つの引数で分割間のクラス比率を均等にできます。検出画像には複数のクラスが含まれるため、代わりにグループ単位でバランスを取ります。group_split.pyの実行後、分割ごとのクラス数を比較し、各クラスが期待される割合の約±20%以内に収まるまでグループ全体を入れ替えます。

Ultralytics PlatformのRedistribute Splitsは画像をランダムに再割り当てし、Autoは推奨される80/20のtrain/val分割を設定します(分割のドキュメント)。処理中に完全一致する重複画像は削除されますが、グループは認識されません。そのため、独立した撮影画像に使用し、動画や複数カメラのデータではグループ単位で分割してアップロードしてください。
2つのvalセットを別々に追跡する#
安定したキュレーション済みの回帰テストセットと、新たに収集したフレームに応じて更新される本番環境に即したセットの2つを、valセットとして使うことがよくあります。データYAMLには複数のvalフォルダーを指定できますが、1つのスコアを出す単一のvalセットに統合されます。
path: ./datasets/forklift
train: images/train
val:
  - images/val_curated      # stable, your regression suite
  - images/val_production   # rotates with newly collected frames
test: images/testそれぞれのスコアを確認するには、valセットごとにデータYAMLを1つ用意し(trainとnamesは同じで、valは異なります)、学習済みの重みをそれぞれに対して検証します。
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")  # your fine-tuned checkpoint
for data in ("val_curated.yaml", "val_production.yaml"):
    metrics = model.val(data=data)
    print(f"{data:<20} mAP50-95={metrics.box.map:.3f}")
キュレーション済みセットでの低下は回帰、本番セットでの低下はドメインシフトを示します。
テストセットを固定する#
分割に関する最も重大な誤りは、テストセットで10種類のモデルを比較することです。テスト結果が何らかの判断に影響した時点で、最終的な数値は楽観的になります。すべての調整と実行の比較は検証データで行い、受け入れテストは最後に1回だけテストデータで実行します。
公開する指標はすべて、この分割に基づきます。後から再シャッフルすると数値がすべて変わり、過去と現在の実行を比較できなくなります。分割単位、シード、3つのファイルリストをデータセットと一緒に保管します。
小規模データセット向けのK分割交差検証#
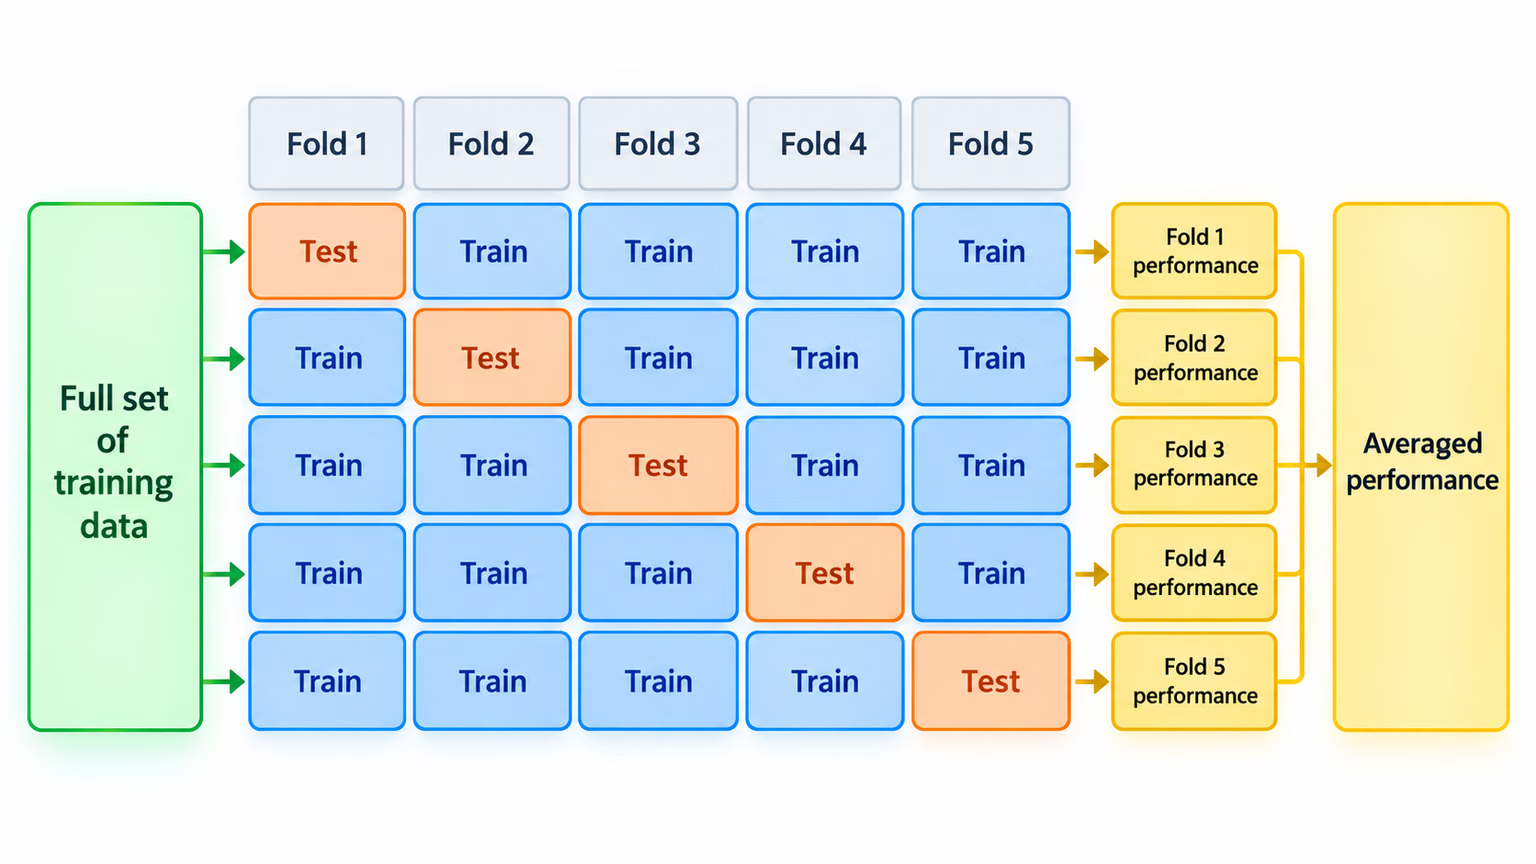
データセットが小さく(クラスあたり約500枚未満)、単一の分割では統計的な信頼性が不十分に感じられる場合、K分割交差検証では分割を入れ替えながらk個のモデルを学習し、結果を平均します。計算量はk倍になりますが、より安定した推定値が得られます。同じ方法でグループからfoldを作成してください。そうしないと、すべてのfoldで漏洩が生じます。
解答を表示
新しい日付のデータでも稼働し続ける必要がある固定式の倉庫カメラでは、カメラと日付の組み合わせで分割します:cam2_2026-05-01。group_split.pyの実行後、グループが分割境界をまたいでいないことを確認します。
from pathlib import Path

root = Path("datasets/practice")
groups = {s: {Path(p).stem.rsplit("_", 1)[0] for p in (root / f"{s}.txt").read_text().split()} for s in ("train", "val", "test")}
print("train & val: ", groups["train"] & groups["val"] or "none")
print("train & test:", groups["train"] & groups["test"] or "none")
print("val & test:  ", groups["val"] & groups["test"] or "none")
train & val: none
train & test: none
val & test: none練習用の分割は漏洩チェックに合格していますが、網羅性チェックには不合格です。valには71クラス中36クラスが含まれていません。必要なのは再シャッフルではなく、データ収集計画です。valとtest用に少なくとも2つのカメラ・日付の組み合わせを追加で撮影し、それぞれ仕様で特に重視されるクラスを網羅してから、両方のスクリプトを再実行してください。