データセットの準備が整ったかを判断する
8つの合否チェックを通過してから初回の学習を実行し、スクリプトで検証できる3項目を自動化し、各項目が不合格の場合に必要な修正を把握します。
どのプロジェクトでも、チームが学習を始めたくなる段階に到達します。データセットの準備が整っている場合もあれば、データ分割のリークやラベル付けが不足したクラスが残っている場合もあります。後者はGPU時間を1週間無駄にし、信頼できない数値を生み出しかねません。各項目を「はい」「いいえ」または「例外を文書化済み」で評価する8つのチェックにより、気分ではなく客観的に判断できます。
実践的
8つのチェック項目#
| # | チェック項目 | 合格基準 | 不合格の場合の参照先 |
|---|---|---|---|
| 1 | 明確な目標 | 目標、タスク、クラス、受け入れテストが文書化され、合意されています | ビジネス目標から始める |
| 2 | 定義済みのクラス | 各クラスに定義があり、除外する類似クラスが明記されています | 目標とラベル付けガイド |
| 3 | 代表性のある画像 | 仕様書にある各シナリオの必要枚数を満たし、その大半が実運用のデータソースから収集されています | 高品質で代表性のあるデータを収集する |
| 4 | 十分なデータ量 | クラスごとに画像が1,500枚以上、インスタンスが10,000件以上、または例外が文書化されています | 仕様とデータ収集 |
| 5 | 一貫したラベル | ガイドが作成され、キャリブレーションを実施済みで、一致率が90%以上です | アノテーションのベストプラクティス |
| 6 | 品質管理の完了 | 監査スクリプトに問題がなく、要確認箇所を確認済みで、品質管理の記録が作成されています | データセットの品質管理 |
| 7 | クリーンなデータ分割 | グループ単位で分割し、複数の分割にまたがるグループがなく、すべての分割に各クラスが含まれています | データセットを正しく分割する |
| 8 | 背景画像 | ラベルが空のフレームが画像全体の0~10%です | 仕様とデータ収集 |
このチェックリストは、データ収集とアノテーションのガイドで1項目ずつ扱う判断事項を、単一の実行可否判断にまとめたものです。
数値で確認できる項目を自動化する#
チェック項目4、7、8は数値計算で判定できるため、スクリプトを使えば毎回同じ方法で評価できます。次のスクリプトは、練習用データセットと、前のレッスンでgroup_split.pyが作成したデータ分割リストを読み込みます。
from collections import Counter
from pathlib import Path

root = Path("datasets/practice")  # images/, labels/, and the train/val/test.txt lists from group_split.py
splits = {s: [Path(p).stem for p in (root / f"{s}.txt").read_text().split()] for s in ("train", "val", "test")}

def classes(stem):
    label = root / "labels" / f"{stem}.txt"
    return [int(r.split()[0]) for r in label.read_text().splitlines() if r.strip()] if label.exists() else []

stems = [s for split in splits.values() for s in split]
instances = Counter(c for s in stems for c in classes(s))
images = Counter(c for s in stems for c in set(classes(s)))
background = sum(not classes(s) for s in stems) / len(stems)
groups = {split: {s.rsplit("_", 1)[0] for s in names} for split, names in splits.items()}
per_split = {split: {c for s in names for c in classes(s)} for split, names in splits.items()}
shared = (groups["train"] & groups["val"]) | (groups["train"] & groups["test"]) | (groups["val"] & groups["test"])
weakest = min(instances, key=lambda c: (images[c], instances[c]))

checks = {
    "4 volume": (images[weakest] >= 1500 and instances[weakest] >= 10_000,
                 f"weakest class {weakest}: {images[weakest]} images, {instances[weakest]} instances"),
    "7 no shared groups": (not shared, f"{len(shared)} groups appear in more than one split"),
    "7 every class in every split": (all(per_split[s] == set(instances) for s in splits),
                                     ", ".join(f"{s} misses {len(set(instances) - per_split[s])}" for s in splits)),
    "8 background 0-10%": (background <= 0.10, f"{background:.1%} background images"),
}
for name, (ok, detail) in checks.items():
    print(f"{'PASS' if ok else 'FAIL'}  {name:<29} {detail}")
FAIL 4 volume weakest class 30: 1 images, 1 instances
PASS 7 no shared groups 0 groups appear in more than one split
FAIL 7 every class in every split train misses 5, val misses 36, test misses 41
PASS 8 background 0-10% 1.6% background imagesグループ単位の分割でリークは解消しましたが、練習用データセットは準備が整った状態にはほど遠いものです。最も弱いクラス(30、skis)にはラベル付きインスタンスが1件しかなく、valではクラスの半数を評価できません。これはデモ用の128枚の画像に対する想定どおりの判定であり、1週間の学習を始める前にこのチェックが明らかにするべき結果です。
スクリプトで確認できるのは、数値化できる項目です。チェック項目1、2、3、5、6には人の確認が必要です。合意された目的、文書化された定義、仕様の網羅性、測定された一致度、QCの記録が該当します。それぞれを1行の根拠とともに手作業で評価します。
判断:学習する、課題を残して出荷する、または修正する#
チェックに不合格となったとき、データを修正する以外の方法を次の手段として選びたくなりがちです。
| 手軽に見える方法 | うまくいかない理由 |
|---|---|
| 「もっと大きなモデルを試す。」 | 大きなモデルも、ラベルノイズを同じように忠実に学習します。 |
| 「学習率を調整する。」 | どのオプティマイザー設定でも、欠落したクラスやシナリオは追加できません。 |
| 「エポック数を増やして学習する。」 | データの範囲が狭いままエポック数を増やすと、過学習が早まります。 |
| 「データ拡張を追加する。」 | データに存在しないシナリオを、データ拡張で作り出すことはできません。 |
準備がほぼ整っている場合の3つのパターン#
| パターン | 不合格となるチェック項目 | 状態 | 対策 |
|---|---|---|---|
| 多いが、多様性がない | 3 | 画像は5,000枚あるものの、カメラは1台で、エッジケースがありません | 学習前に、より多くのカメラ、場所、時間帯からデータを収集します |
| 多様だが、一貫性がない | 5 | アノテーター間でボックスの範囲やオクルージョンの判断が一致していません | ガイドを完成させ、キャリブレーションを行い、影響を受けるサンプルにラベルを付け直します |
| 気づきにくいリーク | 7 | 動画フレームを画像単位でランダムに分割しています | クリップ、カメラ、または日ごとに再分割してください。val mAPは低下すると見込んでください。その低下が現実を反映しているためです |
既知のギャップを残してリリースする#
すべてのチェックが合格する前に、パイロット、プロトタイプ、または一部のカメラを対象としたv1など、範囲を絞った最初のモデルを作るのが適切な場合がよくあります。モデルを本番環境に導入すると、データセットを手探りで磨き込むよりも、実際の問題をすばやく把握できます。ギャップを残してリリースする場合は、次の3点を記録してください。
- どのチェックに失敗したか。
- 想定される影響。たとえば「夜間のデータがないため、暗くなってからは再現率が低下する見込みです」などです。
- v1の稼働中にギャップを解消するためのデータ収集計画。
「数量: 例外」では、次の担当者に何も伝わりません。「数量: palletは700インスタンスで、混雑した通路ではパレットの再現率が低くなる見込み。6月までに2,000件を追加でラベル付け」は、管理されたリスクです。すべての例外に、受け入れテストへの予想される影響を記載します。
再トレーニングの前に毎回再実行する#
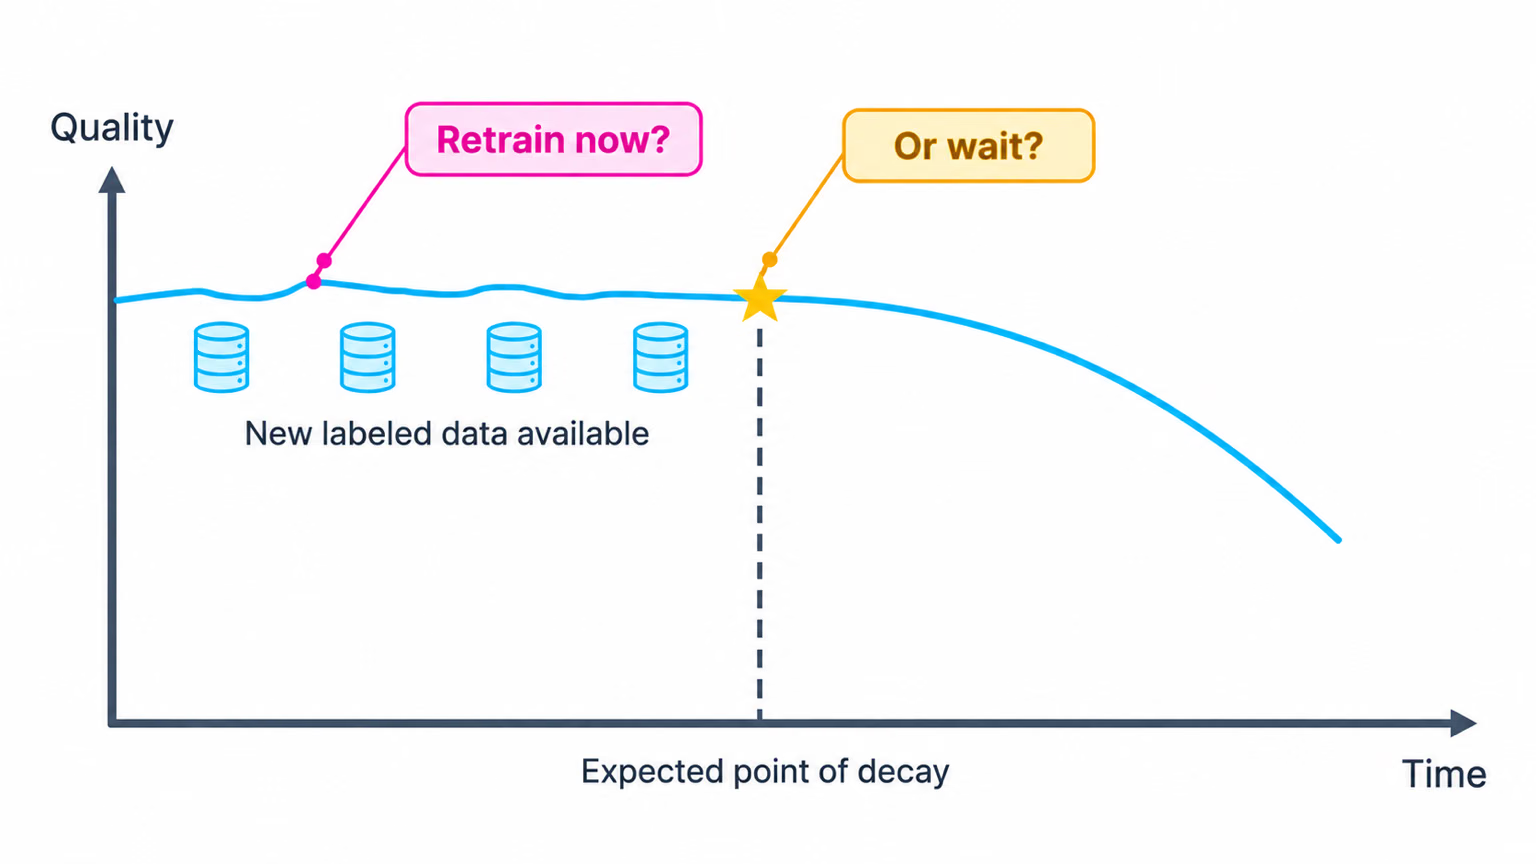
v1に適していたデータセットが、自動的にv3にも適しているとは限りません。新しいクラス、新しいデータソース、新しいアノテーターは、それぞれ以前は合格していたチェックを不合格にする可能性があります。また、新しいラベルが増える間にも本番データはドリフトします。再トレーニングの前に毎回readiness.pyを再実行し、手動チェックを再採点してください。数分で済みますが、これを省略すると、壊れたデータセットで1週間トレーニングすることになりかねません。
解答を表示
練習用セットの採点済みチェックリスト:
| # | チェック項目 | スコア | 根拠 |
|---|---|---|---|
| 1 | 明確な目的 | はい | レッスン1のobjective.mdとacceptance_test.py |
| 2 | 定義済みのクラス | いいえ | COCOの80クラス名には、文書化された定義も、除外する類似対象もありません |
| 3 | 代表性のある画像 | いいえ | coverage.py:cam2~cam4が必要数を下回っています |
| 4 | 十分なデータ量 | いいえ | readiness.py:最も少ないクラスの画像は1枚です |
| 5 | 一貫性のあるラベル | いいえ | キャリブレーションラウンドでの一致率は47%です |
| 6 | QC完了 | 一部完了 | 監査を実施済み。000000000438.jpgの要確認項目は未解決です |
| 7 | 適切なデータ分割 | いいえ | 共有グループはありませんが、valでは71クラス中36クラスが欠落しています |
| 8 | 背景画像 | はい | 1.6% |
判断:先に修正します。受け入れテストへのリスクが高い順に、(1) 目的に必要なクラスにクラス一覧を絞り、チェック2、4、7をまとめて軽減します。(2) それらのクラスについて、より多くのグループを収集します。(3) 遠方の人物に関するガイドのルールを完成させ、ラベルを付け直します。デモ用セットはこのチェックに不合格になりますし、不合格になるべきです。