可観測性とドリフト
気付かれにくい精度低下を検出する指標を記録し、ドリフトについて信頼度分布をテストし、対応可能なシグナルだけにアラートを設定します。
ビジョンサービスは稼働し、高速に動作していても、誤った結果を返すことがあります。カメラの位置がずれたり、照明が変わったり、新しい製品ラインが追加されたりしても、モデルはボックスを返し続け、インフラのダッシュボードはすべて正常なままです。このレッスンでは、夕暮れを再現するためにクリップを暗くしたところ、平均信頼度はわずか0.01しか変化せず、グラフでは見えませんでしたが、2標本KS検定ではp = 0.007で検出されました。この検査と、その検査に使うログを構築します。
実践的
シグナルの3つのレイヤー#
| レイヤー | 質問 | シグナル |
|---|---|---|
| インフラ | サービスは稼働し、処理が追いついていますか? | レイテンシ、スループット、ドロップフレーム数、CPUとGPUの使用率 |
| モデルの動作 | モデルは先週と同じように動作していますか? | フレームあたりの検出数、平均信頼度、クラス構成、ボックスのサイズ |
| モデルの精度 | モデルは引き続き正しい結果を出していますか? | ホールドアウトデータのmAP(性能指標)、人手によるサンプルレビュー、誤警報率 |
多くのチームは標準的なツールで最初のレイヤーに対応しただけで終わります。ビジョンシステムが気付かれずに失敗するのは、2番目と3番目のレイヤーです。モデルモニタリングガイドでは、メンテナンスの全サイクルを解説しています。
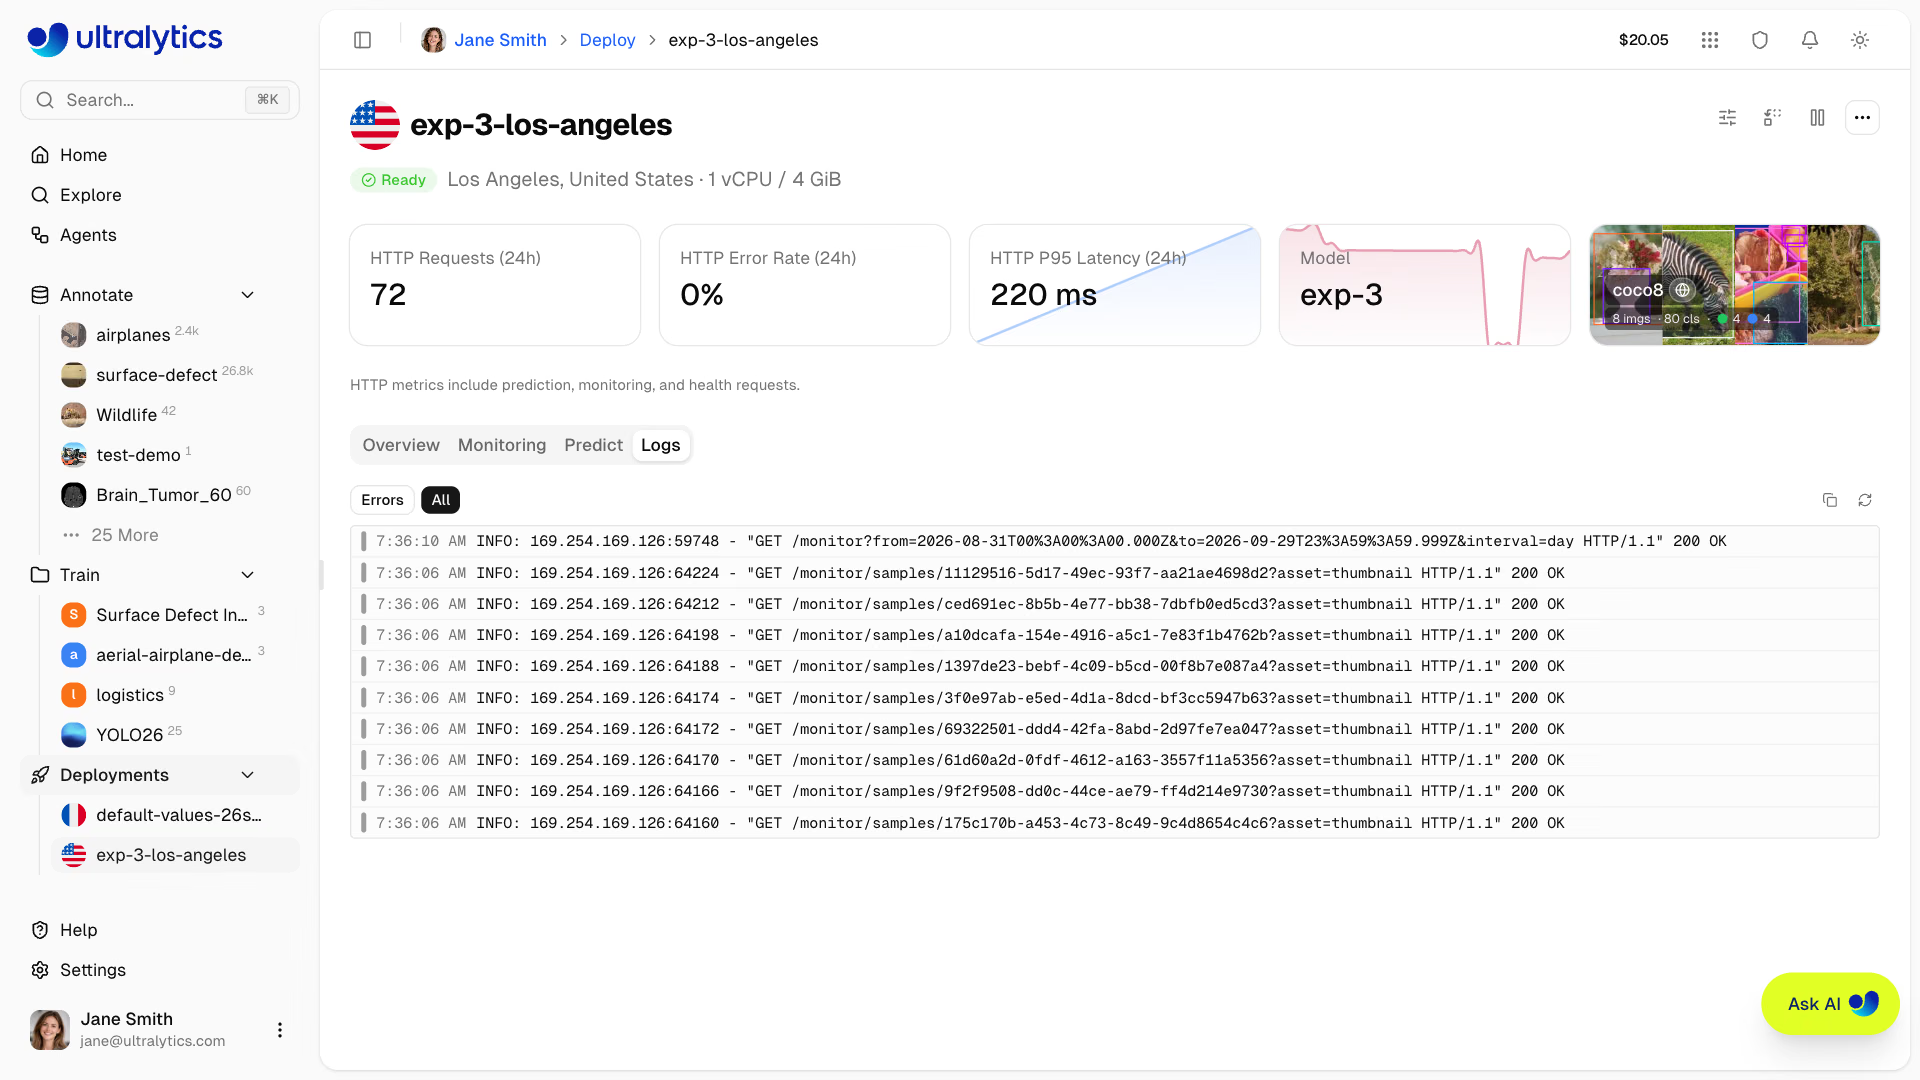
Ultralytics Platform経由でデプロイする場合、デプロイページではインフラレイヤー(リクエスト数、エラー率、P95レイテンシ)と、上の例のようにエラーでフィルタリングできるリクエストログを確認できます。これらについてはヘルスと精度のモニタリングのレッスンで解説しています。動作と精度のレイヤーは自分で構築する必要があり、このレッスンの残りの部分ではその方法を説明します。
フレームごとの指標を出力する#
各Resultsオブジェクトには、タイミング情報とボックスが含まれています。フレームごとにJSONを1行書き込み、使用している指標システムに送信します。
import json
import time

from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
with open("metrics.jsonl", "w") as log:
    for r in model.predict(video, stream=True, verbose=False):
        conf = r.boxes.conf
        record = {
            "ts": time.time(),
            "camera": "lobby-1",
            "inference_ms": round(r.speed["inference"], 1),
            "detections": len(r.boxes),
            "mean_conf": round(conf.mean().item(), 3) if len(conf) else None,
            "confs": [round(c, 3) for c in conf.tolist()],  # ドリフト検定用の生データ
        }
        log.write(json.dumps(record) + "\n")
print({k: v for k, v in record.items() if k != "confs"})
{'ts': 1792003254.33, 'camera': 'lobby-1', 'inference_ms': 34.7, 'detections': 22, 'mean_conf': 0.543}各フィールドの用途:
- inference_ms: p95が予算を超えた場合にアラートを発報します。
- detections: 急にほぼゼロまで減少した場合は、カメラが遮断されているか故障している可能性があります。急増した場合は、シーンの変化または誤検出を示しています。
- mean_conf: 迅速に傾向を把握できますが、これだけではドリフトを検出するには粗すぎます。
- confs: ドリフトテストで必要となる全分布です。
信頼度分布のドリフトをテストする#
データドリフトは、新しいデータに誰かがラベルを付けるずっと前から、信頼度に現れます。起動時に信頼度を収集してベースラインとし、直近のウィンドウを収集して、2標本コルモゴロフ・スミルノフ検定(pip install scipy)で2つの分布を比較します。このスクリプトは、同じクリップを暗くして夕暮れをシミュレートします:
import cv2
import numpy as np
from scipy.stats import ks_2samp

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

model = YOLO("yolo26n.pt")
video = str(safe_download("https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"))

def confidences(darken=1.0):
    """Collect every detection confidence from the clip, optionally darkened to simulate dusk."""
    cap, out = cv2.VideoCapture(video), []
    while True:
        ok, frame = cap.read()
        if not ok:
            break
        out += model((frame * darken).astype(np.uint8), verbose=False)[0].boxes.conf.tolist()
    return np.array(out)

baseline = confidences()  # what "normal" looked like at launch
for name, recent in (("same scene", confidences()), ("dusk (35% brightness)", confidences(darken=0.35))):
    stat, p = ks_2samp(baseline, recent)
    print(f"{name:22s} n={len(recent):4d} mean_conf={recent.mean():.3f} KS={stat:.3f} p={p:.2g}")
same scene n=1376 mean_conf=0.519 KS=0.000 p=1
dusk (35% brightness) n=1337 mean_conf=0.508 KS=0.064 p=0.0068行ごとに確認します。
- 同じシーン: 分布が同一ならKS統計量は0、p = 1となり、対照条件を示します。
- 夕暮れ: 検出数が39件減少し、平均値はわずか0.011低下します。グラフを見ても誰も気づかない差です。KS統計量(2つの累積分布間の最大差)は0.064で、p = 0.0068 < 0.01は変化が実際に生じていることを示します。
ドリフトアラートはサンプルフレームを確認するきっかけであり、障害の証明ではありません。実際にドリフトがある場合は、影響を受けたカメラのフレームを収集してラベルを付けます。データ収集とアノテーションのガイドでは収集対象を、ファインチューニングのガイドでは再トレーニングの方法を説明しています。バウンディングボックスのサイズ(幅 × 高さ)も手軽なドリフト指標となり、新しい取り付け位置や光学系の変化が最初に現れます。
ホールドアウトセットを毎週検証する#
挙動のシグナルから変化は分かりますが、精度が低下したかどうかを示すのはラベルだけです。ラベル付きの本番画像200~500枚からなるホールドアウトセットを用意し、すべてのモデルバージョンで、さらに毎週検証します。
yolo val model=yolo26n.pt data=coco8.yaml > weekly_metrics.txt # use your production model and holdout YAMLmAP50-95とクラスごとのAPを継続的に記録し、週ごとにmAPが1ポイントを超えて低下した場合にアラートを発報します。最もよくある原因は、変更なしのはずのモデル切り替えで、次に多いのがドリフトです。同じホールドアウトセットの混同行列を使うと、クラスごとの性能低下が明確になります。
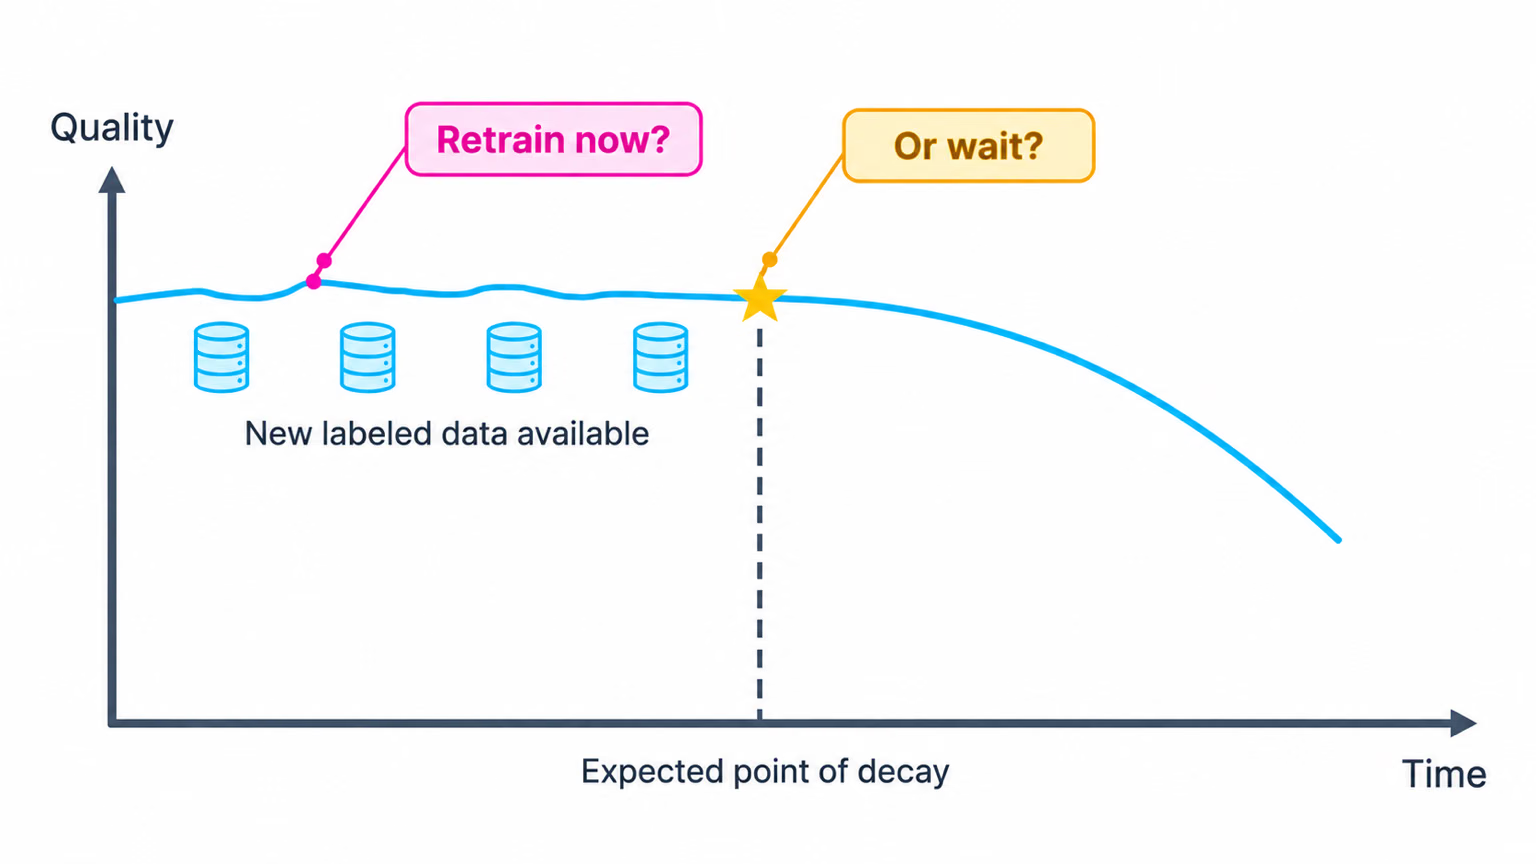
このグラフの問いに答えるのがホールドアウトセットです。品質が低下し始めたことが示された場合、またはドリフトした条件下で新たにラベル付けされたデータが十分に集まった場合に再トレーニングします。固定スケジュールには従いません。
数値ではなくアクションを基準にアラートを設定する#
| シグナル | 発報条件 | 対応 |
|---|---|---|
p95 inference_ms | 3分以上、予算を超過 | スケールアウトするか、最適化済みのエクスポートに切り替える |
| フレームあたりの検出数 | 5分間、50%以上低下 | カメラ映像を確認し、その後モデルバージョンを確認する |
| ドロップしたフレーム | 10分間、5%を超過 | 容量を増やすか、ストリームごとのFPSを下げる |
| 信頼度のKS検定 | 日次ウィンドウでp < 0.01 | フレームを確認し、その後ホールドアウトセットを実行する |
| ホールドアウトのmAP50-95 | 週ごとに1ポイント以上低下 | データを収集してラベルを付け、ファインチューニングする |
よくある落とし穴#
症状: KS検定が毎晩、毎週月曜日に反応します。 対処: 日次・週次の周期は実際の分布変化です。同じ条件(カメラ、時間帯、曜日)で比較し、数千件の検出を含む時間窓を使用します。
症状: ホールドアウトのmAPは良好なのに、ユーザーから見逃しの報告があります。 対処: ホールドアウトデータは現在の本番環境に似たものである必要があります。重要なカメラから新たにラベル付けしたフレームを追加し、四半期ごとに更新します。
すべてのアラートに、実行すべき次のアクションを明記してください。監視するだけでよいシグナルは、ページャーではなくダッシュボードに表示します。
解答を表示
monitor.pyの最初の正常な出力ウィンドウをbaseline.jsonlとして保持し、新しい各ウィンドウと比較します:
import json

import numpy as np
from scipy.stats import ks_2samp

def load(path):
    """Flatten the per-frame 'confs' lists written by monitor.py."""
    with open(path) as f:
        return np.array([c for line in f for c in json.loads(line)["confs"]])

baseline, recent = load("baseline.jsonl"), load("metrics.jsonl")
stat, p = ks_2samp(baseline, recent)
print(f"KS={stat:.3f} p={p:.2g} -> {'review frames' if p < 0.01 else 'ok'}")
KS=0.000 p=1 -> ok両方のファイルが同じ映像から作成されている場合、これは想定どおりの結果です。スケジューラーから毎日実行し、統計量とp値をフレームごとのログと同じメトリクスシステムに送信します。review framesはページャーではなく担当者に通知します。