CPUでOpenVINOを使用する
FP32、FP16、INT8のOpenVINOモデルをエクスポートしてそれぞれ検証し、使用するCPUで効果がある場合に限ってINT8を採用します。
すでにお持ちのIntel CPUでGPUインスタンスを置き換えられる場合があります。Ultralyticsのベンチマークでは、YOLO26mの処理時間がPyTorchの192 msから、ノートPCのCore Ultra CPUでOpenVINO INT8を使用した場合は36 msに短縮しました。ただし、性能向上の度合いはチップによって異なります。このコースで使用するARMテスト用ノートPCでは、4枚の画像でキャリブレーションしたINT8エクスポートによりmAPが3ポイント低下しました。リリース前に、どちらの状況に当てはまるかを計測する方法を学びます。
実践的
OpenVINOが提供するもの#
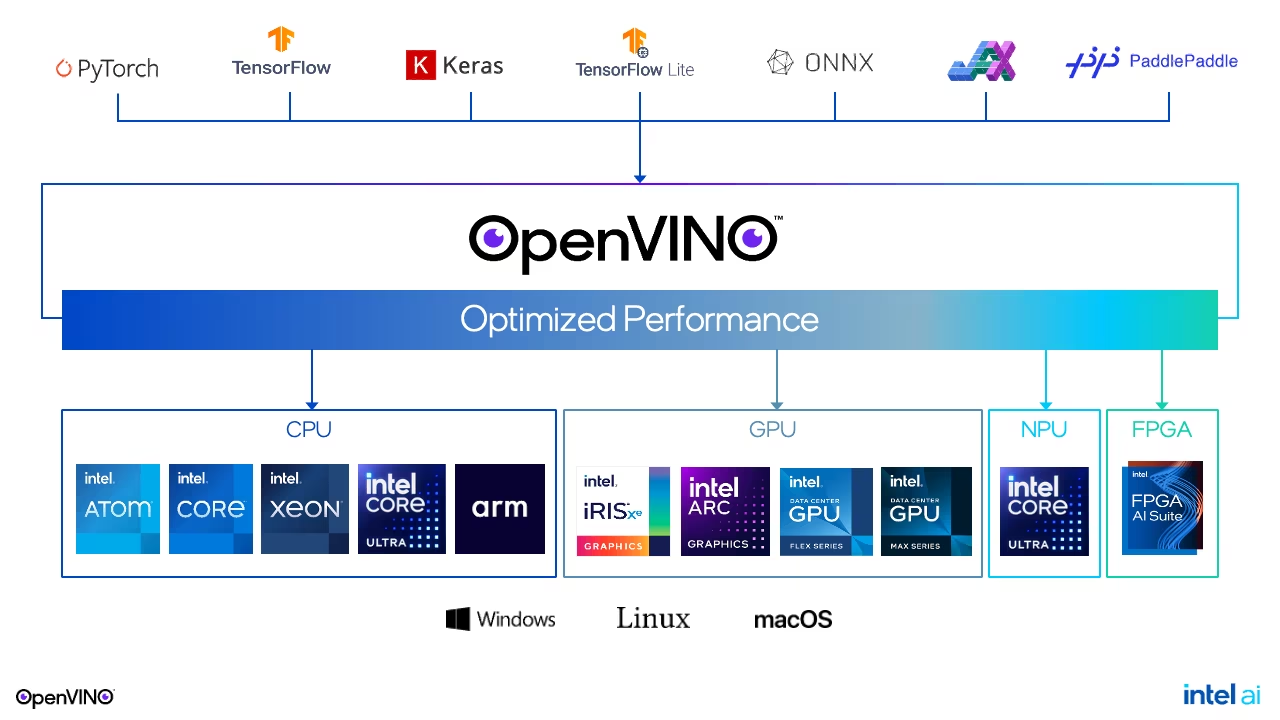
OpenVINOはPyTorchやONNXのモデルを、単一のAPIを通じてIntel CPU、内蔵およびディスクリートGPU、NPU上で実行します。CPUカーネルはIntelの命令セット(AVX2、AVX-512、AMX)を対象としており、INT8の実装も成熟しています。CPU列のARMタイルに注目してください。OpenVINOはARMでも動作しますが、カーネルはIntel向けに最適化されています。ARMで利用する場合は、事前に計測してください。
Intel Core Ultra 7 155H CPU上で公開されているベンチマーク(COCO128):
| モデル | PyTorch FP32 | OpenVINO FP32 | OpenVINO INT8 | FP32からINT8へのmAP50-95 |
|---|---|---|---|---|
| YOLO26n | 33.19 ms | 13.43 ms | 11.40 ms | 0.4734 → 0.4611 |
| YOLO26s | 70.92 ms | 36.16 ms | 15.54 ms | 0.5632 → 0.5471 |
| YOLO26m | 192.45 ms | 102.52 ms | 35.72 ms | 0.6191 → 0.6025 |
この表から、次の3つのルールが導けます。
- Intel CPUでは、OpenVINO FP32だけでもPyTorchのレイテンシがおよそ半分になります。まずはこれを試してください。
- モデルが大きいほどINT8の効果が高まります。
nでは1.2倍、mでは2.9倍高速化し、mAPの低下は1.2~1.7ポイントです。nでは、精度低下を考えるとINT8が見合うことはほとんどありません。 - ハードウェアを購入する前に内蔵GPUを試してください。同じチップのArc iGPU(
device="intel:gpu")では、YOLO26n FP32を9.13 ms、YOLO26mを34.47 msで実行しました。
使用するCPUで精度モードを比較する#
各精度のモデルをエクスポートしたら、次のモデルをエクスポートする前にすぐ検証してください。
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on macOS and Windows
    model = YOLO("yolo26n.pt")  # or runs/detect/pills_v1/weights/best.pt
    for name, quantize in (("FP32", None), ("FP16", 16), ("INT8", 8)):
        path = model.export(format="openvino", quantize=quantize, data="coco8.yaml")  # or my_dataset/data.yaml
        m = YOLO(path).val(data="coco8.yaml", batch=1, plots=False, verbose=False)  # before the next export overwrites it
        print(f"{name}: mAP50-95 {m.box.map:.4f}  -> {path}")
OpenVINO: export success ✅ 2.3s, saved as 'yolo26n_openvino_model/' (9.6 MB)
FP32: mAP50-95 0.6783 -> yolo26n_openvino_model/
OpenVINO: export success ✅ 1.6s, saved as 'yolo26n_openvino_model/' (5.1 MB)
FP16: mAP50-95 0.6783 -> yolo26n_openvino_model/
WARNING ⚠️ OpenVINO: >300 images recommended for INT8 calibration, found 4 images.
OpenVINO: export success ✅ 11.3s, saved as 'yolo26n_int8_openvino_model/' (3.2 MB)
INT8: mAP50-95 0.6460 -> yolo26n_int8_openvino_model/各行でわかること:
- FP32とFP16のスコアは同じで、FP16のサイズは半分です(5.1 MB対9.6 MB)。ただし、両方が同じフォルダーに書き込まれていました。両方を先にエクスポートし、後で検証していたら、FP16を2回計測していたことになります。
- INT8は3.2 MBですが、3.2ポイント低下しました。COCO8の4枚の画像でキャリブレーションしたためです。警告にもその旨が記載されています。実際のキャリブレーションには、独自のYAML(
fractionで使用枚数を制限できます)から取得した、本番環境に近い画像が数百枚必要です。 - これらの結果から速度は分かりません。速度の計測には、以下のベンチマークを使用してください。
エクスポートしたモデルを特定のIntelデバイスで実行するには、次のようにします。
from ultralytics import YOLO

ov_model = YOLO("yolo26n_openvino_model/")
results = ov_model("https://ultralytics.com/images/bus.jpg", device="intel:cpu") # or intel:gpu, intel:npuフォルダー全体を配布してください:yolo26n.xml(グラフ)、yolo26n.bin(重み)、metadata.yaml。intel:gpuとintel:npuにはIntelハードウェアが必要です。
ONNX Runtimeと比較して計測する#
精度の評価が済んだら、実際に処理する負荷をかけた状態で、ターゲット上で速度を評価します。最初のレッスンのpick_runtime.pyをCANDIDATES = ("onnx", "openvino")とともに実行してください。Appleシリコン搭載のテスト用ノートPCで、ほかのジョブがCPUを共有している状態で計測した結果は次のとおりです。
onnx      p50  30.0 ms  p95  46.4 ms  misses the 30 ms budget
openvino p50 22.8 ms p95 113.5 ms misses the 30 ms budgetOpenVINOは中央値が優れていましたが、テールレイテンシは大幅に悪化しました。UltralyticsのラッパーはLATENCYヒントを使ってOpenVINOをコンパイルします(ログにはUsing OpenVINO LATENCY mode for batch=1 inference on CPUと表示されます)。この設定では各リクエストがCPUコア全体に分散されるため、ほかの処理が同じコアを使用すると、最も遅いリクエストへの影響が最大になります。専用のIntelマシンでは通常、上記の公開結果に近い傾向になりますが、実際のp95は自分で計測しなければ分かりません。
判断の目安:
よくある落とし穴#
症状: FP16エクスポートのサイズは半分ですが、速度はまったく変わりません。 対処: ほとんどのCPUでは、プラグインが実行精度を独自に選択します。ダウンロードサイズを小さくするにはFP16を、速度を上げるにはINT8またはiGPUを使用します。
症状: FP32とFP16の数値が同じファイルを使っていたため、同一の数値として報告されます。 対処: FP32とFP16のエクスポートは*_openvino_model/フォルダーを共有します。エクスポートごとに、直後に検証するかフォルダー名を変更してください。
症状: 平均値は問題ないのに、負荷が高い時間帯にはフレームがドロップします。 対処: 本番環境の負荷をかけた状態で推論時間を測定し、平均値ではなくp95を基準に判断します。1台のサーバーで多数のストリームを処理する場合は、レイテンシモードとスループットモードのガイドに従い、OpenVINOランタイムで.xmlを直接読み込み、THROUGHPUTヒントを指定してコンパイルします。
macOSとWindowsでは、検証時にワーカープロセスが起動し、スクリプトが再インポートされます。if __name__ == "__main__":がないと、このレッスンのテスト実行ではワーカー内でエクスポートが繰り返され、数分を無駄にするうえ、測定対象のCPUを取り合っていました。
解答を表示
python ov_compare.py    # accuracy and size of FP32, FP16, INT8
python pick_runtime.py  # p50 and p95 for ONNX Runtime and OpenVINO
上記のCore Ultra 7 155Hの数値を使った判断例:
| オプション | mAP50-95 | 規模 | 画像あたりのミリ秒数 |
|---|---|---|---|
| OpenVINO FP32 | 0.4734 | 9.6 MB | 13.43 |
| OpenVINO INT8 | 0.4611 | 3.2 MB | 11.40 |
iGPU FP32 (intel:gpu) | 0.4758 | 9.6 MB | 9.13 |
統合GPUでOpenVINO FP32をデプロイします。最速の選択肢で精度も低下しない一方、CPUでINT8を使っても2 msの短縮と引き換えに1.2ポイントを失います。YOLO26mのデプロイでは、許容できる精度低下の範囲内であれば、CPU INT8(1.7ポイントの低下で2.9倍高速)を選ぶ判断に変わります。