コストとレイテンシのチューニング
パイプライン全体をプロファイリングし、レイテンシとコストに実際に影響する手段を順に適用して、予算内で止めます。
モデルの処理時間を数ミリ秒削ることに何週間も費やすチームがありますが、実際のボトルネックはデータベースへの書き込みやRTSPデコーダーであることも少なくありません。効果の大きい手段は限られており、十分に測定できます。YOLO26sはCPU上でYOLO26nより7.7 mAPポイント高い一方、処理時間は2.2倍かかります。また、1フレームおきに検出を実行すれば処理量は半分になります。このレッスンでは、まずプロファイリングを行い、適切な最大の手段を適用して、事前に設定した予算内で止める方法を学びます。
実践的
まずパイプライン全体を測定する#
すべてのResultsオブジェクトでは、処理時間がステージごとに分けられます:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
totals = {"preprocess": 0.0, "inference": 0.0, "postprocess": 0.0}
for n, r in enumerate(model.predict(video, stream=True, verbose=False), 1):
    for stage in totals:
        totals[stage] += r.speed[stage]
print({stage: round(ms / n, 1) for stage, ms in totals.items()}, "ms per frame")
{'preprocess': 0.7, 'inference': 36.1, 'postprocess': 0.7} ms per frameここでは推論がモデルの処理時間の95%を占めるため、モデルに対する手段が有効です。同じ方法でデコードと独自のシンク処理時間も測定し(それぞれの前後にtime.perf_counter()を配置)、測定結果に応じて以下の指針を適用します:
| 測定結果 | 最初に行う対策 |
|---|---|
| RTSPのデコードに60 ms、推論に5 ms | ハードウェアデコード、ストリーム解像度の低下、またはデコーダースレッドの増加 |
| 推論に30 ms、Pythonの後処理に100 ms | NumPyでベクトル化するか、ワーカープロセスに移す |
| 推論に5 ms、データベースへの書き込みに200 ms | 書き込みをバッチ処理するか、非同期にする |
| 推論が大半を占める | 以下の手段の優先順位表を参照する |
手段の優先順位表#
予算を満たすまで、上から順に試します:
| 調整方法 | 一般的な高速化率 | 一般的な精度への影響 |
|---|---|---|
| 小さいモデル(m → s、s → n) | 1.5–2.5× | COCOで4.5~7.7 mAPポイント。対象が限定されたタスクではそれより小さくなります |
小さいimgsz(640 → 480) | 約1.8倍 | 小さく遠くにある物体にまず影響します |
| 高速なランタイム、FP16 | GPUで約1.5倍 | 通常は影響なし。精度の同等性を検証してください |
| キャリブレーションを使用したINT8 | GPUでさらに約1.2倍、CPUで最大2.9倍 | YOLO26nでは1ポイント、大型モデルでは4~6ポイント。QATで大部分を回復できます |
フレーム数の削減(vid_stride=N) | 最大N倍 | 動きの速い物体や短いイベントを見逃す可能性があります |
| バッチサイズを大きくする(サーバー) | スループットは向上しますが、レイテンシは低下しません | なし |
数値はYOLO26、TensorRT、OpenVINOのベンチマーク表と以下の測定結果に基づいています。環境によって異なるため、実際に測定してください。
小さいモデル#
COCOにおけるYOLO26ベンチマーク表:
| モデル | mAP50-95 | CPU ONNX(ミリ秒) | T4 TensorRT10(ミリ秒) |
|---|---|---|---|
| YOLO26n | 40.9 | 38.9 | 1.7 |
| YOLO26s | 48.6 | 87.2 | 2.5 |
| YOLO26m | 53.1 | 220.0 | 4.7 |
CPUでは、モデルを1段階小さくするごとに2.2~2.5倍高速になります。COCOの精度差は最悪のケースです。大型物体を扱う3クラスの倉庫検出器では、80クラスの汎用検出器よりもmからnへの変更による精度低下がはるかに小さくなるのが一般的です。そのため、独自の検証セットで小さいモデルを試す価値は常にあります。
小さい入力#
計算量はおおむねピクセル数に比例するため、imgsz=480では640の約56%の処理量が必要です。テスト用ノートPCのCPUで、ONNX Runtimeをバッチサイズ1で使用して測定しました(bus.jpgで25回実行した際の中央値):
| モデル | 640 | 480 | 320 |
|---|---|---|---|
| YOLO26n | 21.3 ms | 12.1 ms | 7.1 ms |
| YOLO26s | 55.0 ms | 24.2 ms | 12.9 ms |
判断基準: 解像度を変更した後でも、重要な最小サイズの物体が約10ピクセル以上を占める場合は試してください。物体が小さい場合や遠くにある場合(ドローン、カメラから遠い棚など)は、解像度を維持してモデルを小さくしてください。
フレーム数を減らす#
推論がフレームレートの制約となっており、シーン内の動きが遅い場合は、vid_stride=Nを使ってNフレームごとに検出を実行し、トラッカーで間のフレームを補完します:
import time

from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
model.predict(video, vid_stride=30, verbose=False)  # warm up so the first timing is fair

for stride in (1, 2, 3):
    start, ids, frames = time.perf_counter(), set(), 0
    for r in model.track(video, stream=True, vid_stride=stride, tracker="bytetrack.yaml", classes=[0], verbose=False):
        frames += 1
        if r.boxes.is_track:
            ids.update(r.boxes.id.int().tolist())
    print(f"vid_stride={stride}: {frames} frames in {time.perf_counter() - start:.2f} s, {len(ids)} person IDs")
vid_stride=1: 62 frames in 2.66 s, 32 person IDs
vid_stride=2: 31 frames in 1.19 s, 30 person IDs
vid_stride=3: 20 frames in 0.95 s, 28 person IDsフレームを半分にすると処理時間もおよそ半分になり、トラッカーは32個中30個のIDを維持しました。vid_stride=3では4個を失ったため、この歩行速度のシーンではここで止める目安になります。
クラウドコストを削減する#
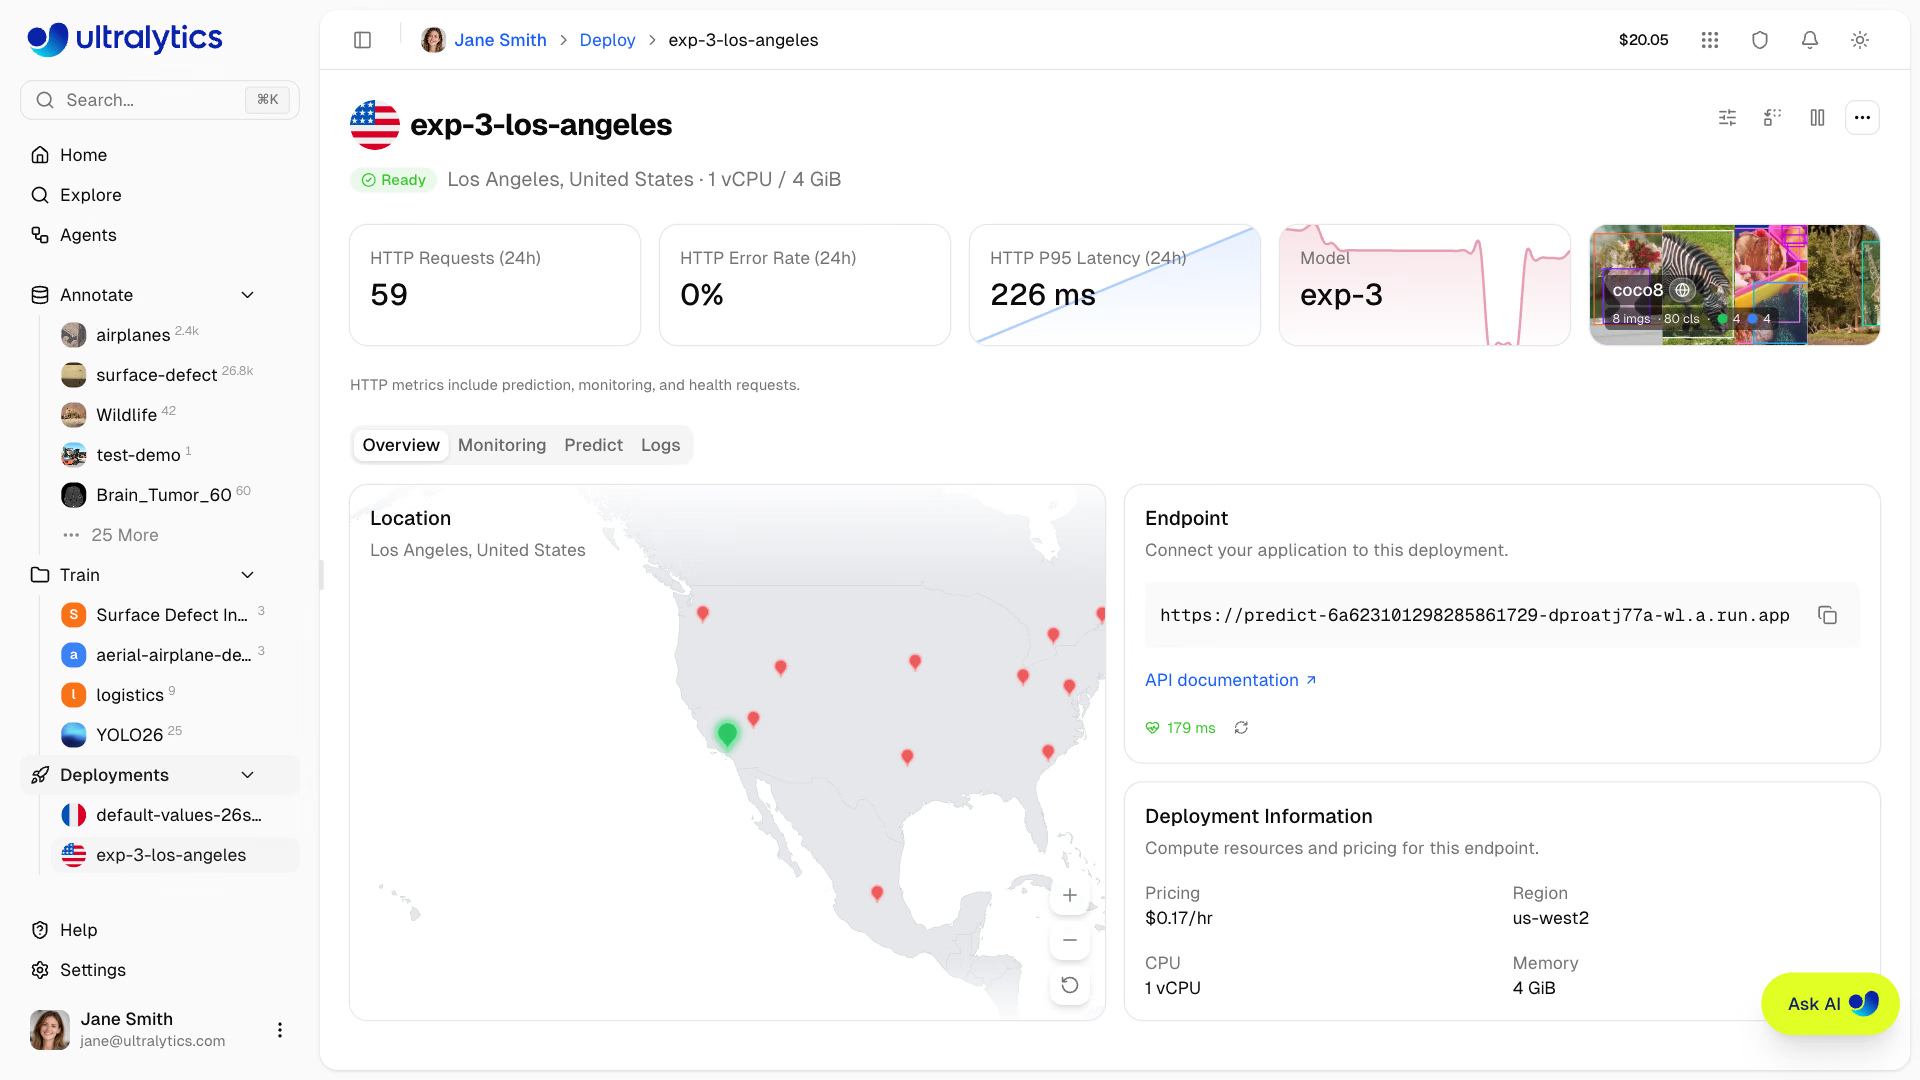
コストはインスタンス稼働時間を有用な処理量で割ったものです。このようなカードには必要な2つの数値が表示されます。1時間あたりのコスト(ここでは1 vCPUと4 GiBで0.17ドル)と処理量(P95が226 msで、24時間に59件のリクエストを処理しているため、エンドポイントは大部分の時間アイドル状態です)です。次に、以下を実施します:
- 利用率を上げます。 GPUの利用率が30%なら、料金の70%が無駄になります。ストリームをバッチ処理する(前のレッスンを参照)か、Triton Inference Server経由でサービングします。
- 適切なサイズを選びます。 大型GPUが必要だと決めつける前に、小型GPUまたはOpenVINOを使用したCPUでベンチマークを実施します。
- バッチジョブにはスポットまたはプリエンプティブル容量を使用します。 アーカイブ動画の再処理は中断されても問題ありませんが、ライブストリームでは許容できません。
よくある落とし穴#
症状: 2週間の調整で10 ms短縮できましたが、システムは依然として遅いままです。 対処: まずパイプライン全体をプロファイルし、最大の処理段階を特定して改善します。
症状: 結果ループ内のif i % 2: continueを使っても何も節約できません。 対処: そのフレームではすでにモデルが実行されています。vid_strideを使って、ソース側でスキップします。
症状: スループットは上がりましたが、各フレームの到着が遅くなりました。 対処: バッチを大きくすると、1フレームあたりのレイテンシではなく、コストあたりのスループットが向上します。多数のストリームやオフラインジョブには使用できますが、単一のリアルタイムカメラには適しません。
モデルの調整で改善しきったら、次に取り組むのはデータの改善です。本番環境に合ったデータセットを使えば、大きなモデルが必要としていた精度を小さなモデルで達成できます。精度を落とさずにコストを削減できます。
解答を表示
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on macOS and Windows
    data, img = "coco8.yaml", "https://ultralytics.com/images/bus.jpg"  # use your val YAML and a production frame
    for weights, imgsz in (("yolo26s.pt", 640), ("yolo26n.pt", 640), ("yolo26n.pt", 480)):
        model = YOLO(weights)
        runs = [model(img, imgsz=imgsz, verbose=False)[0].speed["inference"] for _ in range(20)][5:]
        m = model.val(data=data, imgsz=imgsz, batch=1, plots=False, verbose=False).box.map
        print(f"{weights} imgsz={imgsz}: {sorted(runs)[len(runs) // 2]:.1f} ms, mAP50-95 {m:.3f}")
各行では、最初の5回をウォームアップとして除外し、残りの中央値を報告しています。レイテンシ予算を満たし、mAP損失が予算内に収まる最初の行を選びます。予算の例:「2日間、mAPの低下は最大1ポイント、店舗の端末で20 FPS」。検証セットで、640のyolo26sが1フレームあたり50 msを超え、640のyolo26nが1ポイント以内の低下で目標を満たすなら、そこで終了します。2日目を480に費やす必要はありません。