マルチストリーム推論
バッチ推論、有界キュー、測定したフレームドロップを使って、1つのモデルで複数のカメラを処理します。
1台のカメラに対応できるシステムでも、4台では数分遅れることがあり、しかもクラッシュはしません。メモリが尽きるまで、結果の到着が徐々に遅くなるだけです。ここで使ったノートPCのCPUでは、30 FPSのストリーム1本なら処理が追いつきましたが、4本では半分のフレームがドロップし、8本では3分の2を超えるフレームがドロップしました。このレッスンでは、その数値を測定するパイプラインを構築します。これはハードウェアのサイジングに必要な情報です。
実践的
処理時間の内訳#
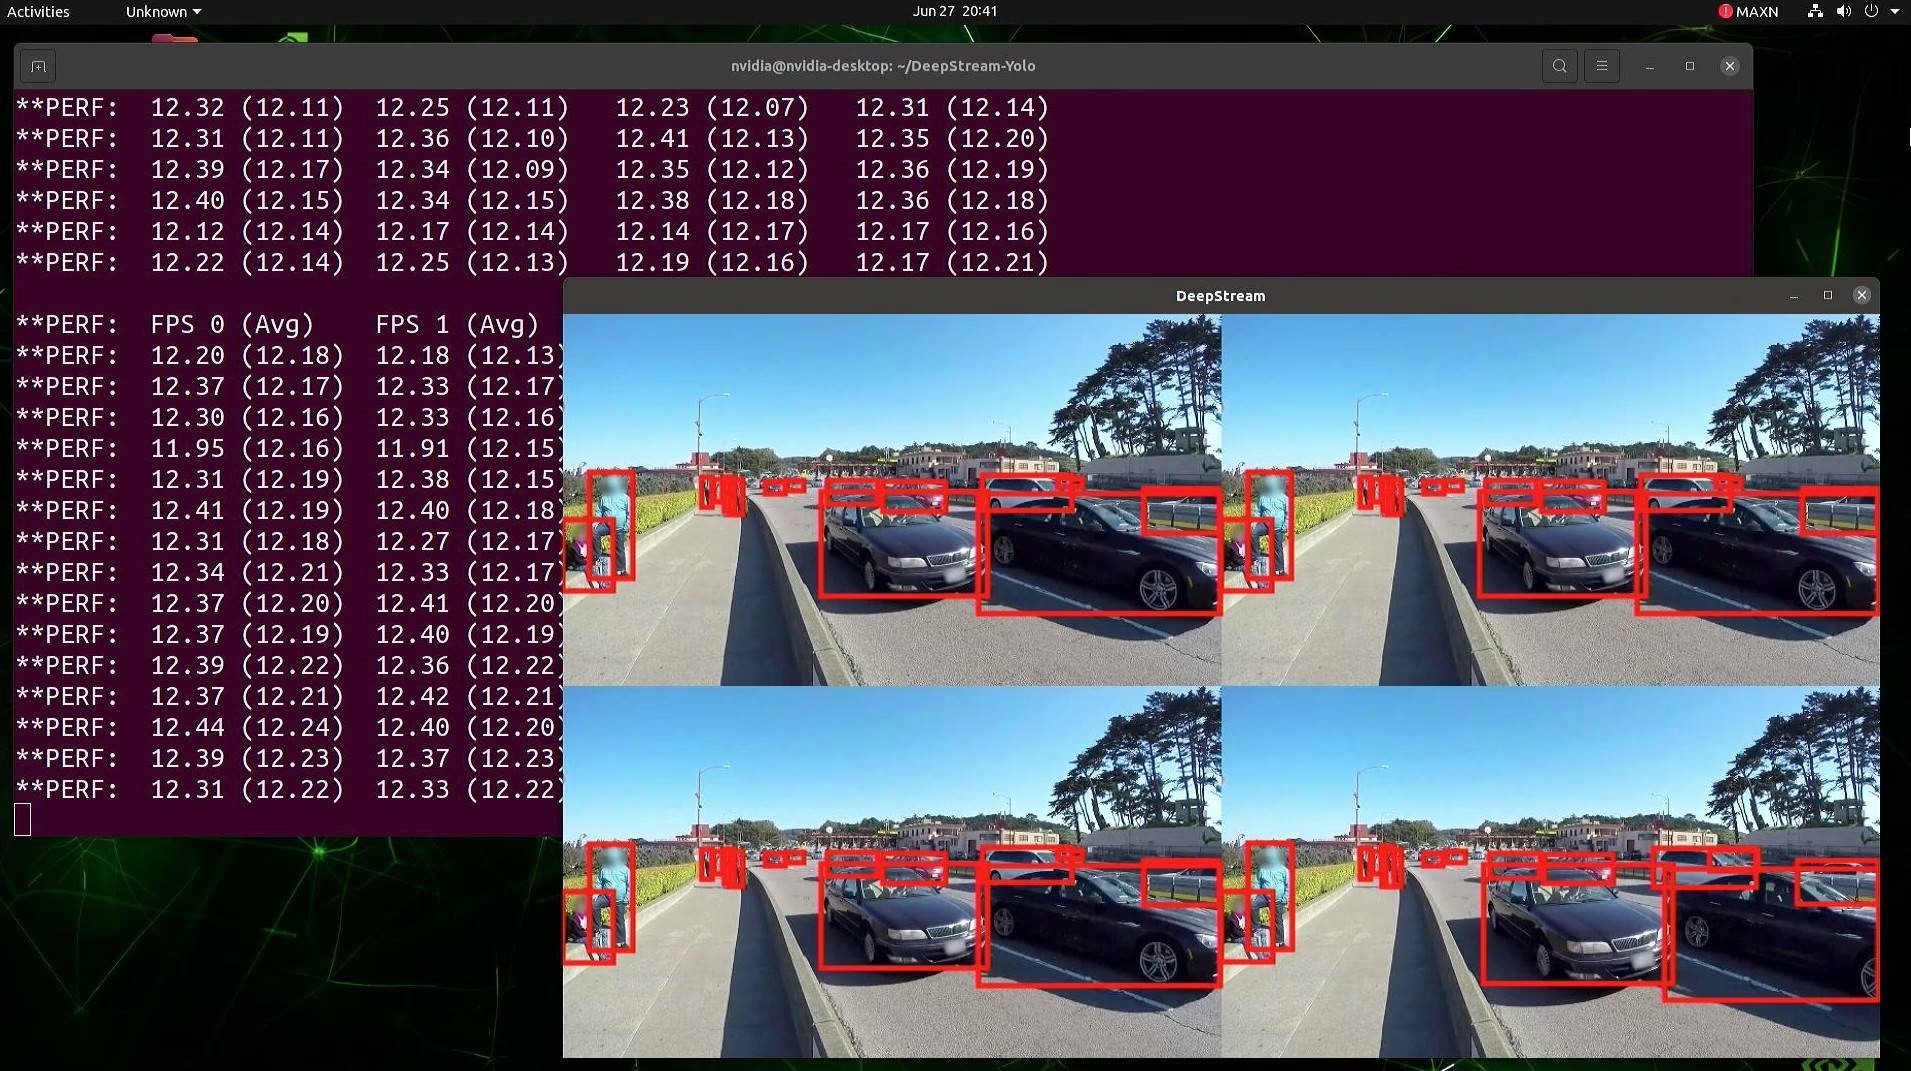
各フレームは4つのステージを通過します。
| 段階 | 一般的な処理時間 | 実行先 |
|---|---|---|
| デコード(RTSPまたはファイル → 配列) | 1080pフレームあたり5~20 ms | CPU |
| 前処理(レターボックス、正規化) | 約1 ms | CPU |
| 推論 | 数ms(GPU)~数十ms(CPU) | アクセラレーター |
| 後処理、トラッキング、出力先 | 数ms。データベースが遅い場合はさらに長くなります | CPU |
1つのスレッドで、カメラごとに順番に実行すると、フレームのデコード中にアクセラレーターがアイドル状態になります。解決策は各ステージを分離することです。上のDeepStreamパイプラインはこの方法で、4つのストリームが1台のデバイスを共有し、それぞれのFPS(ここでは約12)を報告します。Pythonでも同じ構成にできます。
組み込み機能:.streamsファイル#
Ultralyticsは複数のソースをまとめてバッチ処理します。.streamsファイルにソースを1行ずつ記述し、PredictまたはTrackモードに渡します。各ストリームには専用のリーダースレッドとトラッカーが割り当てられ、各イテレーションではすべてのストリームをまとめて1回のフォワードパスで処理します。
from collections import Counter
from pathlib import Path

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

base = "https://github.com/ultralytics/assets/releases/download/v0.0.0/"
clips = [safe_download(base + name) for name in ("solutions_ci_demo.mp4", "ground-vehicles-airport.mp4")]
Path("cams.streams").write_text("\n".join(str(c) for c in clips))  # 本番環境では、1行にrtsp:// URLを1つ記述

model = YOLO("yolo26n.pt")  # 本番環境では最適化済みのエクスポートを使用
frames = Counter()
for r in model.track("cams.streams", stream=True, stream_buffer=True, tracker="bytetrack.yaml", verbose=False):
    frames[Path(r.path).name] += 1  # r.pathで、この結果の取得元ストリームが分かります
print(frames)
Counter({'solutions_ci_demo.mp4': 62, 'ground-vehicles-airport.mp4': 62})最も短いストリームが終了するとイテレーションが停止するため、両方のストリームから62件の結果が生成されました(空港のクリップは150フレームです)。stream_buffer=Trueはすべてのフレームを処理するため、録画ファイルには適しています。ライブカメラではデフォルトのFalseを使用し、モデルの処理が遅い場合は、遅れが蓄積する代わりに古いフレームをスキップしてください。ストリームごとのスループットを最大化するには、TensorRTまたはOpenVINOへのエクスポートを組み合わせます。
カスタム構成:ドロップカウンター付きプロデューサー・コンシューマー方式#
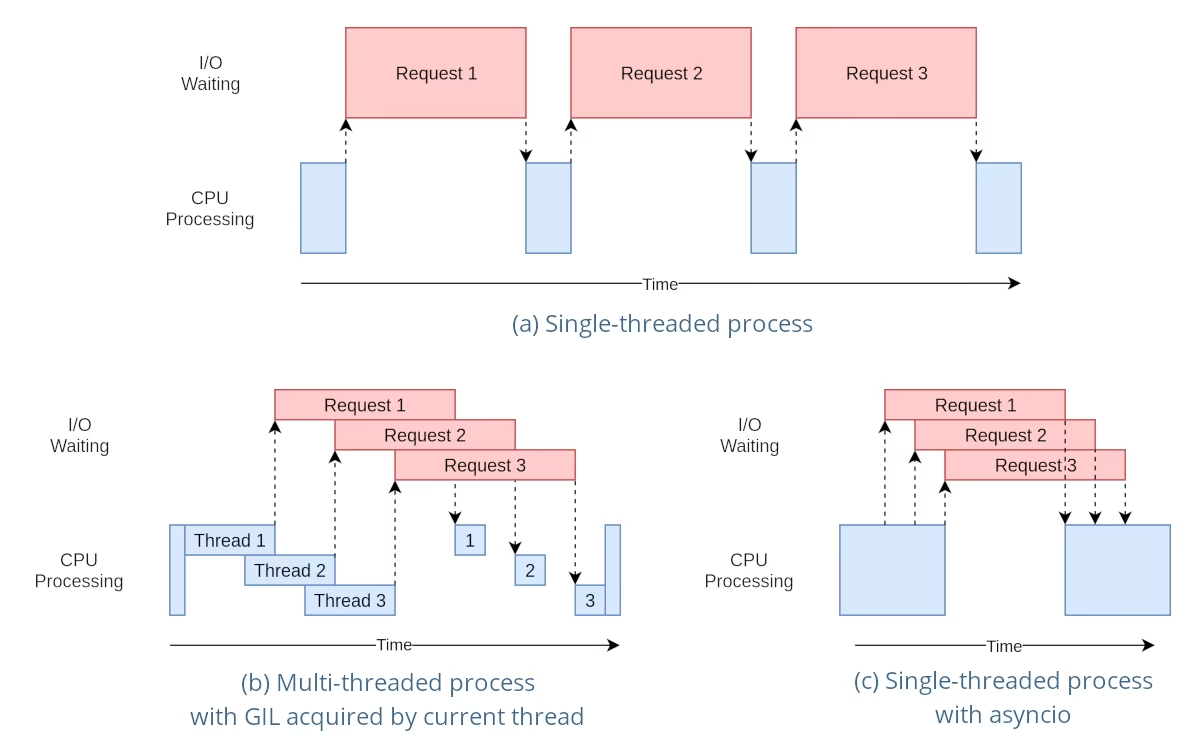
この図は、このパイプラインでスレッドが有効な理由を示しています。デコード中は大部分が待機状態(ピンク色のI/Oバー)であり、OpenCVとPyTorchは処理中にPythonのGILを解放するため、デコーダースレッドは効率よく並行動作します(図b)。負荷の高いPythonによる後処理は並行動作しないため、別プロセスに移してください。
独自の出力先、カメラごとのロジック、または明示的なドロップ指標が必要な場合は、パイプラインを自分で構築してください。デコーダースレッドはモデルに触れず、1つのコンシューマーループがモデルを管理します。これにより、スレッドセーフな推論のルールも守れます。
import queue
import threading
import time

import cv2

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

base = "https://github.com/ultralytics/assets/releases/download/v0.0.0/"
SOURCES = [str(safe_download(base + n)) for n in ("solutions_ci_demo.mp4", "ground-vehicles-airport.mp4")]
frames = queue.Queue(maxsize=16)  # bounded: memory and latency stay flat under overload
dropped = [0] * len(SOURCES)

def decode(stream_id, source):
    """Producer: read frames at the camera's pace and never block on a full queue."""
    cap = cv2.VideoCapture(source)
    interval = 1 / (cap.get(cv2.CAP_PROP_FPS) or 30)
    while True:
        ok, frame = cap.read()
        if not ok:
            break
        try:
            frames.put_nowait((stream_id, frame))
        except queue.Full:
            dropped[stream_id] += 1  # consumer is behind: drop rather than serve stale frames
        time.sleep(interval)  # pace files like a live camera; remove for RTSP sources
    cap.release()

model = YOLO("yolo26n.pt")  # one model, used only by the consumer loop below
model.predict("https://ultralytics.com/images/bus.jpg", verbose=False)  # warm up before cameras start

decoders = [threading.Thread(target=decode, args=(i, s), daemon=True) for i, s in enumerate(SOURCES)]
for t in decoders:
    t.start()

processed = [0] * len(SOURCES)
while any(t.is_alive() for t in decoders) or not frames.empty():
    batch = []
    while len(batch) < 8:  # gather up to 8 frames from any camera
        try:
            batch.append(frames.get(timeout=0.05))
        except queue.Empty:
            break
    if not batch:
        continue
    results = model([frame for _, frame in batch], verbose=False)  # one batched forward pass
    for (stream_id, _), r in zip(batch, results):
        processed[stream_id] += 1  # per-stream postprocessing and sinks go here

print(f"processed={processed} dropped={dropped}")
processed=[56, 131] dropped=[6, 19]2つのクリップはそれぞれ62フレームと150フレームで、すべてのフレームは処理済みかドロップ済みです(56 + 6 = 62、131 + 19 = 150)。そのため、カウンターはすべてのフレームを説明しています。212フレーム中25フレームがドロップしました。このノートPCのCPUでは、2本の30 FPSストリームでyolo26nをPyTorch上で実行できません。クリップを繰り返してカメラ台数を増やした場合の一括測定結果は次のとおりです。
| ストリーム数(各30 FPS) | ドロップしたフレーム数 |
|---|---|
| 1 | 0% |
| 2 | 12% |
| 4 | 51% |
| 8 | 69% |
測定値から処理能力を計画する#
デバイスあたりのストリーム数 ≈ 持続スループット(指定したバッチサイズでモデルが処理する1秒あたりのフレーム数) ÷ ストリームごとの必要FPS。実際のハードウェアで、前のレッスンで最適化したエクスポートのスループットを測定し、ピークに備えて20~30%の余裕を確保して、ドロップがゼロを超えたらアラートを出します。高解像度ではピクセル数にほぼ比例して処理コストが増えます。1280×1280では640×640の約4倍の計算量が必要です。大規模なシステム群には、Triton Inference ServerとJetson上のDeepStreamが本番環境向けの自然な選択肢です。
よくある落とし穴#
症状: model.track(["cam1.mp4", "cam2.mp4"])がリストをストリームではなく画像のバッチとして扱います。 対処: ソースを.streamsファイルに1行ずつ書き込みます。
症状: 各ファイルから1、2フレームしか取得できません。 対処: stream_buffer=Falseは古いフレームを破棄し、ファイルリーダーがモデルより先に進んでしまいます。ファイルではstream_buffer=Trueを設定し、ライブカメラではデフォルトのままにします。
症状: 負荷がかかると、誤った結果や混在した結果が時々発生します。 対処: 複数のスレッドから1つのYOLOインスタンスを同時に呼び出さないでください。前述のように1つのコンシューマーに所有させるか、推論スレッドごとにモデルを作成します。
症状: レイテンシが分ごとに増加し、メモリ使用量も上がり続けてプロセスが停止します。 対処: キューが満杯になったらフレームを破棄する有界キューと、ドロップ数のカウンターを使います。リアルタイムシステムでは、処理が過負荷になったときに遅延させるのではなく、フレームを破棄してください。
解答を表示
producer_consumer.pyのSOURCES行の直後に以下の行を追加し、ストリーム数をコマンドライン引数にします。
import sys

N = int(sys.argv[1]) if len(sys.argv) > 1 else 2  # シミュレーションするカメラ数
SOURCES = [SOURCES[i % len(SOURCES)] for i in range(N)]
次に、値を変えながら測定します。
for n in 1 2 4 8; do python producer_consumer.py $n; doneprocessed=[62] dropped=[0]
processed=[56, 131] dropped=[6, 19]
processed=[23, 82, 23, 81] dropped=[39, 68, 39, 69]
processed=[14, 53, 13, 53, 13, 52, 13, 53] dropped=[48, 97, 49, 97, 49, 98, 49, 97]このマシンでの答えはストリーム1本です。2本目からドロップが始まります。4台のカメラを処理するには、より高速なランタイムにエクスポートする(レッスン3と4)、imgszを下げる、またはアクセラレーターに切り替えてから、測定をやり直してください。