TensorRTで最適化する
FP16のTensorRTエンジンをビルドし、INT8が精度低下に見合うかを判断して、リリース前にエンジンをゲート審査します。
NVIDIA GPUでは、TensorRT FP16エンジンは通常、最も手軽に得られる高速化です。UltralyticsのA100ベンチマークでは、mAPを変えずに約1.5倍高速化しました。INT8ではさらに高速化できますが、学習後にINT8へ変換すると、COCOでYOLO26sからYOLO26mのmAPが4~6ポイント低下しました。このレッスンでは、どのステップを選択しているのかを把握し、ユーザーが気づく前に計測する方法を学びます。
実践的
このレッスンのコードを実行するには、TensorRTをインストールしたNVIDIA GPUが必要です。ここで示す引数はすべて、エクスポートモードのドキュメントでformat=engine向けに説明されています。
FP16は安全な第一歩です#
Volta以降のNVIDIA GPUにはFP16 Tensor Coreが搭載されており、検出モデルの推論でFP32が必要になることはほとんどありません。まずは次の手順を実行してください。
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # or runs/detect/pills_v1/weights/best.pt
model.export(format="engine", quantize=16, workspace=4) # FP16エンジン、ビルダーワークスペースは最大4 GiBworkspaceは、ビルド中にTensorRTが使用できるGPUメモリの上限を設定します。TensorRTに任せる場合は設定しないでください。TensorRT統合のページでは、次のA100の結果を公開しています(YOLOv8n、640 px)。
| 適合率 | 推論、バッチサイズ8(ms) | COCO val mAP50-95 |
|---|---|---|
| FP32 | 0.52 | 0.37 |
| FP16 | 0.34 | 0.37 |
| INT8 | 0.28 | 0.33 |
モデルはYOLO26より古いものですが、トレードオフの傾向は同じです。FP16は追加コストなしで約1.5倍高速化し、INT8ではさらに1.2倍高速化する代わりに4ポイント低下しました。FP16で予算を満たせるなら、そのままリリースしてください。
ローカルにNVIDIA GPUがありませんか?Ultralytics PlatformのExportタブでは、選択したクラウドGPU上でエンジンをビルドできます。画像サイズ、精度、バッチサイズ、動的形状、NMS、ワークスペースの各オプションは同じです。

デプロイ先のGPUファミリーを選択してください。画像のエンジンはRTX 5090上でビルドされており、そのファミリーのGPUでのみ実行できます。
INT8にはキャリブレーションデータが必要です#
INT8量子化では、各レイヤーの活性化値を256段階にマッピングします。その範囲を決めるため、エクスポーターはキャリブレーション画像をモデルに入力し、観測した活性化値を記録します。そのため、画像は本番環境のデータに似ている必要があります。
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(
    format="engine",
    quantize=8,
    data="coco128.yaml",  # キャリブレーション画像はこのデータセットのvalスプリットから取得します。my_dataset/data.yamlを使用してください
    fraction=1.0,  # 使用する画像の割合(または枚数)
    batch=8,  # キャリブレーションバッチを大きくすると、範囲がより安定します
    dynamic=True,  # batch=8の場合、エンジンは1~8のバッチを受け付けます
    workspace=4,
)INT8による精度低下はモデルによって異なります。Exportモードのドキュメントでは、COCO valでのYOLO26 TensorRTエンジンの測定結果(mAP50-95)を公開しています。
| モデル | FP32エンジン | キャリブレーション済みINT8(PTQ) | 量子化認識トレーニング(QAT)後のINT8 |
|---|---|---|---|
| YOLO26n | 0.4032 | 0.3934 | 0.3935 |
| YOLO26s | 0.4794 | 0.4412 | 0.4711 |
| YOLO26m | 0.5269 | 0.4696 | 0.5137 |
キャリブレーションのみでもYOLO26nでは1ポイント、大きいモデルでは4~6ポイント低下します。QATではquantize=8をtrainで使用してモデルをファインチューニングし、重みがINT8に耐えられるようにします。チェックポイントには独自の範囲が含まれるため、INT8エクスポートにキャリブレーションデータは不要で、FP32からの低下を1~2ポイント以内に抑えられます。判断基準は次のとおりです。
リリース前にエンジンをゲート審査する#
すべてのエンジンについて、デプロイ先のGPU上で同じチェックを行います。
| チェック項目 | 審査項目 |
|---|---|
| 検証用データセットのmAP50-95 | FP16ではFP32から0.5ポイント以内、INT8では書面で定めた予算内 |
| クラスごとのAP | どのクラスも約1ポイントを超えて低下しないこと(小規模クラスで変動が最も大きくなります) |
| p95レイテンシ | 本番環境のバッチサイズで予算を下回ること |
| 運用時の閾値 | エンジン独自のF1カーブからconfを再選定します |
| 決定性 | 同じ画像を2回処理したとき、まったく同じBBoxが得られること |
yolo val model=yolo26n.engine data=coco8.yaml  # or my_dataset/data.yaml
yolo benchmark model=yolo26n.pt data=coco8.yaml imgsz=640 format=engine quantize=16高速化の仕組み#
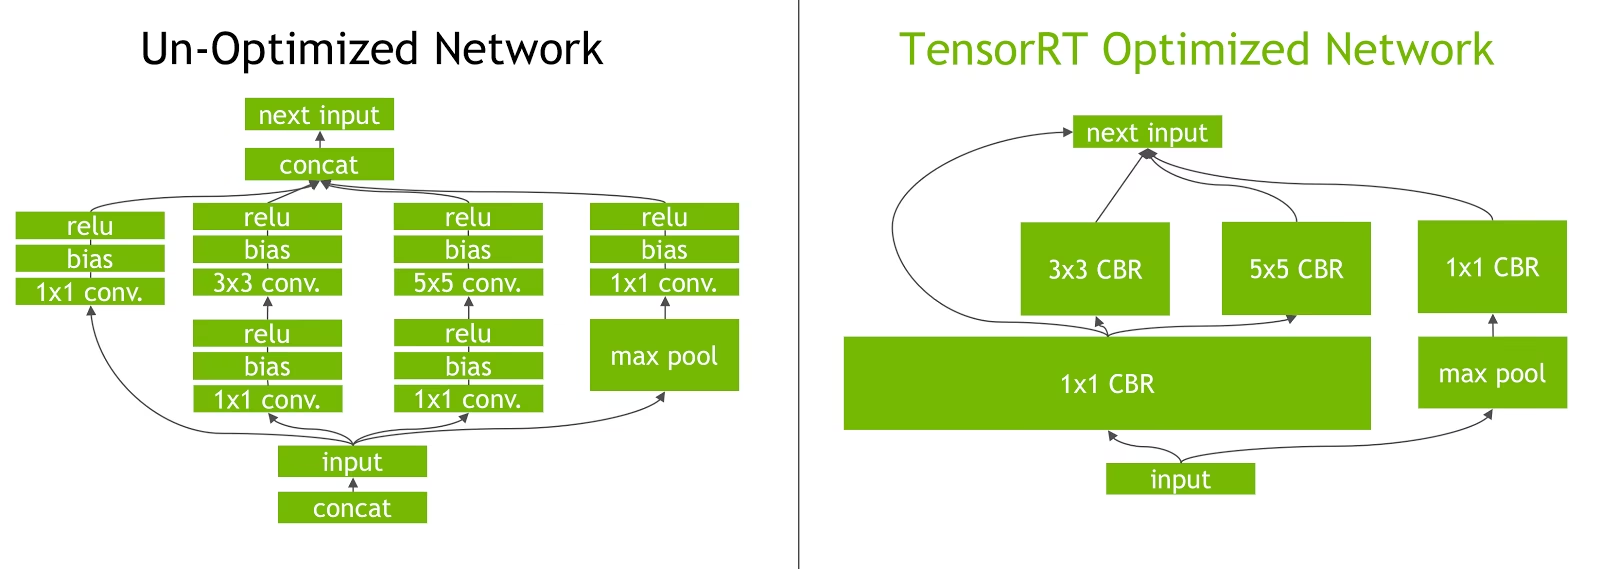
TensorRTは畳み込み、バイアス、ReLUを1つのカーネルに融合し(右側の「CBR」ブロック)、結合処理を省略します。そのため、GPUが起動するカーネル数が大幅に減り、データ移動も少なくなります。YOLO26では、ネットワーク全体にあるconv-BN-activationチェーン、バックボーンのattention(PSA)ブロック、検出ヘッドにある多数の小さな演算で効果が得られます。エンジンがまだ遅い場合は、trtexecまたはNVIDIA Nsightでプロファイリングしてください。多くの場合、1つのレイヤーが処理時間の30%以上を占めています。
よくある落とし穴#
症状: INT8ではCOCOのスコアが1ポイント低下しますが、カメラのデータでは6ポイント低下します。 対処: 自分の検証セットから取り分けたデータでキャリブレーションします。NVIDIAは代表性のある画像を少なくとも500枚使用することを推奨しています。キャリブレーション結果はデバイスによっても異なるため、デプロイ先のGPUでキャリブレーションしてください。
症状: 同じconfを使用していても、INT8に切り替えると再現率が低下します。 対処: INT8では確信度の値が変わることがあります。INT8エンジン独自のF1曲線からconfを選び直してください。
症状: デプロイ先のマシンでエンジンのデシリアライズに失敗するか、予想より遅くなります。 対処: デプロイ先と同じGPUファミリーで、TensorRTとCUDAランタイムのバージョンを一致させてビルドし、デバイスで再ビルドできるように.onnxを同梱します。ビルド中にキャリブレーションがクラッシュする場合は、workspaceを増やすか、imgszまたはbatchを減らします。
Jetsonでは、DeepStreamがハードウェアアクセラレーション対応のビデオパイプラインで生成されたエンジンを実行します。データセンターでは、Triton Inference Serverがエンジンを提供します。
解答を表示
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on Windows
    data = "coco8.yaml"  # or my_dataset/data.yaml
    model = YOLO("yolo26n.pt")
    engine = model.export(format="engine", quantize=16, workspace=4)

    base = model.val(data=data, plots=False).box.map
    fp16 = YOLO(engine).val(data=data, plots=False).box.map
    print(f"PyTorch {base:.4f}  FP16 engine {fp16:.4f}  gap {abs(base - fp16) * 100:.2f} points")

    # Only if FP16 misses the latency budget:
# model.export(format="engine", quantize=8, data=data, batch=8, dynamic=True, workspace=4)合格レポートは、差が0.5ポイント未満、p95が予算内、判断がFP16をリリースとなります。p95が基準を満たさない場合は、独自のキャリブレーションYAMLを使ってINT8をエクスポートし、同じ2つのコマンドを再実行してください。INT8をリリースするのは、開始前に設定した予算内に差が収まる場合のみです。それ以外の場合はQATまたは小さいモデルを試してください。