検証と診断
best.ptをベースラインと照らし合わせて検証し、混同行列、クラス別の数値、予測画像を確認して、具体的な修正項目のリストを作成します。
単一のmAPの値から分かるのは、モデルがどの程度間違えているかであり、何を間違えているかではありません。小さい物体の見逃し、2つのクラスの混同、緩いボックスはどれもmAPを低下させますが、それぞれ必要な修正は異なります。判断を誤ると、間違ったデータを集めるために1週間を費やすことになります。
このレッスンでは、best.pt でValモードを実行してベースラインと比較します。次の改善項目リストを書けるようになるまで、混同行列と予測画像を確認します。性能指標ガイドでは、さらに詳しく解説しています。
実践的
実践例:best.ptを検証する#
from ultralytics import YOLO

model = YOLO("runs/detect/pills_v1/weights/best.pt")
metrics = model.val(data="my_dataset/data.yaml")

print(f"precision {metrics.box.mp:.3f}  recall {metrics.box.mr:.3f}")
print(f"mAP50 {metrics.box.map50:.3f}  mAP50-95 {metrics.box.map:.3f}")
val.py の実際の出力:
precision 0.970  recall 0.957
mAP50 0.977  mAP50-95 0.659
プロットは新しい runs/detect/val フォルダーに保存されます(続いて val-2 など)。数値をベースラインと並べて記録します。
| モデル | mAP50 | mAP50-95 |
|---|---|---|
事前学習済み yolo26n.pt(錠剤クラスなし) | 0.001 | 0.0002 |
pills_v1(10エポック、imgsz 320、CPU) | 0.977 | 0.659 |
数値が示すこと:
- Precision 0.970、recall 0.957: バランスが取れています。誤検出も見逃しも少数です。
- mAP50 0.977: 重なりの条件が緩い場合、モデルはほぼすべての錠剤を検出します。
- mAP50-95 0.659: 重なりの条件が厳しい場合、多くのボックスがぴったり合っていません。この大きな差は、データ不足ではなく、位置特定の問題を示しています。エポック数を増やす、大きな
imgszを使う、またはラベルをより厳密に付けるといった対策が考えられます。
precision、recall、mAPのトレードオフについては、検出メトリクスを正しく読み解くをご覧ください。
質問への答えがわかるファイルを確認する#
| 質問 | ファイル |
|---|---|
| どのクラスが混同され、どのクラスが見逃されていますか? | confusion_matrix_normalized.png |
| クラスごとにprecisionとrecallのバランスはどうなっていますか? | BoxPR_curve.png |
| どのconfidenceしきい値でデプロイすればよいですか? | BoxF1_curve.png: ピーク値は適切な初期confです |
| 失敗例はどのような見た目ですか? | val_batch0_labels.jpgとval_batch0_pred.jpg |
| モデルは過学習していますか? | トレーニングフォルダー内のresults.png |
混同行列を読み解く#
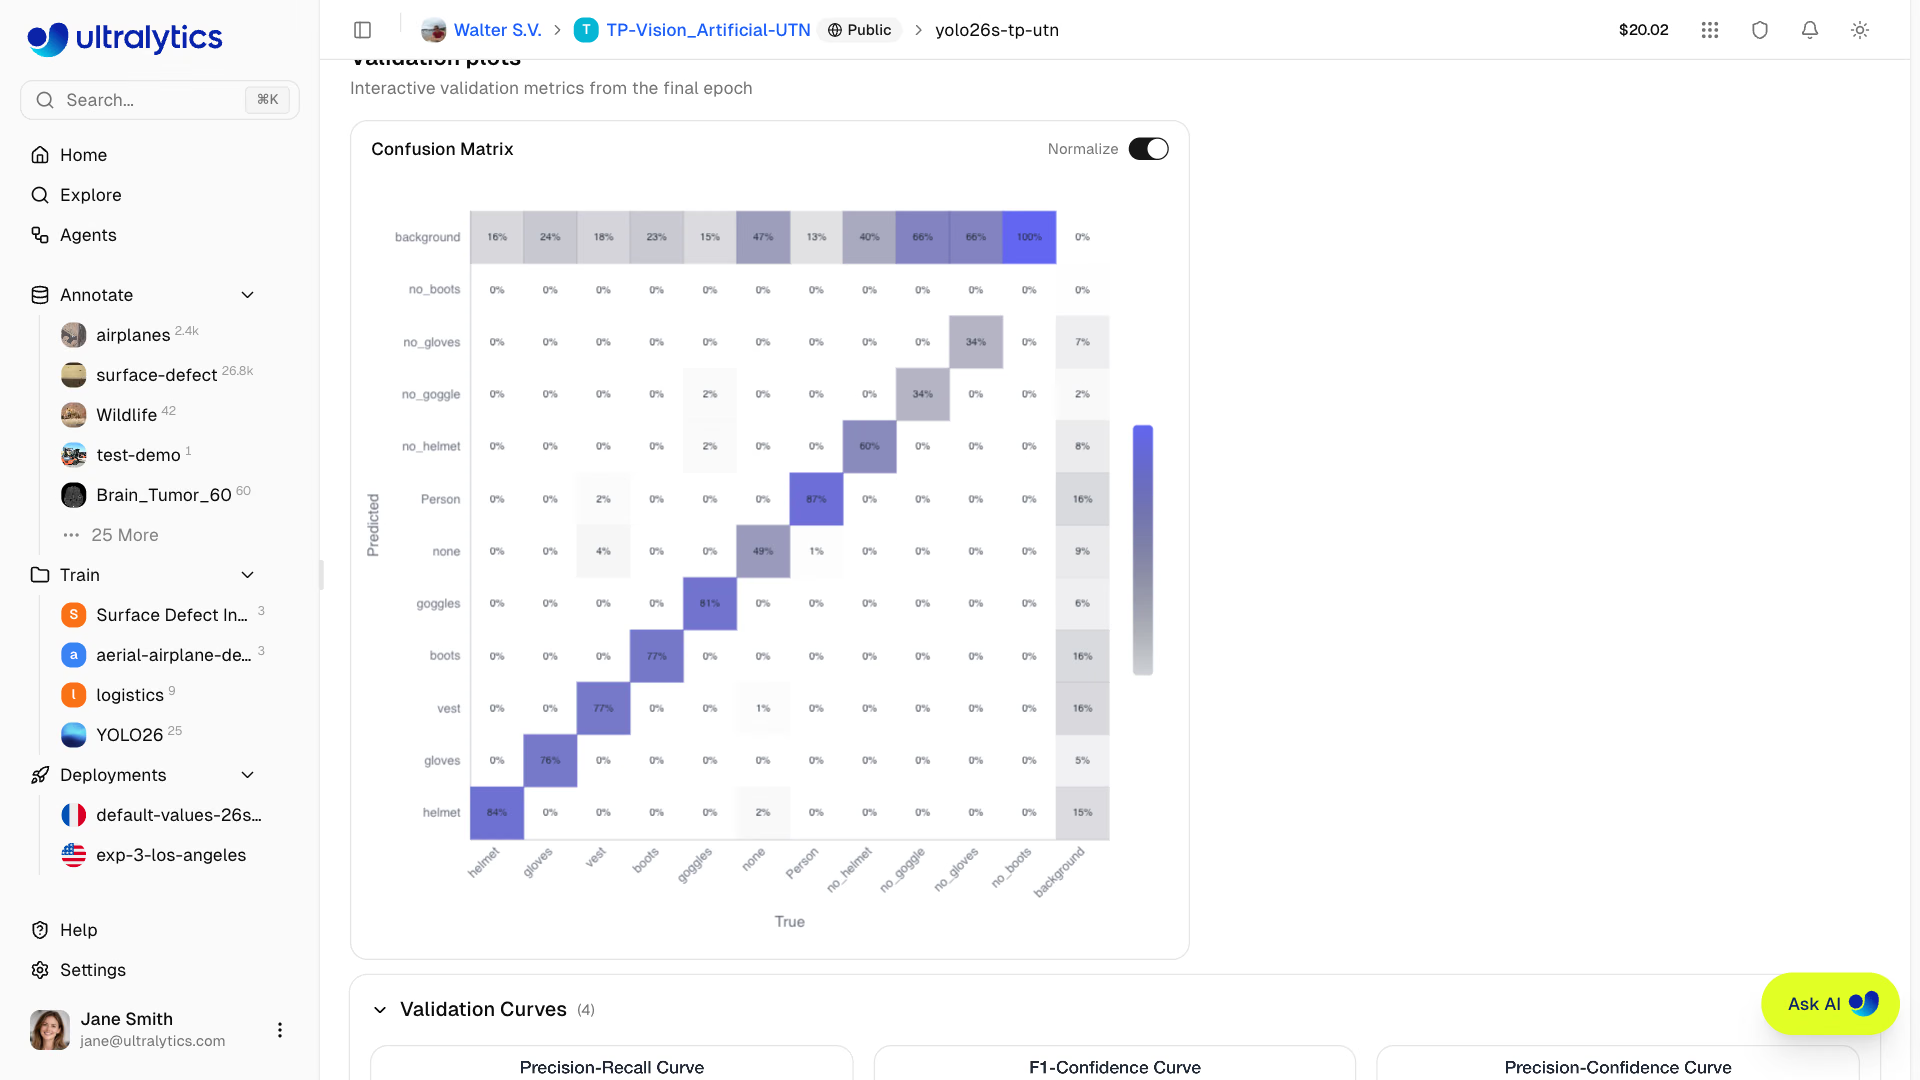
混同行列は、最も役立つ診断ツールです。Ultralyticsのプロットでは、列が正解クラス、行が予測クラスで、backgroundの行と列が追加されています。正規化された行列では各列をその合計で割るため、各クラスのオブジェクトがどこに分類されたかがわかります。錠剤モデルのクラスは1つだけなので、3クラスの倉庫の例(数値は説明用)で練習してみましょう。
| 予測 ↓ / 正解 → | フォークリフト | 人 | パレット | 背景 |
|---|---|---|---|---|
| フォークリフト | 0.78 | 0.03 | 0.18 | 0.45 |
| 人 | 0.04 | 0.91 | 0.00 | 0.20 |
| パレット | 0.10 | 0.00 | 0.65 | 0.35 |
| 背景 | 0.08 | 0.06 | 0.17 | — |
- 対角成分: 各クラスが正しく検出された割合です。パレットは0.65で、最も性能が低いクラスです。
- 非対角成分: クラスの混同を示します。正解がパレットのデータの18%がフォークリフトと予測され、フォークリフトの10%がパレットと予測されました。
- 背景の行: 見逃しを示します。パレットの17%がまったく検出されませんでした。
- 背景の列: 空の領域にボックスが描画された誤検出を示します。そのうち45%はフォークリフトと判定されました。
各セルの種類に対応する対策は次のとおりです。
| パターン | 対策 |
|---|---|
| 2つのクラスが互いに混同される | 両者を区別できる例を追加します。パレットを運ぶフォークリフトや、フォークリフトの隣に積まれたパレットなどです |
| 背景の行の値が高い(見逃しが多い) | 見逃しが発生する条件下で、そのクラスの例を増やします |
| 背景の列の値が高い(誤検出が多い) | 空の通路など、誤検出を引き起こすシーンの背景画像を追加します |
クラスごとの数値を読み解く#
クラスが複数ある場合、検証ログにはクラスごとに1行が出力され、metrics.box.mapsにはコードで使えるクラス別mAP50-95が格納されます。倉庫の例を続けます。
                 Class     Images  Instances      Box(P          R      mAP50  mAP50-95)
                   all         50        102       0.78       0.71       0.74       0.51
              forklift         30         45       0.85       0.78       0.81       0.58
                person         40         50       0.92       0.88       0.91       0.64
pallet 5 7 0.58 0.48 0.51 0.31palletは他のクラスを大きく下回り、検証データ内のインスタンスはわずか7件です。モデルのパレット検出が苦手なのか、判断するには検証データが少なすぎるのか、どちらかです。どちらの場合も、トレーニング用と検証用にパレットのデータをさらに収集する必要があります。
失敗例を確認する#
val_batch0_labels.jpgとval_batch0_pred.jpgを並べて開きます。違いは失敗例を画像として示しており、そこに見られるパターンが診断の手がかりになります。画像の端での見逃し、小さなオブジェクト、特定の照明条件、見た目が似た対象などです。こうしたデータセットのパターンは、ほとんどの場合、ハイパーパラメーターの調整よりも重要です。
錠剤モデルの検証画像では、はっきり見える錠剤のスコアは1.0近くです。confidenceが0.3~0.5程度の低いボックスは、別のブリスターパックの下に一部が隠れた錠剤や、画像の端で切れている錠剤に集中しています。これはconfで解消する問題ではなく、ラベリング方針の問題です。半分隠れた錠剤を対象として数えるべきでしょうか?方針を決めて明文化し、すべての画像に同じルールを適用してください。
次にresults.pngを開きます。トレーニング損失と検証損失はどちらも低下するはずです。トレーニング損失が低下し続ける一方で検証損失が上昇する場合は過学習です。どちらも高いままなら未学習です。どちらの場合も、バイアスと分散のトレードオフが判断の枠組みになります。
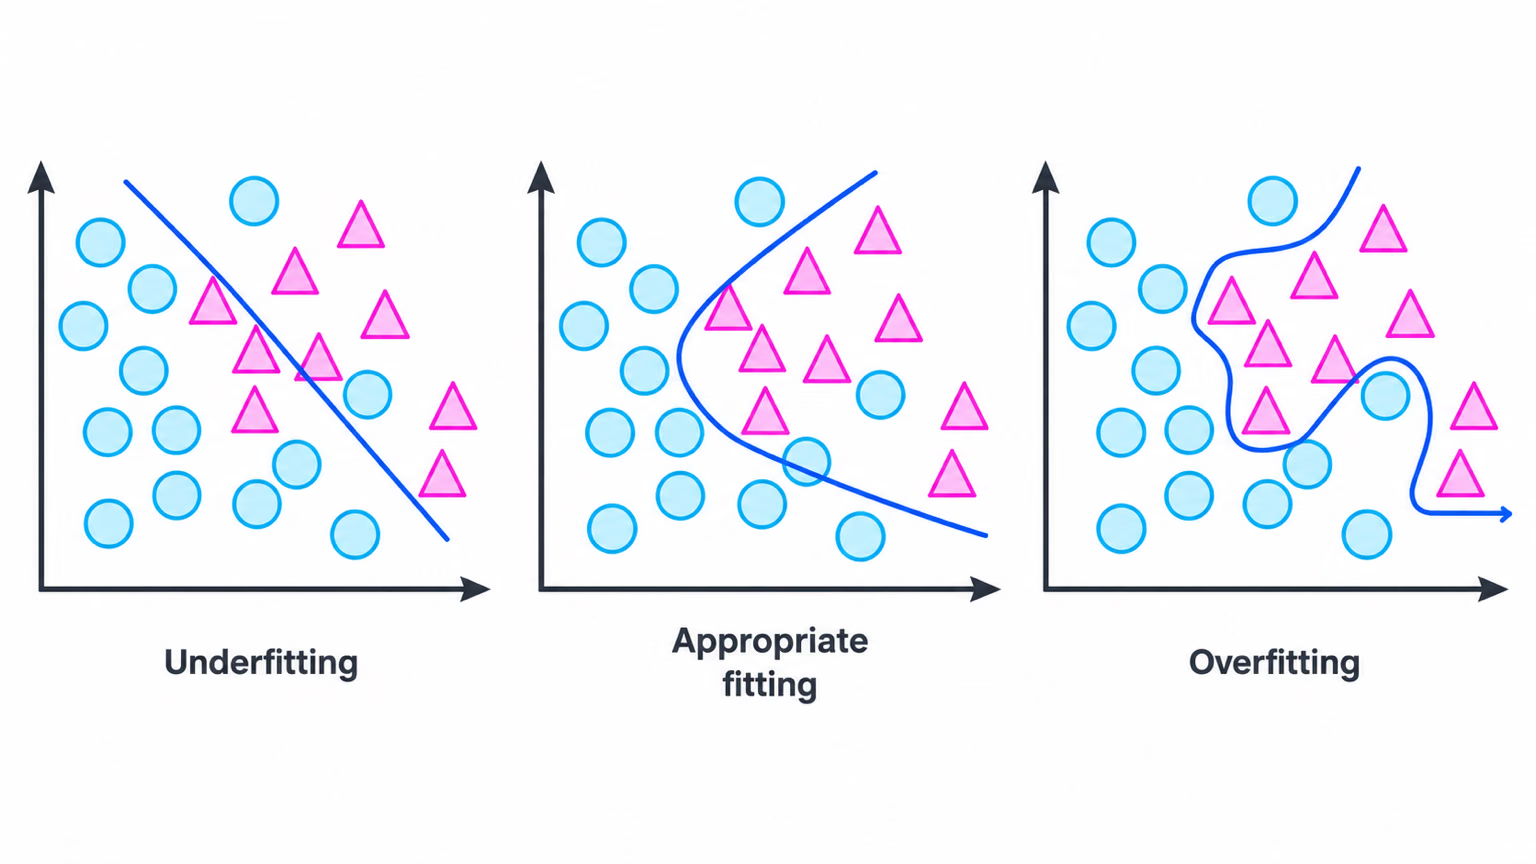
過学習への対策は、効果が得られる頻度が高い順に、より多様なデータ、エポック数を減らすかpatienceをより厳しくすること、そしてデータ拡張(hsv_h、degrees、translate、scale、fliplr、mosaicなど)です。データ拡張のデフォルト設定はすでに強力なので、左右の区別が重要な場合にfliplrを無効にするなど、理由がある場合にのみ変更してください。
調査結果を対策リストにまとめる#
ハイパーパラメーターを調整する前にデータを修正し、何が効果をもたらしたか把握できるよう、1回のイテレーションで変更する項目は1つにします。このループのデータセット側の作業については、初回のファインチューニングとイテレーションループで説明しています。
次の間違いに注意する#
症状: mAP50-95が0.659だったモデルのスコアが、突然0.403になります。原因: pills_v1 は imgsz=320 でトレーニングされ、imgsz=640 で検証されました。そのため、オブジェクトが学習時の2倍の大きさで表示されます。対処: トレーニング時の imgsz で検証とデプロイを行い、同じサイズで実行した結果だけを比較してください。
検証は全精度-再現率曲線を追跡できるよう conf=0.001 で実行されるため、val_batch0_pred.jpg にはアプリが報告しないボックスも表示されます。BoxF1_curve.png からデプロイ時のしきい値を選び、predict で確認してください。
画像が23枚の場合、あるエポックのprecisionは0.93から0.80に下がり、再び上昇しました。エポックと実行間の傾向を見て判断し、1~2ポイントの差を信頼する前に検証セットを増やしてください。
解答を表示
Baseline mAP50-95 0.0002 -> pills_v1 0.659 (mAP50 0.977), both at imgsz=320

Failures:
- Low-confidence boxes (about 0.3-0.5) on pills half-hidden under another pack.
- Low-confidence or missing boxes on pills cut off at the image edge.

Overfitting: none. val/box_loss flattened near 1.05; val/cls_loss spiked at epochs 4-6
and then fell to its lowest value (1.08) at epoch 10.

Fix list:
1. Write a labeling rule for partly hidden and edge pills, then relabel the val set to match.
2. Train longer and larger: epochs=50, imgsz=640 (mAP50-95 lags mAP50, so box tightness is the gap).
3. Add 20 frames with overlapping packs, labeled under the new rule.