検出指標を正しく読み取る
検証を実行し、適合率、再現率、mAP50-95、クラスごとのAP、混同行列を合わせて読み、目標に基づいてリリース時のしきい値を決めます。
単一の数値には安心感があります。mAP 0.83、これで完了です。しかし、同じmAPでも、半分の確率で失敗するクラス、常に緩いバウンディングボックス、あるいは毎分アラートが発生するしきい値が隠れていることがあります。実際に検証を実行し、修正すべき点としきい値の設定箇所が分かるまで、結果を一行ずつ読み解きます。
実践的
各予測の評価方法#
検証では、予測された各ボックスをグラウンドトゥルースと照合します。クラスが正しく、未照合のグラウンドトゥルースボックスとのIoUがしきい値を超える場合、その予測は真陽性(TP)です。それ以外は偽陽性(FP)です。未照合のまま残った各グラウンドトゥルース物体は偽陰性(FN)です。
| 指標 | 数式 | 答える質問 |
|---|---|---|
| 適合率 | TP / (TP + FP) | モデルがボックスを描画したとき、どれくらいの頻度で正しいですか? |
| 再現率 | TP / (TP + FN) | 実際に存在する物体のうち、いくつを検出できましたか? |
| F1 | 2 × P × R / (P + R) | 両方のバランスを取る単一の数値 |
信頼度しきい値を下げるとボックスが増え、再現率は上がり、適合率は下がります。適合率-再現率曲線は、すべてのしきい値におけるこのトレードオフを示し、その曲線下の面積が1クラスの平均適合率(AP)です。mAP50は、IoU 0.5におけるクラスごとのAPを平均した値です。この場合、かなり緩いボックスでも正解として扱われます。mAP50-95は、0.5から0.95までの10個のIoUしきい値で平均するため、より正確なボックスが評価されます。Ultralyticsのモデル表で主要な指標として使われているのはこの値です。
検証を実行する#
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
metrics = model.val(data="coco8.yaml")

print(f"precision={metrics.box.mp:.3f} recall={metrics.box.mr:.3f}")
print(f"mAP50={metrics.box.map50:.3f} mAP50-95={metrics.box.map:.3f}")
Class Images Instances Box(P R mAP50 mAP50-95)
all 4 17 0.551 0.962 0.943 0.669
person 3 10 0.551 0.8 0.848 0.387
dog 1 1 0.36 1 0.995 0.597
horse 1 2 0.36 1 0.995 0.696
elephant 1 2 0.656 0.969 0.828 0.545
umbrella 1 1 0.543 1 0.995 0.895
potted plant 1 1 0.833 1 0.995 0.895上から順に読みます。
- Instances 17、Images 4。 COCO8はスモークテスト用です。4枚の画像ではリリースの判断を裏付けられないため、すべての数値を参考例として扱ってください。
- mAP50 0.943、mAP50-95 0.669。 ほとんどの物体は検出できていますが、多くのボックスが緩すぎます。差が大きい場合、弱点は検出ではなく位置特定です。
personのAP50-95は0.387。 最も一般的なクラスが最も弱いクラスです。これがボトルネックです。- P 0.551、R 0.962。 これらの列は、予測に使う0.25ではなく、クラス全体のF1を最大化する単一の信頼度(ここでは低いしきい値)で読み取ります。この値を「モデルの適合率」として引用しないでください。
クラスごとのAPとリリース時のしきい値#
同じ実行結果には、クラスごとのAPと、各信頼度しきい値における適合率および再現率が記録されています。そのため、推測ではなく目標に基づいてしきい値を選べます。
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
metrics = model.val(data="coco8.yaml", plots=False, verbose=False)
box = metrics.box

# Per-class AP from the same run: the average hides the weakest class
for i, c in enumerate(box.ap_class_index):
    print(f"{model.names[int(c)]:13} AP50={box.ap50[i]:.3f}  AP50-95={box.ap[i]:.3f}")

# Precision and recall at every confidence threshold for one class
row = list(box.ap_class_index).index(0)  # class 0 = person
for conf in (0.1, 0.25, 0.5, 0.75):
    j = int(conf * (len(box.px) - 1))
    print(f"person @ conf {conf:.2f}: precision {box.p_curve[row, j]:.2f}, recall {box.r_curve[row, j]:.2f}")
all 4 17 0.551 0.962 0.943 0.669
person AP50=0.848 AP50-95=0.387
dog AP50=0.995 AP50-95=0.597
horse AP50=0.995 AP50-95=0.696
elephant AP50=0.828 AP50-95=0.545
umbrella AP50=0.995 AP50-95=0.895
potted plant AP50=0.995 AP50-95=0.895
person @ conf 0.10: precision 0.63, recall 0.80
person @ conf 0.25: precision 1.00, recall 0.54
person @ conf 0.50: precision 1.00, recall 0.40
person @ conf 0.75: precision 1.00, recall 0.14これで、しきい値は感覚ではなく判断ルールになります。
| 判断基準に基づく目標 | 選択 | この実行結果の場合 |
|---|---|---|
| アラートの誤りは最大5%(適合率 ≥ 0.95) | 再現率を最大限維持するため、条件を満たす最も低いしきい値 | 0.25:適合率1.00、再現率0.54 |
| 見逃すのは最大で5人に1人(再現率 ≥ 0.80) | 適合率を最大限維持するため、条件を満たす最も高いしきい値 | 0.10:適合率0.63、再現率0.80 |
ここではどちらも十分ではありません。適合率を高くすると対象者の半数を見逃し、再現率を高くするとアラートの3分の1が誤りになります。これはしきい値の問題ではなく、「改善継続」が必要であることを示す証拠です。検証では、BoxPR_curve.png、BoxP_curve.png、BoxR_curve.png、BoxF1_curve.png、confusion_matrix.pngも実行フォルダーに保存されるため、プロットから同じトレードオフを読み取れます。パフォーマンス指標ガイドでは、各指標について説明しています。
次に修正する点#
混同行列を見ると、弱いクラスが何と誤認されているかが分かります。forkliftのAPが低く、フォークリフトがpallet_jackとして予測されているなら、問題は位置特定ではなくクラスの混同です。視覚的な違いが分かる例を追加するか、後続のコードでクラスを分けて扱う必要がなければ統合してください。モデル評価の分析ガイドでは、このワークフローを説明しています。
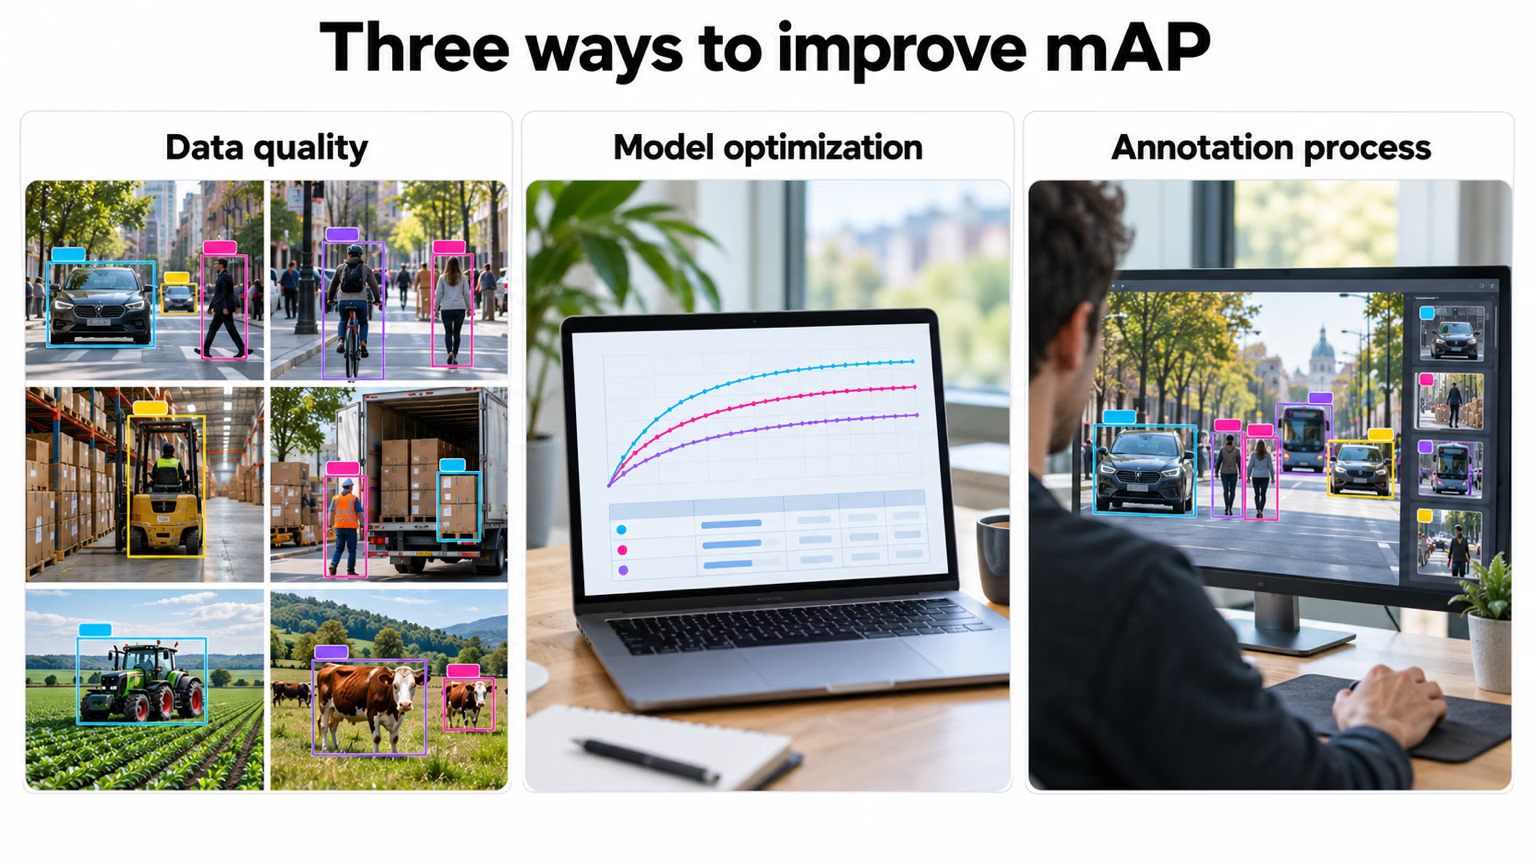
ほとんどの修正は、1番目と3番目のパネル、つまりボトルネッククラスのデータとラベルの改善に該当します。モデルや学習設定を変更するのは、前の3つのレッスンで扱ったデータチェックに合格してからにしてください。
| 固定したテストセットでの根拠 | 判断 |
|---|---|
| ビジネス上重要なすべてのクラスが適合率と再現率の目標を満たしている | リリースして、監視します |
| 1つのクラスまたは条件が目標を満たしていない | 改善継続:そのギャップを埋めるためのデータとラベルを追加します |
| すべてのクラスが目標を大きく下回っている、またはクラス間の見た目が似ている | タスク仕様、クラス、またはカメラの設定を再検討します |
よくある落とし穴#
mAPが0.83でも、あるクラスの値が0.40であることは隠れてしまいます。そのクラスがビジネス価値を担うなら、モデルは0.83ではありません。見栄えのよい平均値に隠れた、機能不全のモデルです。
症状: 「スコアは0.94」のモデルなのに、計測や切り抜きには緩すぎるボックスが描画されます。対処法: mAP50-95を報告し、mAP50との差を位置特定性能の指標として確認します。
症状: 数十枚の画像、または学習セットとほぼ同じ画像から、完璧に見える数値が得られます。対処法: 重要なクラスごとに検証データを数百インスタンスまで増やし、指標を確認する前に、前のレッスンで説明した近似重複チェックを実行します。
解答を表示
評価結果:yolo26n.pt の人物カウンター、COCO8検証
ボトルネックはperson で、AP50-95は0.387です。全体の0.669を下回っています。また、インスタンス数が最も多いクラスでもあり(17件中10件)、最も性能が低いだけでなく、人物カウンターにとって最も重要なクラスです。AP50は0.848なので、モデルは大半の人物を検出できていますが、ボックスの範囲が広すぎます。位置やサイズを測定する用途ほどではありませんが、カウントにも影響します。
適合率を0.95以上にする場合、条件を満たす最小のしきい値はconf 0.25です。このとき適合率は1.00ですが、再現率はわずか0.54で、人物のほぼ半数を見逃します。再現率を0.80以上にするにはconf 0.10が必要ですが、その場合、カウントの3分の1が誤検出になります。
判断:改善を続けます。デプロイ先のカメラから人物のデータを収集してラベル付けします。特に、小さい人物、遮蔽された人物、フレーム端の人物を重点的に収集します。その後、数百人分のデータで構成した固定テストセットを使って再検証します。検証画像が4枚では、デプロイの判断をどちらにする場合でも根拠として不十分です。