アノテーション品質
YOLOラベルに含まれる内容を把握し、不正な行があるラベルファイルをlintし、ガイドラインと測定可能なキャリブレーションラウンドでアノテーター間の一貫性を保ちます。
一貫性のないラベルで学習したモデルは、その不一致を学習します。明確な1つのルールで作成した5万個のバウンディングボックスは、個々に異なる20通りの解釈で作成した50万個よりも有効です。また、ラベルの付け直しは、より大きなモデルを使うよりもほぼ常に低コストです。このレッスンでは、ラベルlintツール、1ページのガイドライン、アノテーター間の一致度を示す数値を用意します。
実践的
ラベルの実際の内容#
YOLO形式では、各画像に対応する.txtファイルがあり、各オブジェクトにつき1行が記録されています。座標は画像の幅と高さを基準に0~1に正規化されるため、リサイズ後もラベルは維持されます。行の形式はタスクによって異なります。
| タスク | ラベルの種類 | 説明 |
|---|---|---|
| 検出 | class x_center y_center width height | ボックスの中心とサイズ |
| インスタンスセグメンテーション | class x1 y1 x2 y2 ... xn yn | ポリゴンの輪郭 |
| 姿勢推定 | class x y w h px1 py1 v1 ... pxn pyn vn | ボックスと、必要に応じて可視性を含むキーポイント |
| OBB | class x1 y1 x2 y2 x3 y3 x4 y4 | 回転ボックスの四隅 |
| 分類 | ラベルファイルなし | クラスごとに1つのフォルダーへ画像を分類 |
| セマンティックセグメンテーション | 画像ごとに1つのPNGマスク | 各ピクセル値はクラスインデックスです |
| 深度推定 | 画像ごとに1つの深度PNGまたはNPY | 各ピクセル値は距離です |
クラスインデックスは0から始まり、データセットYAML内の名前に対応します。オブジェクトのない画像にはラベルファイルは不要です。これが背景画像の扱いです。物体検出形式、セマンティックセグメンテーション、深度推定のデータセットページに、動作例が掲載されています。
ラベルファイルをlintする#
不正な行はエラーが通知されないまま処理されます。1を超える座標、YAMLに定義されていないクラスID、同じオブジェクトに対する重複ボックスはいずれも、モデルが学習しようとするノイズになります。短いlintツールを使えば、学習前に検出できます。
from itertools import combinations
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

def iou(a, b):
    """IoU of two normalized (x_center, y_center, width, height) boxes."""
    ax1, ay1, ax2, ay2 = a[0] - a[2] / 2, a[1] - a[3] / 2, a[0] + a[2] / 2, a[1] + a[3] / 2
    bx1, by1, bx2, by2 = b[0] - b[2] / 2, b[1] - b[3] / 2, b[0] + b[2] / 2, b[1] + b[3] / 2
    inter = max(0, min(ax2, bx2) - max(ax1, bx1)) * max(0, min(ay2, by2) - max(ay1, by1))
    return inter / (a[2] * a[3] + b[2] * b[3] - inter)

def check_labels(text, names):
    """Return a list of problems in one YOLO detection label file."""
    problems, boxes = [], []
    for i, row in enumerate(text.split("\n"), 1):
        values = row.split()
        if not values:
            continue
        if len(values) != 5:
            problems.append(f"row {i}: {len(values)} values, expected 5")
        elif int(values[0]) not in names:
            problems.append(f"row {i}: unknown class {values[0]}")
        elif not all(0 <= float(v) <= 1 for v in values[1:]):
            problems.append(f"row {i}: coordinates outside 0-1")
        else:
            boxes.append((i, int(values[0]), [float(v) for v in values[1:]]))
    for (i, ca, a), (j, cb, b) in combinations(boxes, 2):
        if ca == cb and iou(a, b) > 0.8:
            problems.append(f"row {j}: duplicate of row {i} (IoU {iou(a, b):.2f})")
    return problems

broken = "0 0.50 0.50 0.20 0.30\n0 0.51 0.50 0.20 0.30\n3 0.40 0.40 0.10 0.10\n0 1.20 0.50 0.10 0.10\n0 0.50 0.50 0.10"
print("\n".join(check_labels(broken, {0: "pill"})))

data = check_det_dataset("medical-pills.yaml")
files = sorted(Path(data["path"], "labels").rglob("*.txt"))
found = sum(len(check_labels(f.read_text(), data["names"])) for f in files)
print(f"medical-pills: {found} problems in {len(files)} label files")
row 3: unknown class 3
row 4: coordinates outside 0-1
row 5: 4 values, expected 5
row 2: duplicate of row 1 (IoU 0.90)
medical-pills: 0 problems in 115 label files手作業で作成したサンプルには、lintツールが検出する各エラーが含まれており、実際のデータセットは問題なく処理されます。ラベル付けの各バッチ後と学習の各実行前にツールを実行してください。数秒で完了します。
ラベルにばらつきが生じる理由#
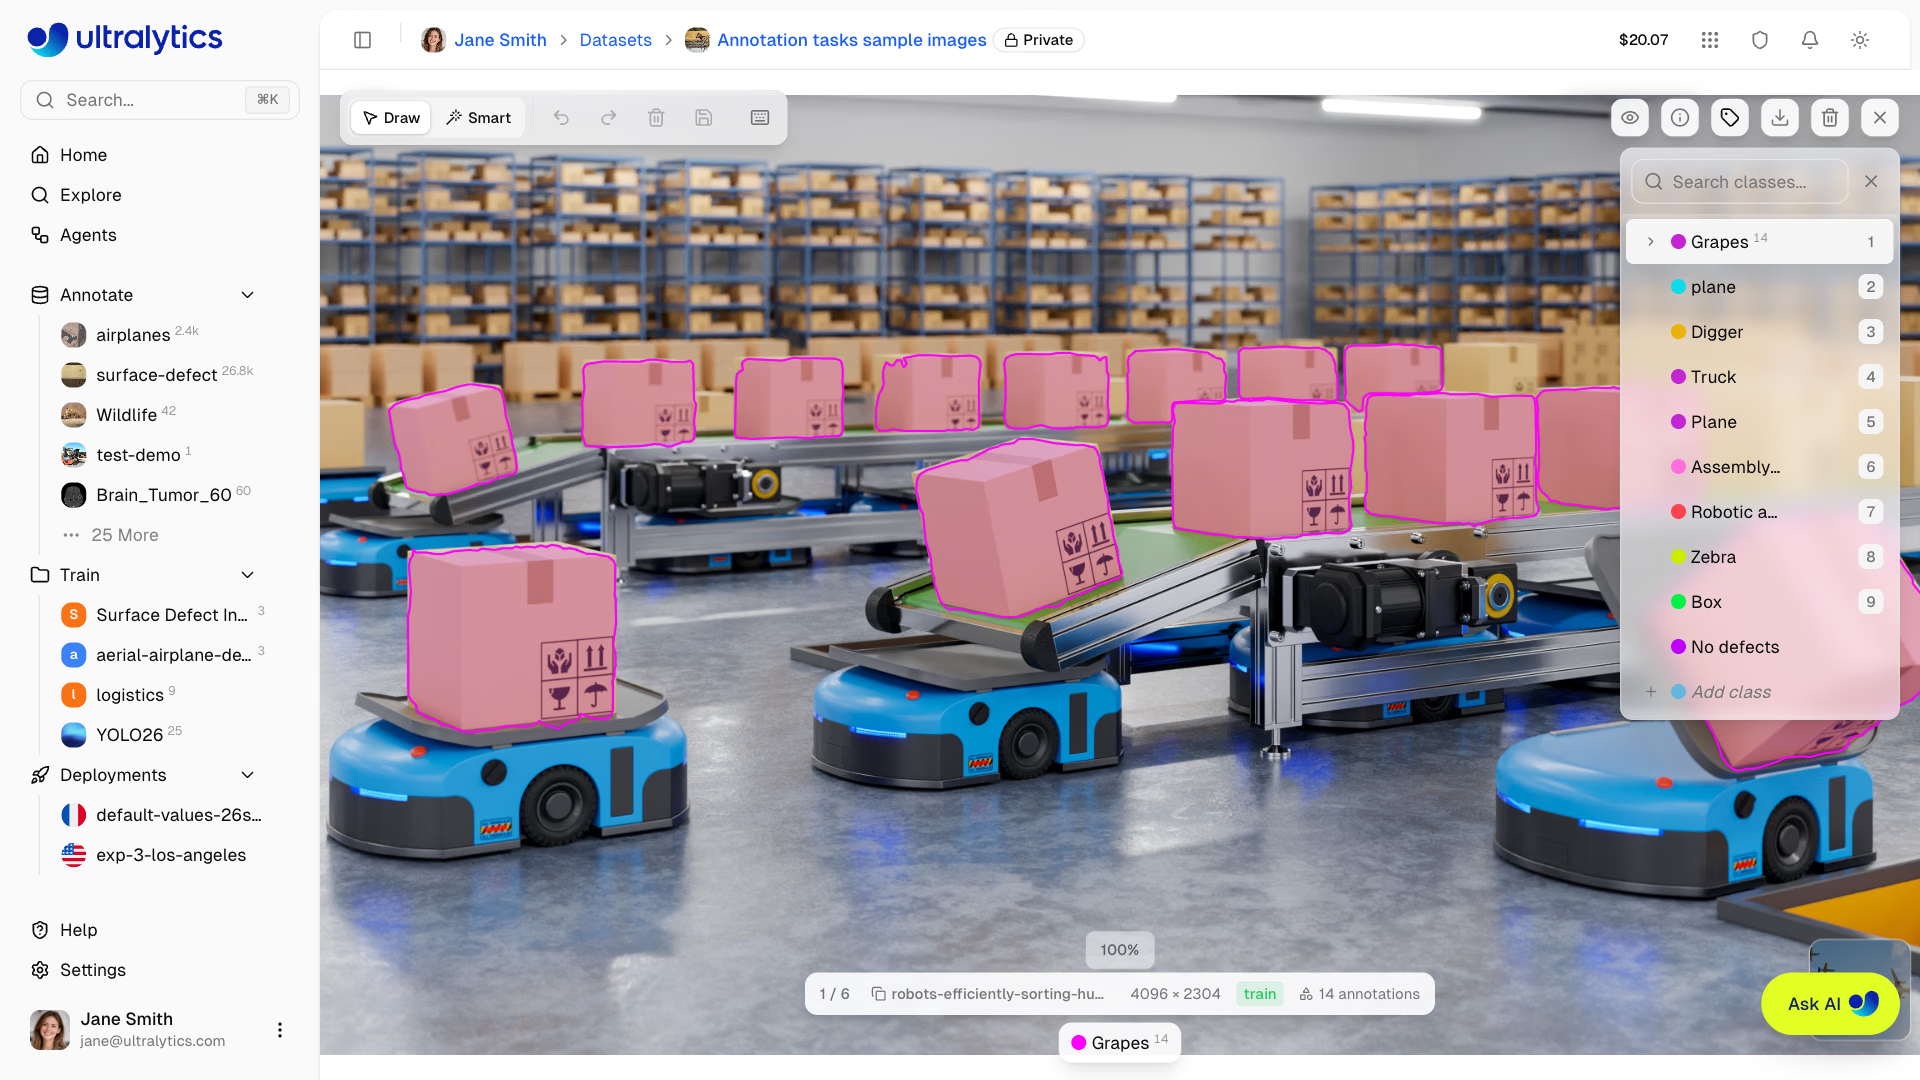
このエディターのクラスパネルを見てください。14個の段ボール箱のポリゴンはGrapesに保存されています。その下にはBoxクラスがあり、さらにplaneとPlaneが別々のクラスとして存在します。各行は有効なため、lintツールではどちらの問題も検出できません。しかし、ガイドラインに照らしてラベルを確認するレビュアーなら、数秒で両方を見つけられます。ラベルの誤りの多くはこのようなものです。ファイルは有効でも、判断が間違っています。
アノテーターが不注意で不適切なラベルを付けることは、ほとんどありません。ルールが曖昧なために一貫性が保たれず、それぞれが妥当ながら異なる判断をするのです。
- ボックスはどこまで含めますか? 影、持ち運んでいるバッグ、フォークリフトのフォーク上の荷物は含めますか?
- フレーム外へのはみ出し。 人物の半分がフレーム外にある場合も
personとして扱いますか?どの程度見えていれば対象にしますか? - オクルージョン。 車が片方の車輪しか見えていない場合、ラベルを付けますか、それとも対象外にしますか?
- クラスの境界。 ピックアップトラックは
carですか、それともtruckですか?スクーターはbicycleですか、それともotherですか? - ラベル付けしない対象。 オブジェクトが映っている反射、ポスター、画面。
全員が同じ判断をする限り、どの選択でも問題ありません。
1ページのガイドライン#
1ページに収め、各ルールに例画像を付け、境界事例を最初に示します。
## Class: forklift

Include:
- Forklifts with at least 30% of the body visible, moving or parked, any size or color.

Do not label:
- Pallet jacks (no overhead mast) → class `pallet_jack`.
- Reflections in glass or polished floors, and forklifts on posters or screens.

Box rules:
- Include the mast and the full visible body.
- Exclude the load (pallets, boxes) — those have their own classes.
- For partly occluded forklifts, box the visible part only.キャリブレーションラウンドで一致度を測定する#
アノテーターを1人から20人に増やす前に、全員が同じ50枚の画像にラベルを付け、次の項目を比較します。
一致度とは、両方のアノテーターが同じクラスを割り当て、IoUが0.5以上となるように描画したオブジェクトの割合です。これは評価者間信頼性を実務的に測る方法です。
def iou(a, b):
    """IoU of two (x1, y1, x2, y2) pixel boxes."""
    w = max(0, min(a[2], b[2]) - max(a[0], b[0]))
    h = max(0, min(a[3], b[3]) - max(a[1], b[1]))
    inter = w * h
    return inter / ((a[2] - a[0]) * (a[3] - a[1]) + (b[2] - b[0]) * (b[3] - b[1]) - inter)

def agreement(boxes_a, boxes_b, threshold=0.5):
    """Share of objects both annotators drew with the same class and IoU >= threshold."""
    unmatched, matched = list(boxes_b), 0
    for cls_a, box_a in boxes_a:
        best = max(unmatched, key=lambda b: iou(box_a, b[1]) if b[0] == cls_a else -1, default=None)
        if best and best[0] == cls_a and iou(box_a, best[1]) >= threshold:
            unmatched.remove(best)
            matched += 1
    return matched / max(len(boxes_a), len(boxes_b))

# Two annotators label the same calibration image
alice = [("forklift", (100, 200, 400, 600)), ("person", (450, 220, 520, 480)), ("person", (600, 230, 660, 470))]
bob = [("forklift", (100, 120, 400, 600)), ("person", (452, 218, 522, 478)), ("pallet_jack", (600, 230, 660, 470))]
print(f"agreement: {agreement(alice, bob):.0%}")
agreement: 67%一致率67%の中には、2種類の不一致が隠れています。Bobが描いたフォークリフトのボックスは80ピクセル高い位置から始まっています。マストの先端を含めたためですが、それでもIoUは0.83で一致と判定されます。製品で高さを測定する場合は、ボックスのルールを厳密にしてください。3つ目のオブジェクトは実際に意見が分かれています。Aliceはperson、Bobはpallet_jackと判断しています。より明確なルールと例画像を用意し、もう一度ラウンドを実施する必要があります。キャリブレーションに使った50枚の画像は保管してください。新しいアノテーター全員のオンボーディングテストとして活用できます。
レビュアーが黙ってラベルを修正すると、フィードバックループが失われ、アノテーターは何を間違えたのか学べません。理由を添えて却下し、アノテーターに修正してもらいます。最初の100枚では時間がかかりますが、その後は大幅に速くなります。
追跡する項目#
| 指標 | 分かること |
|---|---|
| 処理量(1時間あたりのオブジェクト数) | 処理能力とコスト |
| 却下率 | 品質が低下しているかどうか |
| 共通の重複対象セットに対する一致度 | アノテーターが引き続き同じルールを適用しているかどうか |
一致度が低下した場合は、何かが変わっています。新しいアノテーター、新しいカメラ、曖昧なバッチ、疲労などが原因です。後にモデルが特定の条件で失敗したら、その画像をそのままラベル付けに戻します。このサイクルはアクティブラーニングで自動化でき、実環境での精度向上の大部分はこのサイクルから得られます。Ultralytics Platform上のデータセットで失敗例を閲覧・絞り込み、規模を拡大して運用する方法についてはデータセットの品質管理とアノテーションのベストプラクティスをご覧ください。
解答を表示
10枚の画像を使ったキャリブレーションラウンド後に作成した、medical-pillsのpillクラス向けガイドライン:
## Class: pill

Include:
- Every tablet inside a blister cavity, including half-visible ones at the image edge.
- Tablets seen through clear plastic, even when glare covers part of them.

Do not label:
- Empty cavities, torn foil, or tablets outside the pack.
- Reflections of tablets in the foil.

Box rules:
- Box the tablet itself, not the plastic bubble around it.
- If two tablets touch, draw two boxes.一致度スコアの読み方:最初のラウンドのスコアが82%だったとします。不一致のオブジェクトを原因別に並べます。ブリスターパックでは、よくある原因が2つあります。錠剤ではなくプラスチックのくぼみを囲んでボックスを描いたケース(最初のボックスルールと例画像で修正)と、グレアで見えにくい錠剤を一方のアノテーターが対象外にしたケース(2つ目の対象に含めるルールで修正)です。新しい画像10枚を使って再実行し、スコアが90%の基準を超えてから規模を拡大します。