ボックスとマスク: セグメンテーションが本当に必要な場合
実画像でマスクがボックスよりどれだけ有用かを測定し、出力を利用する後段の処理に基づいて、プロジェクトに形状情報が必要かどうかを判断します。
AIビジョンを思い浮かべたとき、多くの人がイメージするのはマスクです。また、ラベリング予算を最も多く消費するのもマスクです。マスクは物体の正確な形状を示し、ボックスは物体の位置だけを示します。この違いは製品の方向性を大きく左右することもありますが、ほとんどの製品では何も変わりません。
実践的
マスクで分かること#
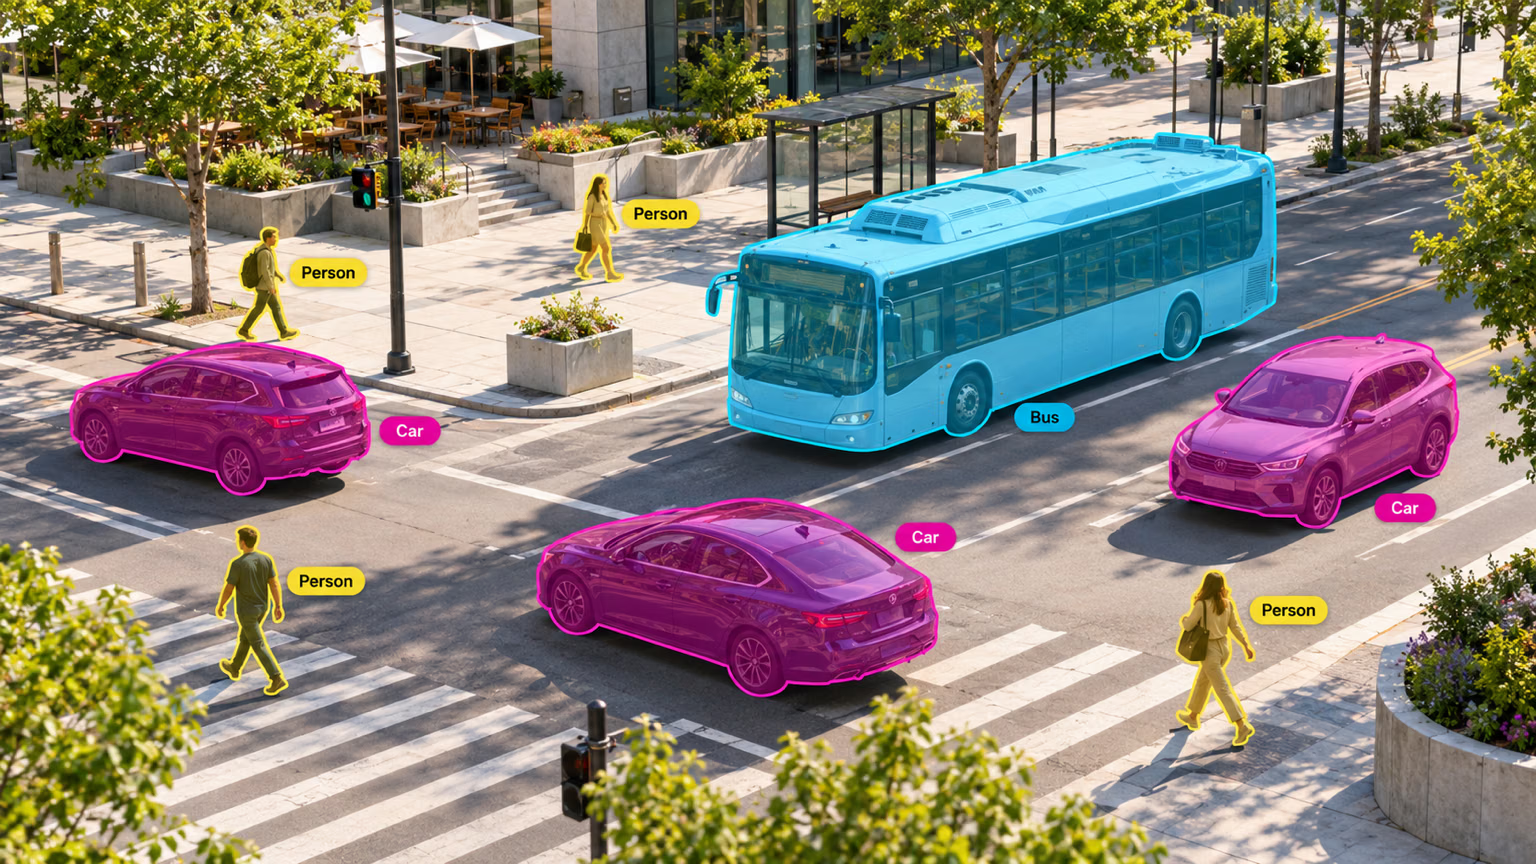
各物体について、Segmentタスクは検出器が返す情報(クラス、ボックス、信頼度)に加えて、物体に属するピクセルも返します。そのため、上の画像では各車にそれぞれ輪郭が付き、バスや歩行者とは区別されます。マスクはポリゴン(masks.xy)またはバイナリ画像(masks.data)として読み取れます。
形状によって数値はどのくらい変わるでしょうか。各物体について、ボックスの面積とマスクの面積を比較します。
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
result = model("https://ultralytics.com/images/bus.jpg", retina_masks=True, verbose=False)[0]

for box, mask in zip(result.boxes, result.masks.data):
    x1, y1, x2, y2 = box.xyxy[0].tolist()
    box_area = (x2 - x1) * (y2 - y1)
    mask_area = float(mask.sum())  # pixels inside the object's mask
    name, ratio = result.names[int(box.cls)], mask_area / box_area
    print(f"{name:7} box={box_area:7.0f} px  mask={mask_area:7.0f} px  ({ratio:.0%})")
person box= 97116 px mask= 49331 px (51%)
person box= 68102 px mask= 21316 px (31%)
bus box= 410093 px mask= 255265 px (62%)
person box= 55998 px mask= 33524 px (60%)
person box= 23690 px mask= 11109 px (47%)バスがボックス内で占めるのはわずか62%で、人物の1人は31%です。塗装面積、こぼれた量、棚の空き具合など、ボックスだけから計算した数値には、その割合分の誤差が生じます。製品がこのような数値を報告する場合はマスクが必要です。カウントや位置特定だけなら、追加のピクセル情報があっても結果は変わりません。
症状: マスクの面積がボックスの面積より3~4倍小さく見えます。原因: デフォルトではmasks.dataは推論時のサイズ(ここでは640×480)で返される一方、ボックスは元画像のピクセル座標(1080×810)で表されます。対処法: 前述のようにretina_masks=Trueを渡すか、自分で数値をスケーリングします。
デモではなく、出力を利用する側の要件に基づいて判断する#
| 後段の処理で必要なこと | ボックスで十分か | 理由 |
|---|---|---|
| 物体を数える、または存在を確認する | はい | 位置が分かれば十分です |
| 物体がゾーンに入ったときにアラートを出す | はい | ボックスがラインを越えたことが分かれば十分です |
| フレームをまたいで物体を追跡する | はい | トラッカーはボックスを対応付けます |
| 2つ目の分類器に渡すために切り抜く | はい | 切り抜きにはボックスだけあれば十分です |
| 面積や占有率を測定する(雑草、さび、こぼれ) | いいえ | 不規則な形状では、ボックスの面積に意味がありません |
| 物体を切り抜く(背景除去、AR) | いいえ | 正確な輪郭が必要です |
| クリアランスや接触を確認する(ロボットの把持、衝突) | いいえ | ボックスは物体を実際より大きく見積もります |
| 接触した不規則な物体を分離する | 多くの場合、いいえ | 重なったボックスでは、どのピクセルがどの物体に属するかが曖昧になります |
製品で必要な各項目がすべて「はい」なら、検出器を使ってください。形状情報が役立つ場合に限り、YOLO26のセグメンテーションを検討してください。
インスタンスセグメンテーションとセマンティックセグメンテーション#
インスタンスセグメンテーションでは、各物体に個別のマスクを付けるため、重なった車が3台あれば、3台それぞれを区別できます。セマンティックセグメンテーションでは、各ピクセルにクラスだけを割り当てます。すべての車のピクセルが1つの「車」領域になり、台数は分からなくなります。細胞、果物、不良品など、個々の物体を数えたり測定したりする場合はインスタンスセグメンテーションを使います。道路と歩道、作物と土壌など、領域の占有率を測定する場合はセマンティックセグメンテーションを使います。
形状のラベリングにかかるコスト#
ボックスの作成はクリック2回で済みます。適切なポリゴンの作成には数十回のクリックが必要になることもあり、輪郭のすべての部分でアノテーターの判断が分かれる可能性があります。バッグは人物に含めるべきか、影は車の一部か、といった問題です。経験則を鵜呑みにせず、自分でコストを測定してください。アノテーターが20個の物体をボックスでラベリングする時間と、同じ20個をポリゴンでラベリングする時間を計り、その差にデータセットの規模を掛けます。
AI支援ツールを使うと、この差の大部分を縮められます。スマートアノテーションと一括ラベリングでは、クリックまたはボックスからマスクを提案するため、アノテーターは輪郭をなぞるのではなく修正できます。ただし、すべての境界を人が確認する必要があります。
アノテーション開始前に、オクルージョン、透明な物体、影、フレーム端で切れている物体、付属物(バッグ、取っ手、荷物)の扱いを決め、アノテーターとレビュアーの両方に同じ資料を渡します。アノテーションのベストプラクティスではルールの徹底方法を説明し、COCO-Segデータセットでは大規模データにおける一貫したマスクを確認できます。
マスクをサンプル確認するときは、はみ出し(マスクが輪郭の外に広がる)、穴(物体内の領域が抜けている)、偽の輪郭(マスクがJPEGのアーティファクトをなぞっている)、曖昧な部分(スーツケースの持ち手はスーツケースのマスクに含めるべきか)を確認します。
解答を表示
同じバスのカメラ映像を共有する製品が2つあるとします。歩行者カウンターと、車両がシーンのどれだけを占めるかを示す道路占有率レポートです。同じ実行結果から、両方の数値を測定します。
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
result = model("https://ultralytics.com/images/bus.jpg", retina_masks=True, verbose=False)[0]
height, width = result.orig_shape

for name in sorted({result.names[int(c)] for c in result.boxes.cls}):
    rows = [i for i, c in enumerate(result.boxes.cls) if result.names[int(c)] == name]
    union = result.masks.data[rows].amax(dim=0)  # merge masks so overlaps count once
    box_union = sum(float((b[2] - b[0]) * (b[3] - b[1])) for b in result.boxes.xyxy[rows])
    print(f"{name:6} {len(rows)} objects | masks cover {float(union.sum()) / (height * width):.0%} of the image, boxes {box_union / (height * width):.0%}")
bus 1 objects | masks cover 29% of the image, boxes 47%
person 4 objects | masks cover 13% of the image, boxes 28%- 歩行者カウンター → ボックス。どちらを使っても人数は4人です。マスクはラベリングコストを増やすだけで、結果は変わりません。
- 占有率レポート → マスク。ボックスでは、バスがシーンの47%を占めると判定されますが、実際には29%です。ボックスに基づくレポートでは、誤差が半分を超えます。