問題を定義する
漠然とした製品アイデアを3行のタスク仕様に落とし込み、再学習せずに変更できるよう、ビジネスルールをコードに記述します。
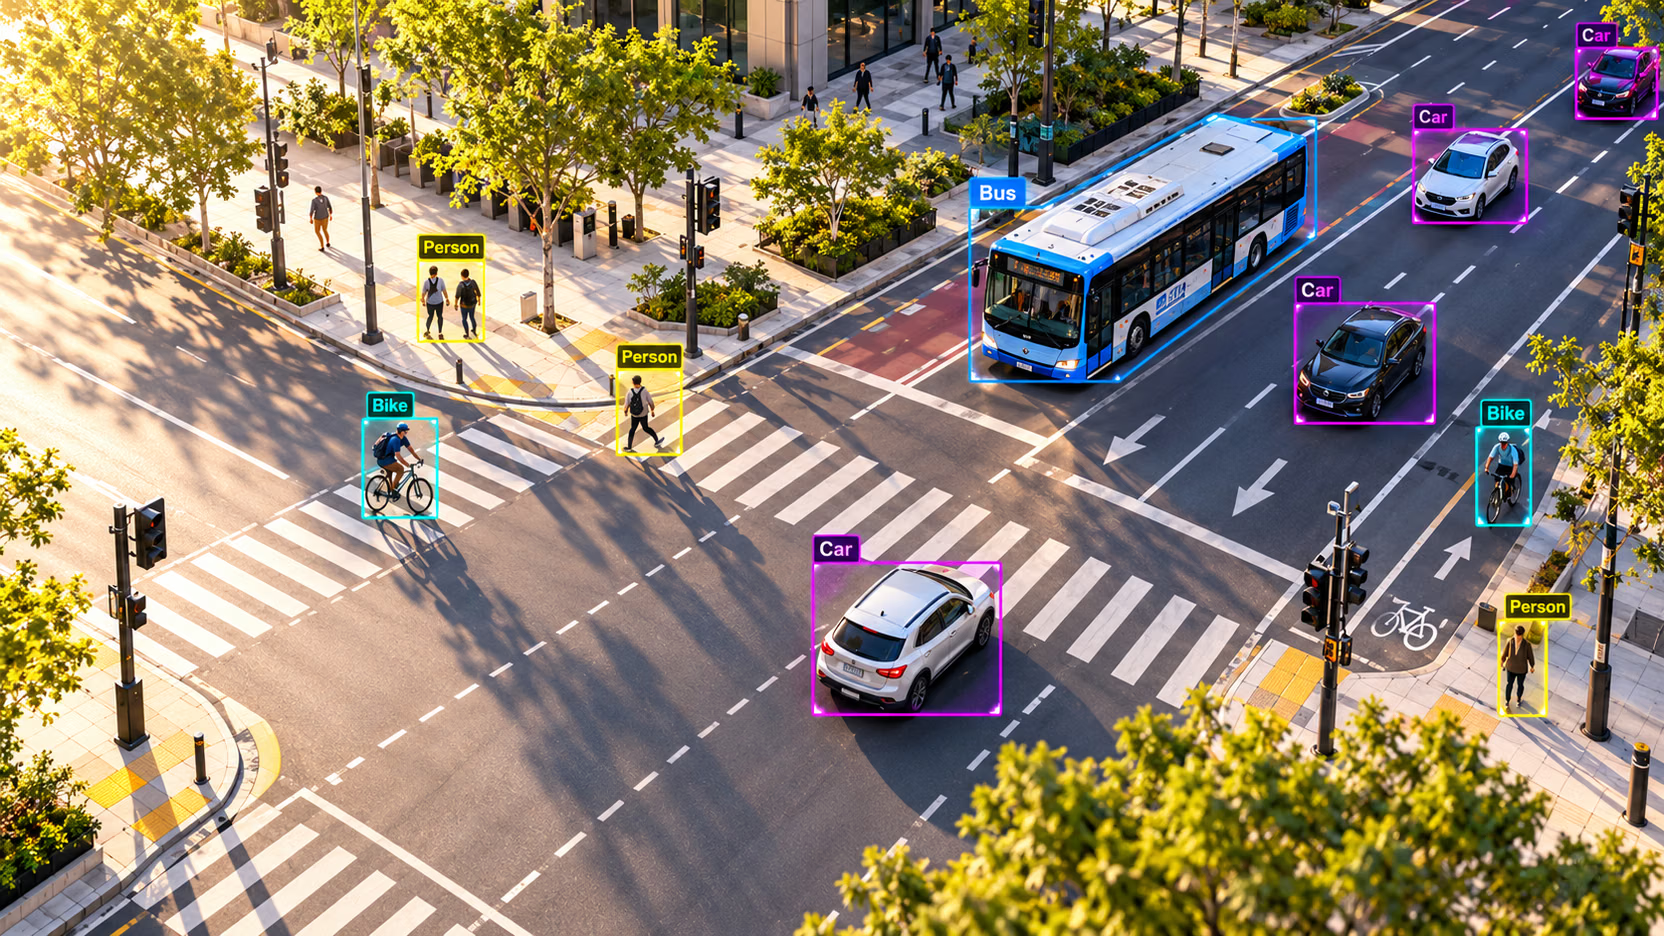
明確な問いがないまま停滞するコンピュータービジョンプロジェクトは少なくありません。「危険な行動を検出する」は要件のように聞こえますが、アノテーターはラベル付けできず、モデルは学習できず、誰も正常に機能する基準を判断できません。3行の仕様を作れば、午後のうちにこの問題を解決でき、学習するタスク、ラベル付けする内容、報告する指標も決まります。
実践的
仕様を最初に作る理由#
コンピュータービジョンプロジェクトの各ステップは、ステップ0で設定した目標を引き継ぎます。曖昧な問いは、曖昧なデータセット、意見の一致しないアノテーター、誤った対象を測定する指標につながります。ステップ2でどれだけ学習しても、それを修正することはできません。
3行の仕様#
タスク仕様は3つの文で構成し、1行に1文ずつ記述します。それぞれ、プロジェクトに関わる別の担当者が尋ねる質問に答えます。
| 行 | 答える質問 | 不十分 | 適切 |
|---|---|---|---|
| 入力 | モデルには何が見えますか? | 「カメラ映像」 | 「12台の天井カメラから取得する、1920×1080、5 fpsのフレーム」 |
| 出力 | どのようなデータが返されますか? | 「安全上の問題を検出する」 | 「forkliftとpersonのボックス。それぞれに信頼度スコアを付与」 |
| 判定 | 誰が、いつ行動しますか? | 「安全性を高める」 | 「フォークリフトと人が2秒間、2 m以内にいる場合、シフト責任者に通知する」 |
出力の行は特に慎重に決める必要があります。データ型によってタスクが決まるためです。

画像全体に対するラベルなら分類、ボックスなら検出、輪郭ならセグメンテーション、関節なら姿勢推定、回転ボックスならOBB、ピクセルごとのクラスまたは距離ならセマンティックセグメンテーションまたは深度推定です。次のレッスンでは7つすべてを解説します。
例:モデルとルールを分ける#
「倉庫内でフォークリフトが危険な動きをしているかどうかを把握したい」
これはタスクではなく、プロジェクトの説明です。ピクセルに関わるフォークリフトや人の検出と、何を危険とみなすかというポリシー上の判定という、2つの作業が混在しています。切り分けてみましょう。
モデルとなるのは検出器だけです。ひし形の部分は通常のコードです。今すぐこの切り分けを試せます。bus.jpgにはフォークリフトは写っていませんが、バスと4人の人で同じテストができます。最初のルールとして、「人のボックスの30%を超える部分が、車両のボックスと重なったらアラートを出す」とします。
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
result = model("https://ultralytics.com/images/bus.jpg", verbose=False)[0]

# The model's job ends here: a class, a box, and a confidence per object.
people = [b.xyxy[0].tolist() for b in result.boxes if result.names[int(b.cls)] == "person"]
vehicles = [b.xyxy[0].tolist() for b in result.boxes if result.names[int(b.cls)] == "bus"]

def share_inside(a, b):
    """Fraction of box a's area that lies inside box b."""
    w = max(0, min(a[2], b[2]) - max(a[0], b[0]))
    h = max(0, min(a[3], b[3]) - max(a[1], b[1]))
    return w * h / ((a[2] - a[0]) * (a[3] - a[1]))

# The decision rule is plain code: change the policy without retraining.
ALERT_SHARE = 0.30
for person in people:
    share = max(share_inside(person, v) for v in vehicles)
    print(f"person at x={person[0]:3.0f}: {share:4.0%} inside the bus box -> {'ALERT' if share > ALERT_SHARE else 'ok'}")
person at x= 49: 70% inside the bus box -> ALERT
person at x=223: 76% inside the bus box -> ALERT
person at x=670: 70% inside the bus box -> ALERT
person at x= 0: 62% inside the bus box -> ALERTアラートは4件、すべて誤検知でした。人々は、停車中のバスの前方にある歩道にいます。検出器はすべてのボックスを正しく検出していますが、ルールが誤っています。2D画像上の重なりは、現実世界で2つの物体が近くにあることを意味しないためです。ルールはコードなので、コードを修正すれば解決できます。各人の足元とバスの車輪のラインの位置を比較します。
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
result = model("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
people = [b.xyxy[0].tolist() for b in result.boxes if result.names[int(b.cls)] == "person"]
vehicles = [b.xyxy[0].tolist() for b in result.boxes if result.names[int(b.cls)] == "bus"]

def same_ground_line(person, vehicle, tolerance=40):
    """True when the person's feet are level with the vehicle's wheels and inside its width."""
    feet_x, feet_y = (person[0] + person[2]) / 2, person[3]
    return vehicle[0] < feet_x < vehicle[2] and abs(feet_y - vehicle[3]) < tolerance

for person in people:
    alert = any(same_ground_line(person, v) for v in vehicles)
    print(f"person at x={person[0]:3.0f}: feet y={person[3]:.0f}, bus wheels y={vehicles[0][3]:.0f} -> {'ALERT' if alert else 'ok'}")
person at x= 49: feet y=902, bus wheels y=751 -> ok
person at x=223: feet y=861, bus wheels y=751 -> ok
person at x=670: feet y=880, bus wheels y=751 -> ok
person at x= 0: feet y=871, bus wheels y=751 -> ok全員の足元は車輪のラインより110~150ピクセル下にあるため、バスよりカメラに近い位置に立っています。再学習も再ラベル付けも必要ありません。検出器を固定したまま、安全チームがルールを改善できます。本番環境では、キャリブレーション済みカメラで足元を床面座標に変換し、物体追跡で2秒間の継続性を追加します。いずれも同じボックスを使ったコードで実現できます。
主観的な言葉である「unsafe(危険)」「defective(欠陥あり)」「suspicious(疑わしい)」「VIP」は、モデルの出力を読み取るコードに含めます。モデルはピクセルに関する質問に答えます。2人の専門家がラベルについて意見を異にするなら、その議論はバージョン管理、テスト、変更ができるルールに含めます。
よくある落とし穴#
症状: 仕様に「安全上の問題を検出する」や「シーンを理解する」と書かれていて、アノテーターが何を描けばよいか質問します。対処法: 出力を、名前付きクラスを含むデータ型として書き直します。「forklift と person のボックス」のようにします。
症状: 同じフレームに対して2人のアノテーターが異なるラベルを付ける、suspicious_behavior や dangerous のようなクラスがあります。対処法: 制限区域内にいる人や、開いた状態で固定されたドアなど、目で確認できる根拠に置き換え、判断は意思決定ルールに移します。
症状: 「何が起きているか説明する」(キャプション生成)や「フォークリフトが人にぶつかるか予測する」(予測)になっています。対処法: まず物体を特定し、その上にトラッキングと動作ルールを追加します。予測の前に検出器を構築します。
仕様から成功基準へ#
仕様で定めるのはモデルが何をするかであり、どの程度なら十分か、見逃しと誤報のコストをどう比較するかではありません。Building High-Performance YOLO Datasetsのビジネス目標から始めるでは、仕様を測定可能な目標に落とし込みます。このコースの以降のレッスンでは、3行の仕様を参照します。
解答を表示
棚のカメラの仕様例:
- 入力: 1つの通路に向けた固定カメラから、60秒ごとに取得する1920×1080の静止画。
- 出力:
productとempty_facing(商品がない棚の区画)のバウンディングボックス。それぞれに信頼度スコアを付与します。 - 判定: 営業時間中に、同じ棚の
empty_facingボックスが3つ以上、連続する5枚の静止画にわたって検出された場合、補充タスクを作成します。
モデルが認識できない言葉は、補充タスク、同じ棚、5枚の静止画にわたる継続、営業時間中です。ルールとして記述すると、次のようになります。
if count(empty_facing on shelf S) >= 3 in each of the last 5 stills and store_is_open(now):
    create_restock_task(shelf=S)
店舗は画像を1枚も再ラベル付けせずに、「3」や「5」、営業時間を変更できます。