ラボから本番環境へ
Ultralyticsをインストールし、自分の画像でYOLO26を実行して、出力が仕様に合っているか確認し、次のステップを選びます。
事前学習済みモデルを10分ほど試すだけで、計画全体を左右する疑問に答えられます。既製モデルが自分のクラスとカメラにすでに対応しているのか、それとも独自のデータが必要なのか、という疑問です。このレッスンでは、Ultralyticsをインストールし、実際の画像でYOLO26を実行して、最初のレッスンで作成した仕様と結果を照合します。
実践的
インストール#
pip install ultralytics
yolo checks最初の行では、ultralytics Pythonパッケージとyoloコマンドをインストールします。PyTorchがない場合は、PyTorchもインストールします。yolo checksを実行すると、Python、PyTorch、CUDAのバージョンと、Ultralyticsが使用するハードウェアが表示されるため、実行前にセットアップを確認できます。新しい仮想環境を使用してください。conda、Docker、GPUのセットアップについては、クイックスタートをご覧ください。
ultralyticsパッケージはPython 3.8以降にインストールできますが、現在のPyTorchリリースにはPython 3.10以降が必要です。環境が古い場合は、まず新しいPythonで新しい仮想環境を作成します。
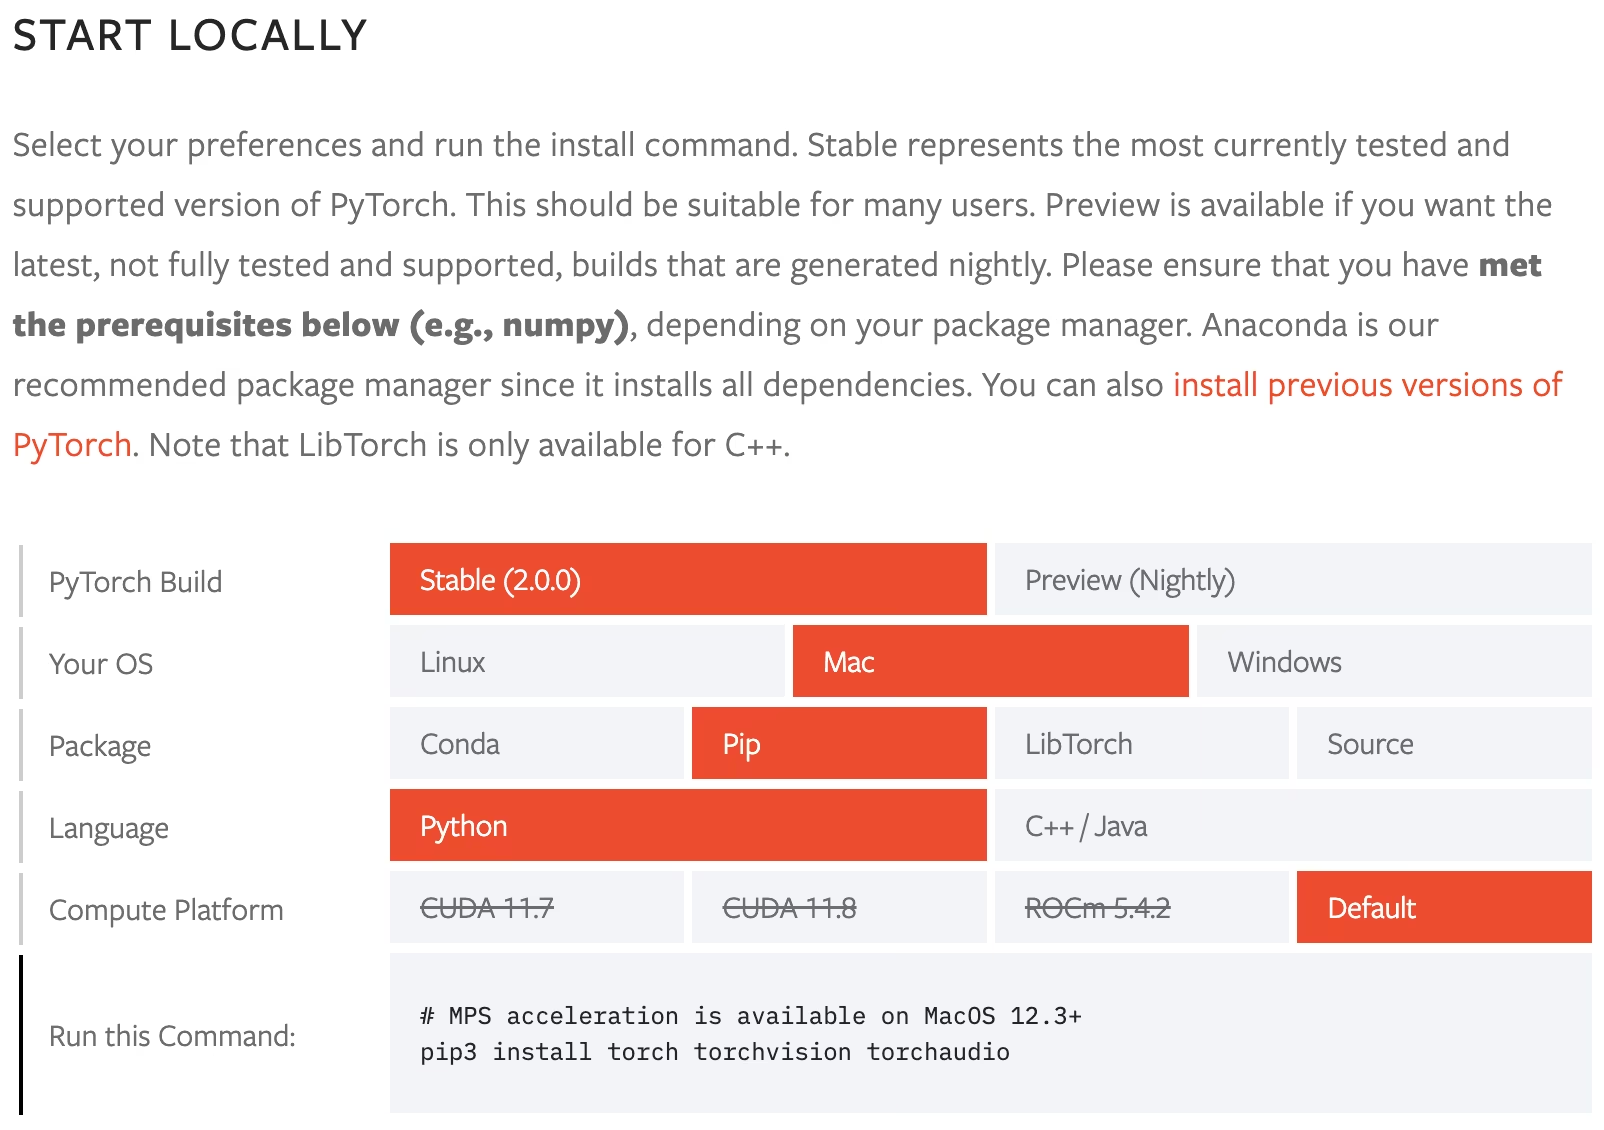
症状: NVIDIA GPU搭載マシンなのにyolo checksがCPUを示し、推論が遅くなります。原因: CPU専用のPyTorchビルドが使われています。たとえば、Windowsではデフォルトのpipホイールが該当します。対処法: 上のPyTorchセレクターでOS、パッケージマネージャー、CUDAのバージョンを選び、表示されたコマンドを実行してから、ultralyticsを再インストールします。スクリーンショットのようにMacではデフォルトのビルドで問題ありません。Apple GPUを使うにはdevice=mpsを渡さない限り、UltralyticsはCPUで実行されます。
最初の予測#
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # 初回使用時に約5 MBのnanoモデルをダウンロードする
results = model("https://ultralytics.com/images/bus.jpg", save=True)

for box in results[0].boxes:
print(model.names[int(box.cls)], round(float(box.conf), 2))どちらの方法でも、画像ごとに1行の概要が出力され、注釈付き画像はruns/detect/predictに保存されます。
image 1/1 .../bus.jpg: 640x480 4 persons, 1 bus, 19.7ms
Speed: 0.9ms preprocess, 19.7ms inference, 0.4ms postprocess per image at shape (1, 3, 640, 480)
Results saved to runs/detect/predict各行を見てみましょう。推論のために画像が640×480にリサイズされ、モデルは人物4人とバス1台を検出しています。ノートPCのCPUでの推論時間は約20ミリ秒です。Speedの行が最初のレイテンシ確認ポイントです。仕様の入力項目に記載したフレームレートと比較してください。保存した画像を開くと、各ボックスに検出レッスンで学んだクラス、ボックス、信頼度が表示されています。
出力を仕様と照合する#
| 質問 | はいの場合 | いいえの場合 |
|---|---|---|
| モデルが認識する80のCOCOクラスに、対象のクラスは含まれていますか。 | 学習なしでプロトタイプを作成します | ラベル付きデータとファインチューニングが必要です(ファインチューニングガイド) |
| 自分の画像で、しきい値を超えるボックスは正しい物体に重なっていますか。 | タスクと視点が一致しています | ドメインギャップを想定し、自分のカメラからデータを収集します |
| 出力の種類は、意思決定の基準で必要とされるものですか。 | タスクを続けます | 重みを切り替えます:-seg、-sem、-depth、-pose、-obb、または-cls |
| 対象ハードウェアで、必要なフレームレートを満たす速度ですか。 | 次に進みます | より小さいモデルか、最適化されたエクスポート形式を試します |
最初の質問には明確に答えられます。model.namesには、事前学習済みモデルが認識するすべてのクラスが一覧表示されています。フォークリフトの仕様では、personはCOCOクラスですが、forkliftは該当しないため、しきい値をどう設定しても事前学習済みモデルはフォークリフトを検出できません。これは初回実行で最もよくある結果で、モデルが仕様の一部にしか対応していない状態です。利用可能なクラスを使って意思決定ロジックのプロトタイプを作りながら、残りのクラス用のデータセットを構築するのが適切です。
本番環境で変化すること#
デプロイされたモデルは、データセットに含まれていなかった条件に直面します。新しいカメラ、季節、製品、制服などです。再学習しなければ精度は低下しますが、本番環境で得られたデータを使って定期的に再学習すれば、精度を回復できます。
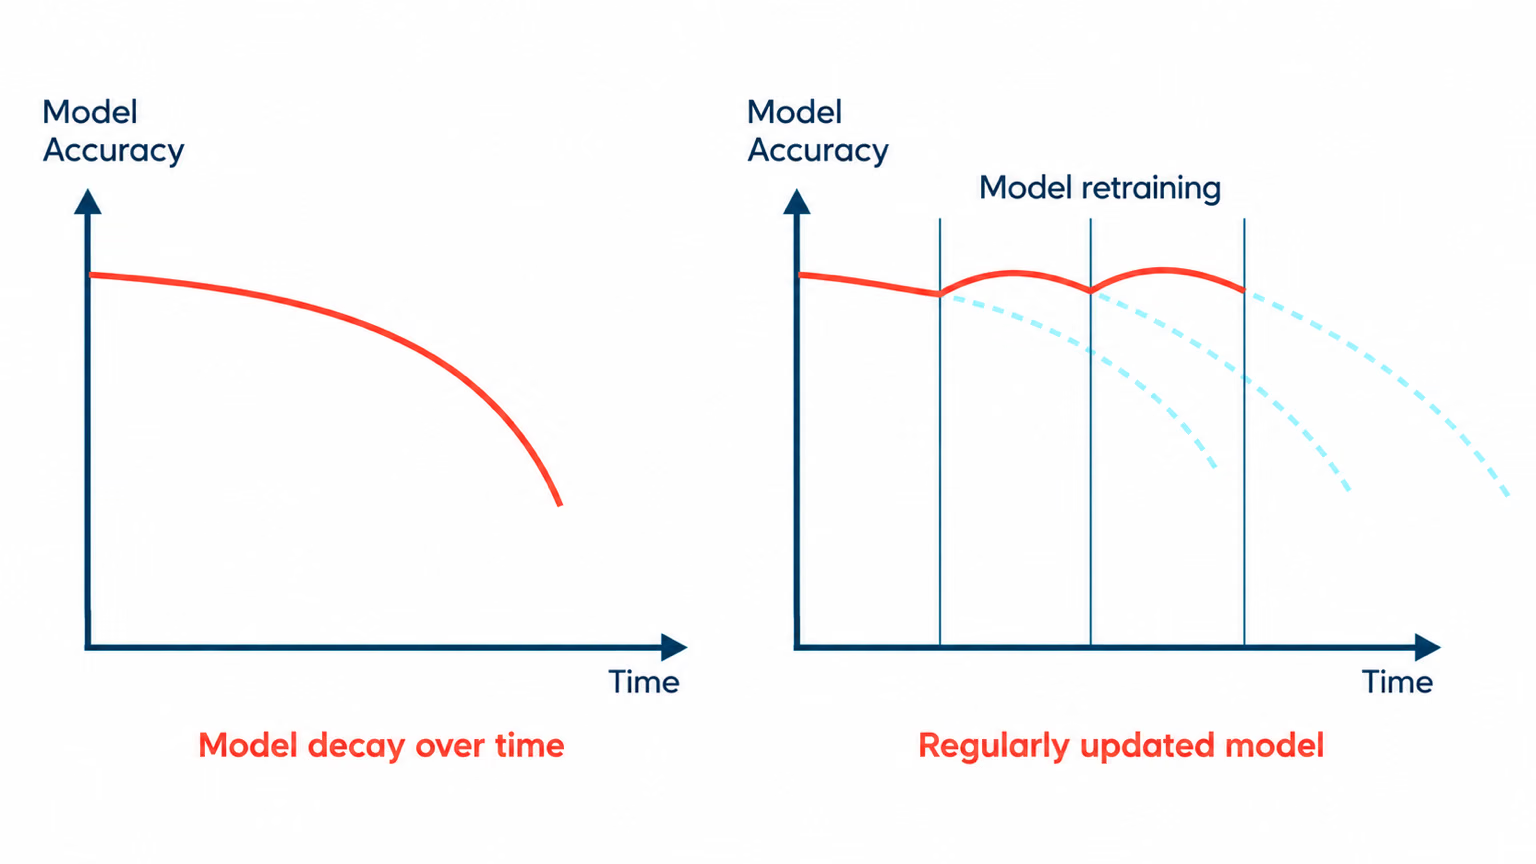
このコースの各レッスンは、このサイクルに役立ちます。仕様で失敗の定義を明確にし、カバレッジ監査で確認すべき箇所を特定します。ラベルリンターとガイドラインで新しいデータを活用できるようにし、適切なデータ分割と指標で再学習後のモデルが本当に改善したかを判断します。初日から実践できる習慣は2つあります。信頼度の低いものも含め、入力と予測のサンプルを記録すること。そして、すべてのモデルを同じ画像で比較できるよう、固定テストセットを維持することです。可観測性とドリフトでは、データドリフトの監視について詳しく説明しています。
次に進むには#
| コース | 受講するタイミング |
|---|---|
| 高性能YOLOデータセットの構築 | 対象クラスが事前学習済みモデルに含まれていない場合、またはシーンがCOCOと異なる場合 |
| 初めてのYOLOモデルをトレーニングする | ラベル付きデータセットがあり、ファインチューニングしたい場合 |
| 本番環境でのUltralytics YOLO | モデルがあり、エクスポート、トラッキング、監視が必要な場合 |
| Ultralytics Platformで構築する | データ、ラベリング、トレーニング、デプロイを1か所で行いたい場合 |
ブラウザーで完結するワークフローを希望しますか。Ultralytics Platformでは、ローカルにインストールせずに、アップロード、アノテーション、トレーニング、デプロイという同じサイクルを実行できます。
解答を表示
from pathlib import Path

from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# 1. Which classes in your output line does the pretrained model already know?
spec_classes = {"person", "forklift"}
known = set(model.names.values())
print(f"pretrained: {sorted(spec_classes & known)}  needs your own data: {sorted(spec_classes - known)}")

# 2. What does it find on your images?
sources = [
    "https://ultralytics.com/images/bus.jpg",  # replace with your own images
    "https://ultralytics.com/images/zidane.jpg",
]
for source, result in zip(sources, model.predict(sources, conf=0.25, save=True, verbose=False)):
    names = [result.names[int(c)] for c in result.boxes.cls]
    print(f"{Path(source).name}: {len(names)} detections -> {sorted(set(names))}")
pretrained: ['person'] needs your own data: ['forklift']
bus.jpg: 5 detections -> ['bus', 'person']
zidane.jpg: 3 detections -> ['person', 'tie']フォークリフトの仕様の場合:personは対応していますが、forkliftは対応していません。次のステップ:今すぐ事前学習済みモデルで人物を対象にゾーンルールのプロトタイプを作成し、倉庫のカメラ映像からフォークリフトのデータを収集してラベル付けするために、高性能YOLOデータセットの構築を始めます。