하나의 파이프라인에서 작업 결합하기
탐지 후 분류 캐스케이드를 구성하고, 모든 프레임에서 분류하는 대신 추적된 객체를 각각 한 번씩 분류하며, 포즈 키포인트를 사람별 시계열 데이터로 변환합니다.
탐지를 넘어 가장 유용한 시스템은 대개 하나가 아닌 두 개의 모델로 구성됩니다. 탐지기는 작업자를 모두 찾아내고 분류기는 각 헬멧이 올바른 종류인지 판단합니다. 포즈 모델은 관절을 찾고 추적기는 이를 반복 횟수 계산에 사용할 수 있는 타임라인으로 변환합니다. 코드는 짧습니다. 이러한 시스템은 두 번째 단계의 데이터셋이 첫 번째 단계의 크롭과 일치하지 않거나, 모든 프레임의 모든 객체에서 비용이 누적될 때 문제가 생깁니다. 단순하게 실행하면 초당 30프레임 스트림에서 사람 10명을 대상으로 초당 300회의 분류가 발생합니다.
실습형
대부분의 제품에 적용되는 두 가지 패턴#
두 패턴 모두 동일한 프레임과 동일한 Ultralytics API에서 시작하며, 두 번째 단계에서 처리하는 입력이 다릅니다. 객체 추적의 추적기 선택, 조정, 스트림 처리는 ByteTrack, BoT-SORT, TrackTrack으로 객체 추적하기에서 다룹니다. 여기서는 작업을 연결하는 데 중점을 둡니다.
탐지한 뒤 크롭 분류하기#
from ultralytics import YOLO

detector = YOLO("yolo26n.pt")
classifier = YOLO("yolo26n-cls.pt")  # swap in your own fine-tuned classifier

result = detector("https://ultralytics.com/images/bus.jpg", conf=0.5)[0]
crops, labels = [], []
for box in result.boxes:
    x1, y1, x2, y2 = box.xyxy[0].int().tolist()
    crops.append(result.orig_img[y1:y2, x1:x2])  # BGR numpy crop, same as the detector saw
    labels.append(result.names[int(box.cls)])

for label, crop_result in zip(labels, classifier(crops, verbose=False)):  # one batched call for all crops
    probs = crop_result.probs
    print(f"{label:6s} -> {crop_result.names[probs.top1]} ({float(probs.top1conf):.2f})")
bus -> bullet_train (0.31)
person -> sweatshirt (0.24)
person -> abaya (0.50)
person -> loudspeaker (0.49)
person -> frilled_lizard (0.24)처리 흐름은 올바르게 구성되어 있습니다. 크롭은 전체 해상도에서 orig_img으로 추출되며 탐지기 자체의 픽셀 좌표를 사용하고, 분류기는 모든 크롭을 한 번의 배치 호출로 처리합니다. 레이블은 의도적으로 의미 없는 값으로 설정했습니다.
ImageNet 분류기는 일부가 잘린 거리의 인물을 대상으로 학습된 적이 없으므로 추측합니다. 확신도가 0.50을 넘는 경우가 없다는 점에 유의하세요. 깨끗한 제품 사진으로 학습한 분류기에 흐릿한 탐지기 크롭을 입력해도 같은 문제가 발생합니다.
자체 크롭으로 두 번째 단계의 데이터셋 구축하기#
데이터를 일치시키는 신뢰할 수 있는 방법은 탐지기가 직접 데이터를 생성하게 하는 것입니다:
save_crop=True으로 대표적인 영상에 탐지기를 실행하세요. 예를 들어yolo predict model=best.pt source=footage/ save_crop=True을 사용합니다. 크롭은runs/detect/predict/crops/<class>/에 저장됩니다.- 각 클래스의 크롭을 세부 클래스 폴더(
helmet_ok/,helmet_missing/)로 분류하세요. 이는 이전 강의에서 다룬 분류 데이터셋 구조와 동일합니다. - 해당 폴더의 이미지로 분류기를 학습하고 다른 날짜나 카메라에서 얻은 크롭으로 검증하세요.
탐지기가 크롭을 생성했기 때문에 실제 환경에서 분류기가 보게 될 프레이밍, 블러, 가림 현상이 그대로 포함됩니다. 이러한 크롭으로 파인튜닝하는 것은 일반적인 전이 학습입니다.
추적 ID마다 한 번씩 분류하기#
헬멧은 프레임이 바뀌어도 변하지 않으므로 모든 프레임의 모든 박스를 분류하는 것은 불필요한 작업입니다. 탐지 결과를 추적하고 새 추적 ID마다 한 번씩 분류하세요:
from ultralytics import YOLO

detector = YOLO("yolo26n.pt")
classifier = YOLO("yolo26n-cls.pt")  # swap in your own fine-tuned classifier
source = "https://github.com/ultralytics/assets/releases/download/v0.0.0/decelera_portrait_min.mov"

labels = {}  # track id -> (label, confidence), filled once per person
frames = boxes_seen = 0
for result in detector.track(source, classes=[0], stream=True, persist=True, verbose=False):  # people only
    frames += 1
    if result.boxes.id is None:
        continue
    for track_id, (x1, y1, x2, y2) in zip(result.boxes.id.int().tolist(), result.boxes.xyxy.int().tolist()):
        boxes_seen += 1
        if track_id not in labels:  # first sighting: classify once, then reuse
            probs = classifier(result.orig_img[y1:y2, x1:x2], verbose=False)[0].probs
            labels[track_id] = (classifier.names[probs.top1], round(float(probs.top1conf), 2))

print(f"{frames} frames, {boxes_seen} person boxes, {len(labels)} classifier calls")
print(labels)
11 frames, 33 person boxes, 3 classifier calls
{1: ('basketball', 0.51), 2: ('maillot_(tights)', 0.14), 3: ('bulletproof_vest', 0.23)}11프레임 클립에서 분류기 호출을 33회에서 3회로 줄였습니다. 긴 스트림에서는 사람이 화면에 남아 있는 프레임이 늘어날수록 절감 효과가 커집니다. 레이블은 여전히 ImageNet 예측값입니다. 파인튜닝한 분류기로 교체하면 사람별 결과를 얻을 수 있습니다.
객체가 보이는 동안 속성이 바뀔 수 없다면 트랙당 한 번 분류합니다(헬멧 종류, 차량 제조사, 제품 SKU). 속성이 바뀔 수 있다면 N 프레임마다 다시 분류합니다(문 열림, 손 들기). 처음 감지될 때 작고 흐릿한 경우가 많다면 트랙의 박스가 가장 큰 프레임에서 분류합니다.
포즈와 추적 결합하기#
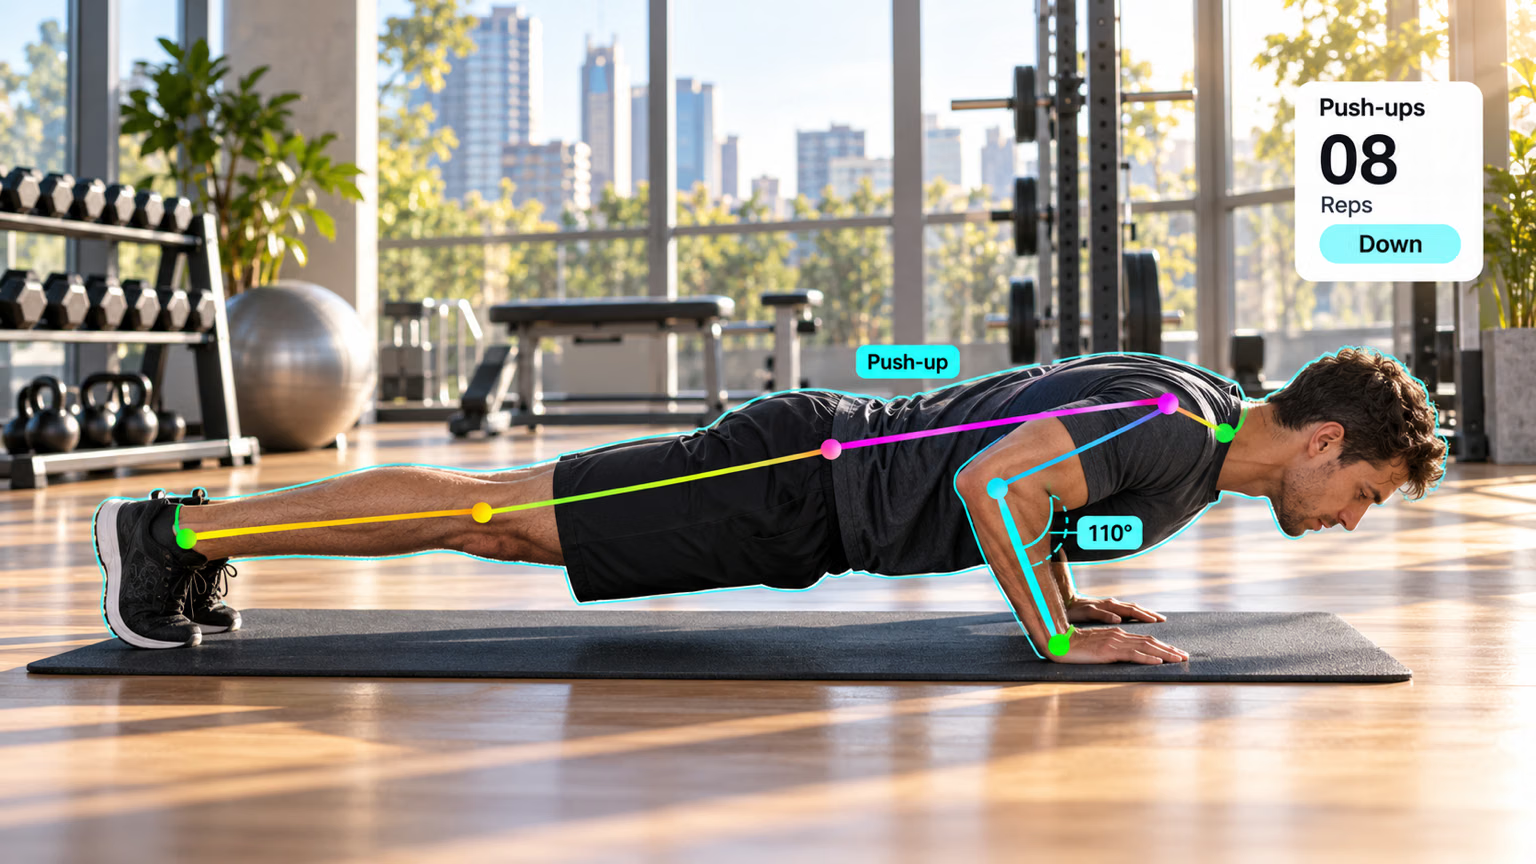
추적 모드는 사람마다 고유한 result.boxes.id을 유지하므로 키포인트가 시계열 데이터가 됩니다. 이 스크립트는 동일한 짧은 비디오에서 각 사람의 왼쪽 무릎 각도를 기록합니다:
from collections import defaultdict

import numpy as np

from ultralytics import YOLO

def angle(a, b, c):
    """Angle at b, in degrees, formed by points a-b-c."""
    ba, bc = a - b, c - b
    return np.degrees(np.arccos(np.dot(ba, bc) / (np.linalg.norm(ba) * np.linalg.norm(bc))))

model = YOLO("yolo26n-pose.pt")
source = "https://github.com/ultralytics/assets/releases/download/v0.0.0/decelera_portrait_min.mov"
HIP, KNEE, ANKLE = 11, 13, 15  # left leg, COCO keypoint order
knee_angles = defaultdict(list)  # track id -> knee angle per frame

for result in model.track(source, stream=True, persist=True, verbose=False):
    if result.boxes.id is None:  # no confirmed tracks in this frame
        continue
    kpts = result.keypoints.cpu().numpy()
    for track_id, xy, conf in zip(result.boxes.id.int().tolist(), kpts.xy, kpts.conf):
        if conf[[HIP, KNEE, ANKLE]].min() > 0.5:  # skip occluded legs
            knee_angles[track_id].append(angle(xy[HIP], xy[KNEE], xy[ANKLE]))

for track_id, angles in sorted(knee_angles.items()):
    print(f"id {track_id}: {len(angles)} frames, left knee {min(angles):.0f}-{max(angles):.0f} deg")
id 1: 11 frames, left knee 170-176 deg
id 2: 11 frames, left knee 96-118 deg
id 3: 11 frames, left knee 177-180 degID 2의 굽힌 무릎은 클립에 나온 앉아 있는 사람과 일치합니다. 나머지 두 사람은 다리를 곧게 펴고 약 180°로 서 있습니다. 여기서 반복 횟수 카운터는 각 ID의 시계열에서 임계값을 넘는 횟수를 셉니다. 즉, 한 각도 아래로 내려갔다가 다른 각도 위로 올라오는 것을 계산하며, 이것이 운동 모니터링 솔루션에 구현된 기능입니다.
연결 파이프라인의 비용 산정#
| 비용 요인 | 탐지 후 분류 | 포즈와 추적 결합하기 |
|---|---|---|
| 비례하는 항목 | 프레임당 객체 수 | 프레임 수 |
| 주요 조정 수단 | 배치를 잘라내고, track ID별로 한 번만 분류한 뒤 캐시합니다 | 움직임이 느리면 imgsz 또는 vid_stride을 낮춥니다 |
| 실패 원인 | 분류기가 학습 데이터와 다른 크롭을 입력받습니다 | ID 전환으로 한 사람의 기록이 둘로 나뉩니다 |
증상: 세트 중간에 반복 횟수 카운터가 초기화되거나, 한 사람이 두 개의 ID로 나타납니다. 원인: 추적기가 사람을 놓친 후(가림, 빠른 회전 등) 새 ID를 할당했습니다. 해결 방법: 프로덕션 과정에 설명된 대로 추적기를 조정하고, ID별 로직이 짧은 공백을 허용하도록 합니다. 캐시된 분류기 레이블은 새 ID에 대해 다시 계산됩니다.
정답 보기
검출기 호출에 save_crop=True을 추가합니다:
result = detector("https://ultralytics.com/images/bus.jpg", conf=0.5, save_crop=True)[0]크롭은 runs/detect/predict*/crops/person/ 및 crops/bus/ 아래에 나타납니다(예측을 실행할 때마다 실행 폴더 이름이 증가합니다). track별 캐싱을 적용하면 11프레임 클립에서 사람 바운딩 박스 33개에 대해 분류기 호출이 3회 발생하여 30회 절약됩니다.
무릎 각도 수를 구하려면 pose_track.py의 마지막 루프를 바꿉니다:
for track_id, angles in sorted(knee_angles.items()):
    bent = sum(a < 120 for a in angles)
    print(f"id {track_id}: {len(angles)} frames, {bent} with knee below 120 deg")
id 1: 11 frames, 0 with knee below 120 deg
id 2: 11 frames, 11 with knee below 120 deg
id 3: 11 frames, 0 with knee below 120 deg앉아 있는 사람인 ID 2는 11개 프레임 모두에서 120° 미만이며, ID 1과 3은 한 번도 그렇지 않습니다.