시맨틱 세그멘테이션: 모든 픽셀에 레이블 지정
yolo26n-sem.pt로 픽셀별 클래스 맵을 예측하고, 이를 커버리지 수치로 변환하고, PNG 클래스 맵 데이터셋을 구축한 다음, 픽셀 정확도에 현혹되지 않고 mIoU를 확인합니다.
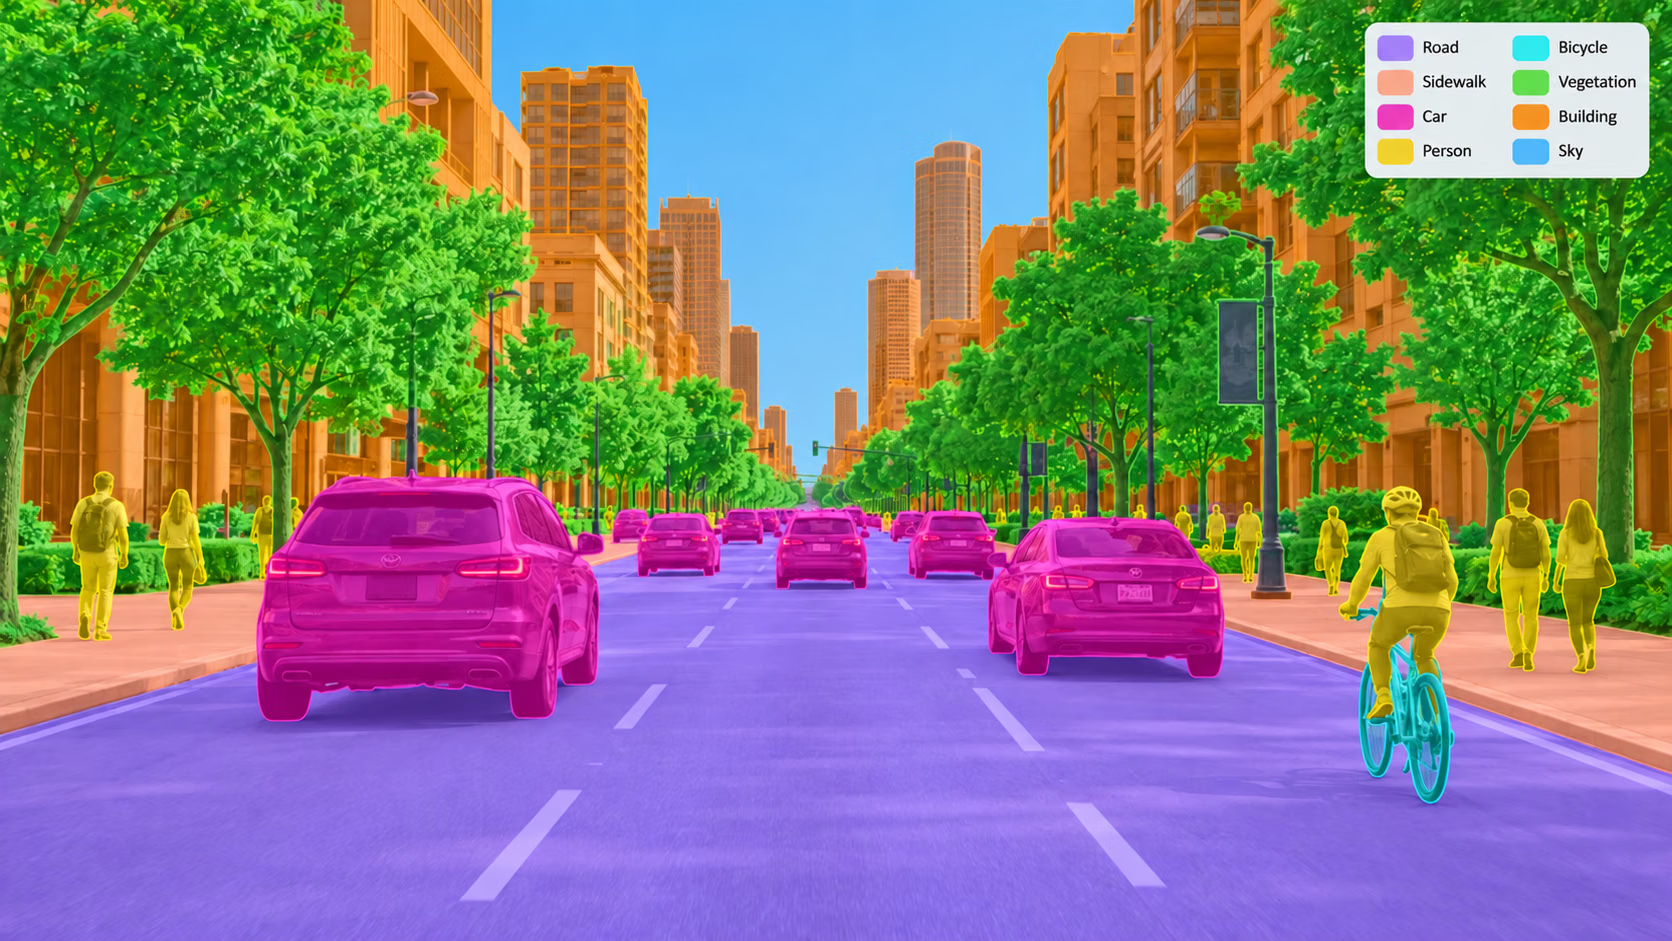
계산할 객체가 없는 질문도 있습니다. 인도가 얼마나 막혀 있는지, 밭에 잡초가 얼마나 많은지, 주행 가능한 도로가 어디에서 끝나는지 같은 질문입니다. 시맨틱 세그멘테이션은 픽셀마다 하나의 클래스 ID를 지정해 이러한 질문에 답합니다. 하지만 대표 지표는 잘못 해석하기 쉽습니다. 이 강의에서 학습하는 모델은 사람을 단 한 명도 찾지 못하면서 픽셀 정확도 91%를 기록합니다.
실습형
인스턴스 세그멘테이션인가요, 시맨틱 세그멘테이션인가요?#
인스턴스 세그멘테이션 (segment) | 시맨틱 세그멘테이션 (semantic) | |
|---|---|---|
| 출력 | 객체마다 마스크 하나와 박스 하나 | 픽셀마다 클래스 ID 하나 |
| 객체 수를 계산합니다 | 예 | 아니요 — 서로 닿은 자동차 두 대도 하나의 "자동차" 영역입니다 |
| 도로, 하늘, 잔디와 같은 "stuff"를 처리합니다 | 잘 처리하지 못합니다 — 자연스러운 인스턴스 구분이 없습니다 | 예 |
| 레이블 형식 | 다각형 | PNG 클래스 맵 또는 다각형 |
| 게이팅 지표 | 마스크 mAP50-95 | mIoU |
| 사전 학습 가중치 | yolo26n-seg.pt (COCO, 80개 클래스) | yolo26n-sem.pt (Cityscapes, 19개 클래스) |
후속 작업에서 "몇 개인가"를 묻는다면 인스턴스 분할을 사용하세요. "얼마나 많은가" 또는 "어디에 있는가"를 묻는다면 시맨틱 분할이 레이블 지정과 결과 해석이 더 간단합니다. 시맨틱 분할 작업 페이지에서 모델 표를 확인하세요.
클래스 맵 예측#
result.semantic_mask.data은 원본 이미지 크기의 H × W 텐서입니다. 각 값은 클래스 ID이며 255는 무시를 의미합니다. result.summary()은 이를 클래스별 픽셀 비율로 변환합니다:
from ultralytics import YOLO

model = YOLO("yolo26n-sem.pt")  # Cityscapes, 19 classes
result = model("https://ultralytics.com/images/bus.jpg")[0]

class_map = result.semantic_mask.data  # H x W tensor of class ids, 255 = ignore
print("class map:", tuple(class_map.shape), class_map.dtype)
for row in result.summary():
    if row["pixel_ratio"] >= 0.02:
        print(f"{row['name']:12s} {row['pixel_ratio']:.1%}")
class map: (1080, 810) torch.uint8
road 27.5%
sidewalk 2.0%
building 19.3%
vegetation 4.5%
person 14.6%
train 30.9%마지막 행을 확인하세요. Cityscapes에는 bus 클래스가 있지만, 모델은 버스를 train이라고 분류합니다. 이 모델은 주로 독일 도로를 촬영한 차량 탑재 영상으로 학습했으며, 인도에서 가까운 거리로 촬영한 버스는 학습 데이터 분포와 다릅니다. 시맨틱 모델은 검출기보다 학습 데이터의 촬영 시점과 클래스 정의, 즉 데이터셋 편향을 더 엄격하게 따릅니다. 따라서 클래스 맵을 신뢰하기 전에 자체 카메라 데이터로 파인튜닝하세요.
클래스 맵으로 질문에 답하기#
간단한 텐서 비교만으로 클래스 맵을 제품에 활용할 수 있는 수치로 바꿀 수 있습니다. 다음은 "보행자가 들어서게 될 영역 중 도로 또는 인도가 차지하는 비율과 사람이 차지하는 비율은 얼마인가요?"라는 질문의 예입니다.
from ultralytics import YOLO

result = YOLO("yolo26n-sem.pt")("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
class_map = result.semantic_mask.data  # H x W class ids at the original size, 255 = ignore
ids = {name: i for i, name in result.names.items()}

h = class_map.shape[0]
lower = class_map[h // 2 :]  # the half of the frame a pedestrian would walk into
walkable = (lower == ids["road"]) | (lower == ids["sidewalk"])
people = lower == ids["person"]
print(f"lower half: {walkable.float().mean():.0%} road or sidewalk, {people.float().mean():.0%} person")
result.save("semantic_overlay.jpg")  # colored class map over the photo, for a visual check
lower half: 59% road or sidewalk, 23% person이 수치를 신뢰할 수 있도록 하는 세 가지 습관:
result.names에서 이름으로 ID를 조회하고, 숫자를 하드코딩하지 마세요. 자체 클래스 데이터로 학습한 모델에서는 클래스 번호가 달라집니다.- 중요한 영역으로 범위를 제한하세요. 전체 프레임 비율에는 하늘과 건물이 포함되므로, 먼저 클래스 맵을 슬라이스하거나 영역 마스크를 곱하세요.
- 오버레이를 확인하세요.
semantic_overlay.jpg을 보면 수치에 포함된 "도로"가 실제 도로인지 한눈에 알 수 있습니다.
데이터셋 형식#
시맨틱 데이터셋은 각 이미지와 픽셀 값이 클래스 ID인 단일 채널 마스크 이미지를 쌍으로 구성합니다. 시맨틱 데이터셋 가이드가 기준 문서이며, 파일별 구조는 images/을 그대로 따릅니다:
cityscapes8/
├── images/
│   ├── train/aachen_000000_000019.png
│   └── val/aachen_000004_000019.png
└── masks/
    ├── train/aachen_000000_000019.png
    └── val/aachen_000004_000019.png
YAML에는 masks_dir이 추가되며, 마스크에 저장된 ID가 학습 ID와 다른 경우에는 label_mapping 블록도 추가됩니다:
path: cityscapes8
train: images/train
val: images/val
masks_dir: masks # semantic mask directory

names:
  0: road
  1: sidewalk
  # ... 19 classes in total

label_mapping: # raw mask value -> training id
  0: ignore_label
  7: 0 # road
  8: 1 # sidewalk
  # ...
Cityscapes 마스크에는 -1부터 33까지의 원시 레이블 ID가 저장됩니다. 매핑을 통해 그중 19개를 유지하고 나머지는 ignore_label으로 보내며, 이 값은 255로 저장됩니다. 255로 설정된 픽셀은 손실과 지표 계산에서 모두 제외됩니다. 어노테이터가 판단할 수 없었던 영역에도 같은 값을 사용하세요.
다각형 레이블은 있지만 masks_dir이 없는 경우, 로더가 다각형을 래스터화하고 레이블이 지정되지 않은 픽셀에 background 클래스를 추가합니다.
손실 압축은 주변 픽셀 값을 섞어 클래스 7과 클래스 8 사이의 경계를 7, 8, 그리고 존재하지 않는 ID가 섞인 번짐으로 만듭니다. 모든 마스크는 PNG 또는 TIFF로 저장하세요.
학습 및 mIoU 확인#
Cityscapes8에는 도심 장면 이미지 8장이 있으며, 학습용 4장과 검증용 4장으로 나뉩니다. CPU에서 스모크 테스트를 수행하기에 충분합니다:
from ultralytics import YOLO

model = YOLO("yolo26n-sem.pt")
model.train(data="cityscapes8.yaml", epochs=1, imgsz=320, device="cpu")
metrics = model.val()
print(f"mIoU: {metrics.miou:.3f}  pixel accuracy: {metrics.pixel_accuracy:.3f}")
Class Images Pixels mIoU PixAcc
all 4 192315 0.415 0.906
road 4 78529 0.974 0.996
vegetation 4 37602 0.844 0.936
person 3 722 0 0
rider 1 21 0 0
mIoU: 0.415 pixel accuracy: 0.906(클래스별 행은 일부 생략했습니다.) 픽셀 정확도는 91%라고 나타내지만, mIoU는 42%이고, 클래스별 행을 보면 모델이 사람을 단 한 명도 찾지 못했습니다. 세 가지 결과는 모두 사실입니다. 픽셀 대부분을 도로, 건물, 식생이 차지합니다. 도로만 해도 192,315픽셀 중 78,529픽셀입니다. 따라서 이러한 클래스는 잘 칠하지만 작은 클래스는 모두 놓치는 모델도 높은 픽셀 정확도를 얻을 수 있습니다. mIoU는 클래스별 IoU를 동일한 가중치로 평균하므로, 놓친 클래스마다 점수가 낮아집니다.

mIoU 및 제품이 실제로 사용하는 클래스의 IoU를 기준으로 판단하세요. 사람 IoU가 0인 보행자 안전 기능은 픽셀 정확도가 어떻든 실패입니다.
정답 보기
실행 결과: mIoU 0.415, 픽셀 정확도 0.906이며, 벽, 사람, 라이더, 오토바이, 자전거의 IoU는 0입니다. 검증 이미지 4장에 픽셀이 하나도 없는 모든 클래스도 IoU가 0입니다.
픽셀 정확도는 픽셀 수를 기준으로 계산하며, Cityscapes 프레임 대부분을 도로, 건물, 식생, 하늘이 차지하므로 더 높게 나옵니다. mIoU는 각 클래스에 동일한 가중치를 부여하므로, 소규모 클래스 다섯 개를 놓치면 해당 클래스가 차지하는 픽셀이 수백 개뿐이더라도 평균이 낮아집니다. 사람을 대상으로 동작하는 제품이라면 사람 IoU만으로도 이 모델은 출시 기준을 통과하지 못합니다.