이미지 분류기 학습하기
폴더 데이터셋을 구성하고, MNIST160으로 yolo26n-cls.pt를 학습하고, 확률과 top-1 정확도를 확인한 다음, 신뢰도가 낮은 예측을 사람의 검토로 전달합니다.
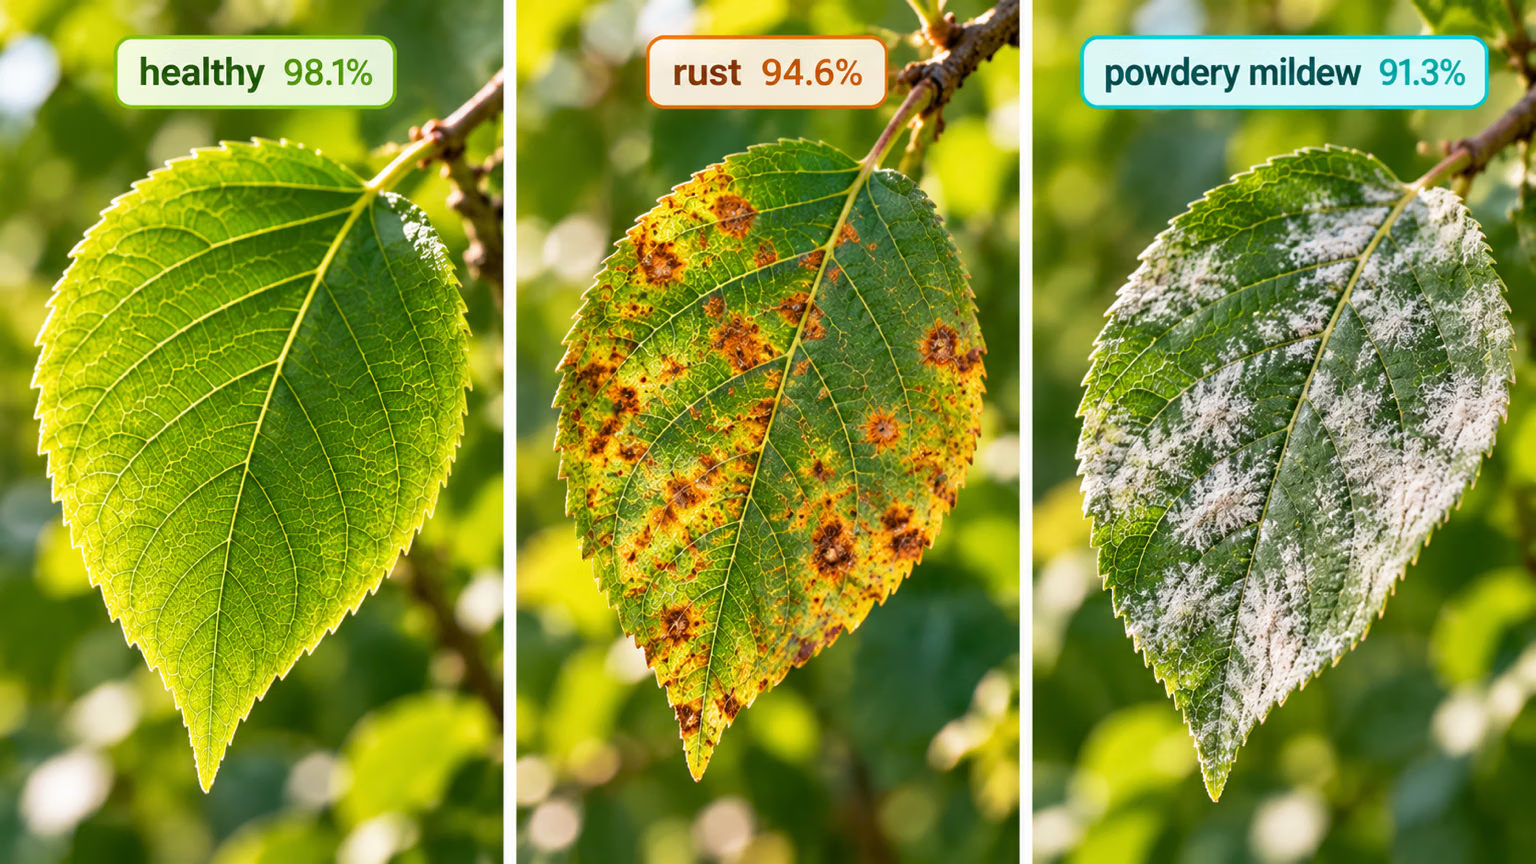
이미지 분류는 이미지마다 하나의 질문에 답합니다. 이 이미지는 무엇인가요? 폴더 이름이라는 가장 간단한 레이블을 사용하고 가장 빠르게 실행되므로, 탐지기 다음의 기본 두 번째 단계이며 프레임마다 부품 하나를 검사하는 검사 스테이션에 적합한 첫 번째 모델입니다. 데이터셋에는 YAML이 없으므로 폴더 구조가 기준이 됩니다. 분류기는 한 번도 본 적 없는 이미지에도 항상 답을 내놓습니다. 언제 결과를 신뢰하지 말아야 하는지 판단하는 것이 작업의 절반입니다.
실습형
폴더 데이터셋 구성#
분류 데이터셋은 YAML 파일이 아니라 디렉터리로 구성됩니다. data=이 루트 폴더를 가리키도록 지정하세요:
parts/
├── train/
│   ├── good/      img_0001.jpg ...
│   ├── scratch/   img_0412.jpg ...
│   └── dent/      img_0733.jpg ...
└── val/
    ├── good/
    ├── scratch/
    └── dent/
설치된 소스 코드와 분류 데이터셋 가이드를 바탕으로 데이터 로더의 동작을 설명하면 다음과 같습니다:
| 상황 | 동작 |
|---|---|
| 클래스 인덱스 | train/ 아래의 폴더 이름을 알파벳순으로 정렬 → dent=0, good=1, scratch=2 |
| 검증 폴더 | val/, 이어서 validation/, 그다음 valid/를 사용합니다. 경고를 표시한 뒤 test/으로 대체합니다. |
train/ 폴더 없이 클래스 폴더만 있는 경우 | 자동으로 train/과 val/에 80/20으로 분할합니다. |
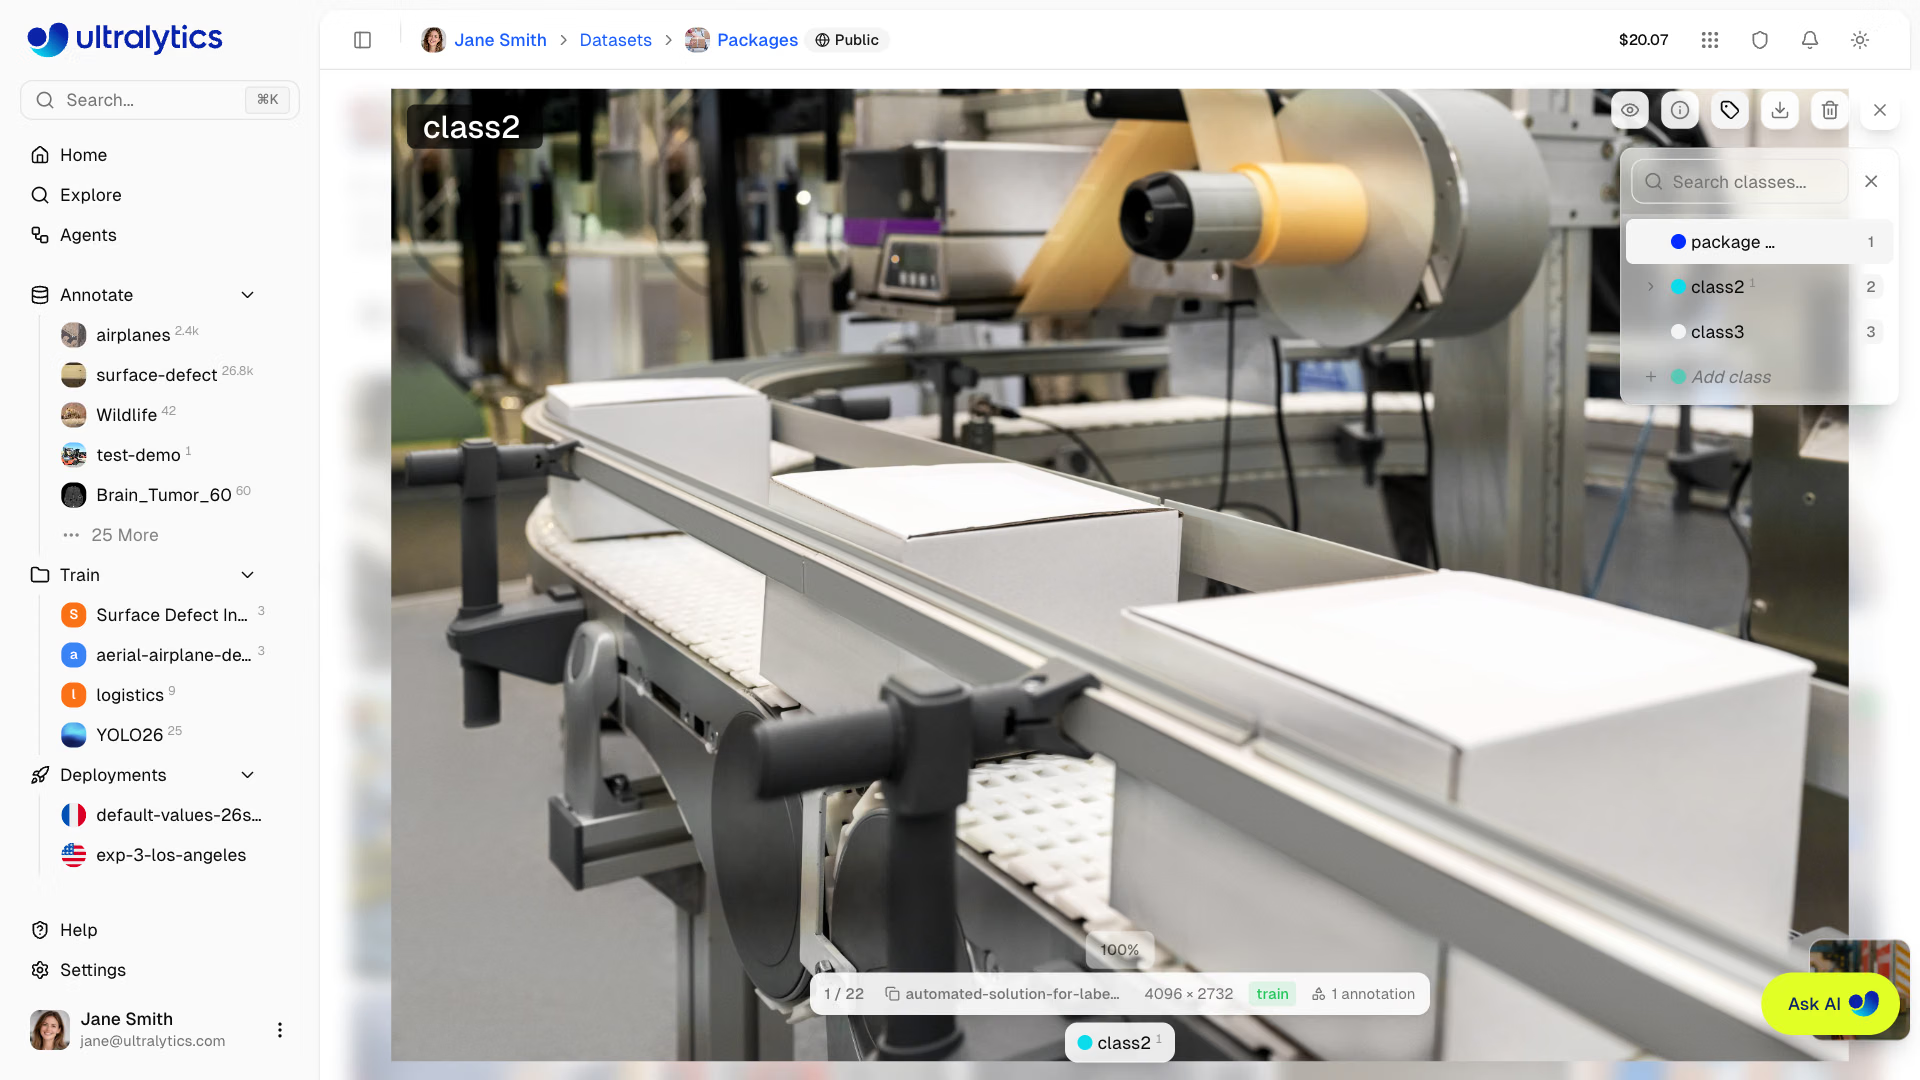
Ultralytics Platform에서 분류 데이터셋은 도형 대신 이미지마다 이미지 수준 레이블 하나를 포함합니다:
증상: 클래스를 추가한 후 기존 통합에서 good 부분을 dent로 보고합니다. 원인: bent라는 폴더를 추가하면 해당 폴더가 정렬 순서상 맨 앞에 와서 이후 모든 인덱스가 밀립니다. 해결 방법: 항상 model.names(또는 result.names)를 사용해 인덱스를 이름에 매핑하고, 인덱스를 하드코딩하지 마세요.
MNIST160으로 학습하기#
MNIST160은 손으로 쓴 숫자 이미지 160개로 구성되며, train/에 80개, test/에 80개가 있고, 각 세트는 숫자별 폴더 10개로 나뉩니다. CPU 스모크 테스트에 적합한 크기입니다. val/ 폴더는 없으므로 데이터 로더가 경고를 표시하고 test/로 대체하는지 확인하세요:
from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")
model.train(data="mnist160", epochs=1, imgsz=64, device="cpu")
metrics = model.val()
print(f"top-1: {metrics.top1:.3f}  top-5: {metrics.top5:.3f}")
WARNING ⚠️ Dataset 'split=val' not found, using 'split=test' instead.
val: .../datasets/mnist160/test... found 80 images in 10 classes ✅
all 0.162 0.463
top-1: 0.162 top-5: 0.463에포크 한 번으로는 새 10개 클래스 헤드의 성능이 거의 개선되지 않습니다. 저희 실행에서는 노트북 CPU에서 약 10초 만에 epochs=10의 top-1이 0.55, top-5가 0.95에 도달했습니다. 학습 루프는 작동하지만, 더 긴 학습 일정이 필요합니다. 사전 학습된 크기는 분류 작업 가이드에 나와 있습니다.
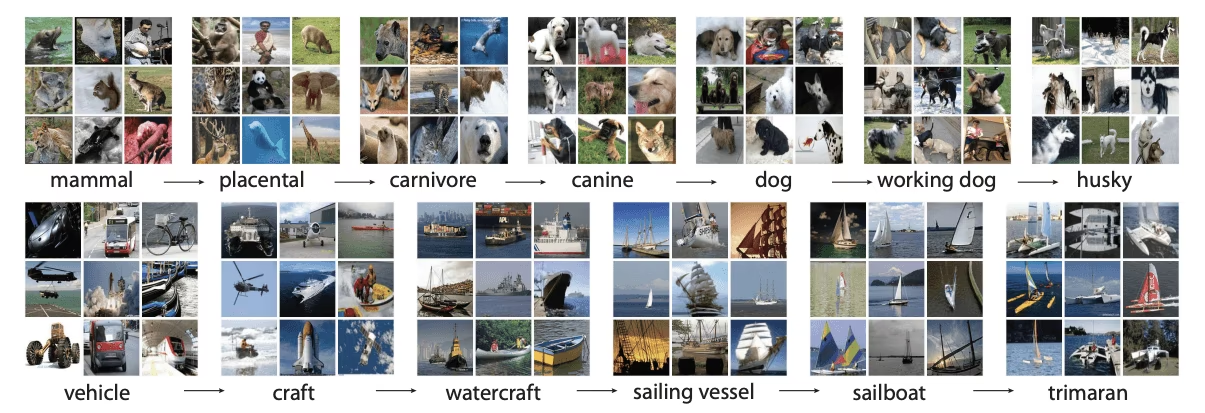
Top-1은 가장 높은 확률을 가진 클래스가 정답인 이미지의 비율입니다. Top-5는 정답 클래스가 확률 상위 5개 안에 있으면 정답으로 계산합니다. 클래스가 대략적인 범주부터 세밀한 범주까지 구성된 1,000개 클래스 ImageNet에서는 top-5가 유용한 지표입니다. 클래스가 5개 이하라면 항상 1.0이고, 10개인 경우에도 관대한 지표입니다. top-1 정확도와 클래스별 혼동 행렬을 기준으로 판단하세요.
코드에서 확률 읽기#
from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")  # ImageNet, 1,000 classes
result = model("https://ultralytics.com/images/bus.jpg")[0]

probs = result.probs
print(f"top-1: {result.names[probs.top1]} ({float(probs.top1conf):.2f})")
for i, conf in zip(probs.top5, probs.top5conf.tolist()):
    print(f"  {result.names[i]:20s} {conf:.3f}")
top-1: minibus (0.52)
minibus 0.516
police_van 0.369
trolleybus 0.096
minivan 0.006
ambulance 0.003probs.top1은 인덱스이고, probs.top5은 인덱스 목록이며, probs.data는 전체 확률 벡터입니다. top-1 신뢰도를 확인해 보세요. 0.52는 minibus과 police_van 중 하나를 고르는 동전 던지기보다 조금 나은 수준입니다. 바로 이 값을 기준으로 처리 대상을 결정합니다.
확신할 수 없는 예측을 담당자에게 전달하기#
실제 환경의 분류기는 모든 이미지에서 항상 정답을 맞힐 필요가 없습니다. 스스로 판단하기로 한 이미지에서 정답을 맞히면 됩니다. 이 스크립트는 10에포크 모델을 학습한 다음, 신뢰도 임계값에 따라 보류된 숫자 이미지 80개를 어떻게 처리할지 측정합니다:
from pathlib import Path

from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")
model.train(data="mnist160", epochs=10, imgsz=64, device="cpu", plots=False)  # model now holds best.pt
print(model.names)  # folder names, sorted, became class indices

test = Path(model.trainer.data["test"])  # mnist160/test, the split the loader validated on
images = sorted(test.rglob("*.png"))
results = model(images, imgsz=64, verbose=False)
truth = [p.parent.name for p in images]

for threshold in (0.0, 0.3, 0.6):
    kept = [(r, t) for r, t in zip(results, truth) if r.probs.top1conf >= threshold]
    correct = sum(r.names[r.probs.top1] == t for r, t in kept)
    print(f"threshold {threshold:.1f}: auto-accept {len(kept):2d}/{len(images)}, accuracy on accepted {correct / max(len(kept), 1):.0%}")
{0: '0', 1: '1', 2: '2', 3: '3', 4: '4', 5: '5', 6: '6', 7: '7', 8: '8', 9: '9'}
threshold 0.0: auto-accept 80/80, accuracy on accepted 55%
threshold 0.3: auto-accept 41/80, accuracy on accepted 68%
threshold 0.6: auto-accept 10/80, accuracy on accepted 80%각 행은 정확도와 검토 작업량 사이의 절충을 나타냅니다. 임계값을 높이면 승인된 예측의 정확도가 높아지고 더 많은 이미지가 담당자에게 전달됩니다. 0.6에서 이 모델은 숫자 이미지 80개 중 10개만 단독으로 판단합니다. 아직 자동화에 사용할 수 없으며, 해결책은 더 영리한 임계값이 아니라 더 많은 학습입니다. 학습을 진행할 때마다 동일한 표를 다시 작성하세요. 이 표를 통해 달성할 정확도와 임계값별 검토 작업량을 모두 정확히 알 수 있습니다.
보류 데이터에서 측정했을 때 승인된 이미지의 정확도가 요구 사항을 충족하는 가장 낮은 임계값을 선택합니다. 그런 다음 생성되는 검토량을 팀이 감당할 수 있는지 확인하고, 그렇지 않으면 모델을 개선합니다.
주의할 점#
증상: 비어 있는 스테이션, 잘못된 부품 또는 렌즈를 가린 손에 확신도 높은 클래스 레이블이 지정됩니다. 원인: softmax 확률의 합은 항상 1이므로 분류기는 항상 클래스 중 하나를 선택합니다. 해결 방법: 해당 이미지로만 채운 other/ 폴더를 추가하고, top1conf가 낮은 예측은 검토 대상으로 전달합니다.
증상: 학습을 시작하기도 전에 사전 학습된 모델이 데이터셋에서 거의 0점에 가까운 점수를 기록합니다. 원인: yolo26n-cls.pt은 ImageNet 인덱스 1,000개를 예측하지만, 사용자의 폴더는 인덱스 0~9를 다른 의미로 재사용합니다. MNIST160에서는 0 폴더가 인덱스 0인데, 사전 학습된 헤드는 이를 tench라고 부릅니다. 이 방식으로 측정한 top-1 정확도는 0.000이었습니다. 해결 방법: 먼저 파인튜닝한 다음 검증합니다.
증상: 검증에서는 top-1 정확도가 1.0에 가깝지만, 프로덕션에서는 훨씬 낮습니다. 원인: train/과 val/에 동일 부품의 거의 중복된 사진이 있습니다. 해결 방법: 데이터셋을 올바르게 분할하기에 나온 것처럼 부품별 또는 세션별로 분할합니다.
분류기는 640이 아니라 imgsz=224 크기로 사전 학습됩니다. 큰 프레임 안의 작은 객체에는 더 큰 imgsz보다 탐지 후 분류(다음 강의)가 더 적합합니다.
정답 보기
from ultralytics import YOLO

for epochs in (1, 10):
    model = YOLO("yolo26n-cls.pt")
    model.train(data="mnist160", epochs=epochs, imgsz=64, device="cpu")
    metrics = model.val()
    print(f"{epochs:2d} epochs  top-1: {metrics.top1:.3f}  top-5: {metrics.top5:.3f}")
print(model.names)  # {0: '0', 1: '1', ..., 9: '9'}
실행 결과는 다음과 같습니다. 1에포크 → top-1 0.162, top-5 0.463, 10에포크 → top-1 0.550, top-5 0.950. 클래스가 5개라면 정답은 항상 상위 5개 안에 있으므로 top-5는 정의상 1.0이며 아무것도 알려주지 않습니다.
승인된 이미지에서 75% 정확도를 얻으려면 route.py에 따르면 임계값은 0.6입니다(승인된 10개에서 80%). 이 설정은 숫자 이미지 80개 중 70개를 검토 대상으로 보냅니다. 이것이 솔직한 답입니다. 임계값은 정확도 요구사항을 충족하지만, 모델은 아직 유용하지 않습니다. 실제 임계값을 선택하기 전에 더 오래 학습하고 표를 다시 작성하세요.