작업을 선택하고 파이프라인 계획하기
각 제품 관련 질문을 7가지 Ultralytics YOLO 작업 중 하나에 연결하고, 해당 작업의 가중치, 결과 필드, 라벨 형식, 게이팅 지표를 정한 다음, 이미지 한 장에서 모든 작업을 실행해 계획을 검증합니다.
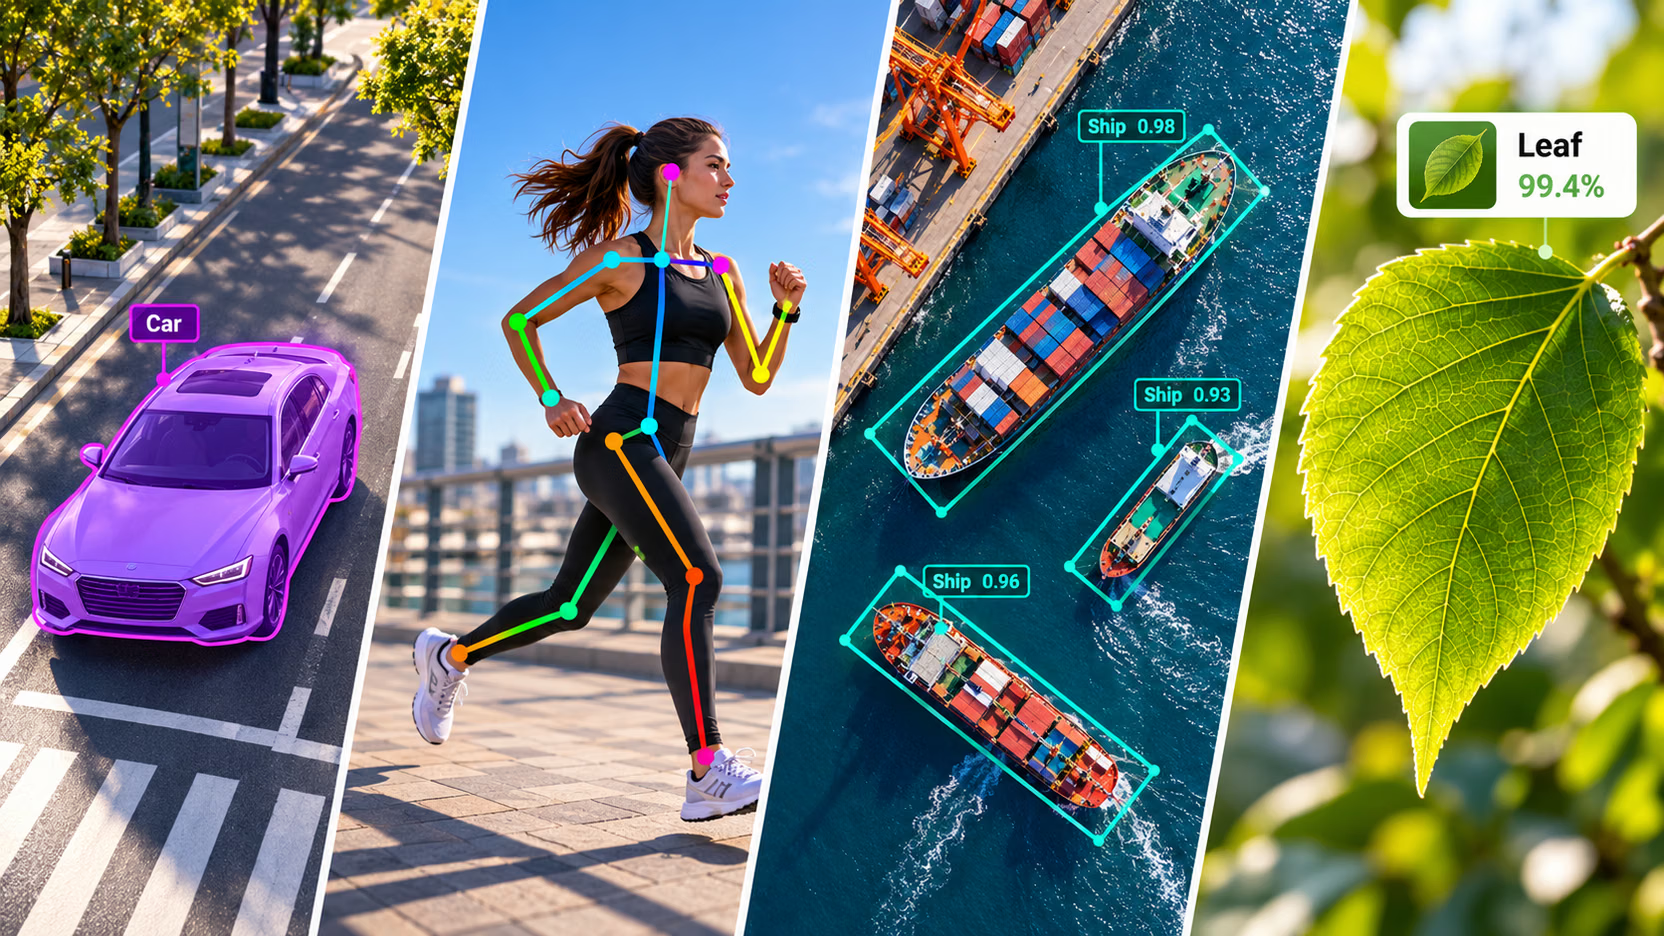
탐지 모델을 배포하고 나면 다음 요청은 대개 "박스를 더 많이"가 아닙니다. 대신 "유출 면적은 얼마나 되나요", "작업자의 등이 굽었나요", "선박은 어느 방향을 향하고 있나요", "이 부품은 불량인가요"라고 묻습니다. 이 과정에서 계속 사용하는 거리 사진을 보면 버스의 바운딩 박스는 프레임의 48%를 차지한다고 나타내지만, 실제 버스는 29%만 차지하므로 박스를 기준으로 면적을 계산하면 절반 넘게 틀립니다. 어떤 작업을 선택하느냐에 따라 라벨 형식이 결정되므로, 라벨링을 시작하기 전에 작업을 선택하는 것이 프로젝트에서 가장 비용이 적게 드는 결정입니다. 나중에 바꾸면 다시 라벨링해야 합니다.
실습형
사진 한 장, 서로 다른 답변 네 가지#

사진 한 장에 질문 하나를 던지고 — 이 프레임에서 버스가 차지하는 면적은 얼마이며, 버스는 얼마나 멀리 있나요? — 네 가지 Ultralytics YOLO 작업이 답하게 합니다.
from ultralytics import YOLO

image = "https://ultralytics.com/images/bus.jpg"
det = YOLO("yolo26n.pt")(image, verbose=False)[0]
seg = YOLO("yolo26n-seg.pt")(image, retina_masks=True, verbose=False)[0]
sem = YOLO("yolo26n-sem.pt")(image, verbose=False)[0]
depth = YOLO("yolo26n-depth.pt")(image, verbose=False)[0]
frame = det.orig_shape[0] * det.orig_shape[1]  # pixels in the photo

i = [det.names[int(c)] for c in det.boxes.cls].index("bus")
x1, y1, x2, y2 = det.boxes.xyxy[i].tolist()
print(f"detect    bus box covers   {(x2 - x1) * (y2 - y1) / frame:.1%} of the frame")

i = [seg.names[int(c)] for c in seg.boxes.cls].index("bus")
bus_mask = seg.masks.data[i].bool()  # H x W, True on bus pixels
print(f"segment   bus mask covers  {bus_mask.sum().item() / frame:.1%} of the frame")

ratios = {row["name"]: row["pixel_ratio"] for row in sem.summary()}
print(f"semantic  'train' pixels   {ratios['train']:.1%} of the frame")

meters = depth.depth.data[bus_mask].median().item()  # depth map and mask share the original size
print(f"depth     bus is about     {meters:.1f} m from the camera")
detect bus box covers 47.7% of the frame
segment bus mask covers 29.2% of the frame
semantic 'train' pixels 30.9% of the frame
depth bus is about 4.5 m from the camera각 항목을 하나씩 살펴보겠습니다.
- detect는 위치를 알려줍니다. 박스에는 버스 아래 도로와 버스 앞에 서 있는 네 사람도 포함되므로, 면적으로 계산하면 63% 더 크게 나옵니다.
- segment는 모양을 알려줍니다. 29.2%는 이미지에서 버스가 실제로 차지하는 영역이며, 면적, 커버리지 또는 중첩 규칙에 사용할 값입니다.
- semantic은 각 픽셀이 어떤 클래스에 속하는지 알려줍니다. 면적은 마스크와 비슷하지만, 모델은 버스를
train이라고 분류합니다. 학습 데이터셋(Cityscapes, 4강)의 클래스로 표면을 라벨링하며 차량을 개별적으로 구분하지는 않습니다. - depth는 거리를 알려줍니다. 버스 마스크 내부의 중앙값 깊이는 4.5 m입니다. 두 작업을 결합해야 어느 한 작업만으로는 답할 수 없는 질문에 답할 수 있습니다.
제품이 보고하는 값이 면적, 점유율 또는 중첩이라면 박스는 적절한 도구가 아닙니다. 객체에는 마스크(인스턴스 분할)를, 표면에는 클래스 맵(시맨틱 분할)을 사용하세요.
한눈에 보는 7가지 작업#
컴퓨터 비전 기초에서는 작업 간 선택 방법을 자세히 다룹니다. 선택이 분명하지 않다면 일곱 가지 비전 작업을 다시 살펴보세요. 이 내용은 과정의 나머지 부분에서 사용할 실무 요약입니다. 각 행은 설치된 ultralytics 패키지가 동일한 API로 학습, 검증, 예측 및 내보내기를 지원하는 작업입니다. 전체 참고 자료는 작업 개요를 확인하세요.
| 출력이 답해야 하는 질문 | 작업 | YOLO26 가중치 | 결과 필드 | 라벨 형식 | 게이팅 지표 |
|---|---|---|---|---|---|
| 각 객체는 어디에 있나요? | detect | yolo26n.pt | boxes | 클래스 + 박스 | 박스 mAP50-95 |
| 각 객체의 정확한 모양과 면적은 무엇인가요? | segment | yolo26n-seg.pt | masks + boxes | 클래스 + 폴리곤 | 마스크 mAP50-95 |
| 각 픽셀은 어떤 클래스에 속하나요? | semantic | yolo26n-sem.pt | semantic_mask | PNG 클래스 맵 또는 폴리곤 | mIoU |
| 관절이나 랜드마크는 어디에 있나요? | pose | yolo26n-pose.pt | keypoints + boxes | 클래스 + 박스 + 키포인트 | 포즈 mAP50-95 (OKS) |
| 각 객체는 어떤 방향으로 회전했나요? | obb | yolo26n-obb.pt | obb | 클래스 + 모서리 4개 | OBB mAP50-95 |
| 이미지 전체(또는 크롭)는 무엇인가요? | classify | yolo26n-cls.pt | probs | 클래스별 폴더 하나 | top-1 정확도 |
| 각 픽셀은 카메라에서 얼마나 떨어져 있나요? | depth | yolo26n-depth.pt | depth | 이미지별 깊이 맵(16비트 PNG 또는 NPY) | δ1 (delta1) |
첫 번째 행은 이미 배포하고 있습니다. 2~8강에서는 가운데 다섯 행을 다루고, 9~10강에서는 이를 연결해 배포합니다. 마지막 행인 단안 깊이 추정은 단일 이미지의 모든 픽셀에 대해 거리를 미터 단위로 예측합니다. 라벨은 어노테이터가 아니라 깊이 센서나 3D 렌더러에서 생성되므로 별도의 데이터셋 형식을 사용합니다. 이 과정에서는 계획, 검증 루프, 마지막 강의의 내보내기 검사 등 워크플로를 공유하는 부분에 깊이 추정을 포함합니다.
한 번에 질문 하나씩 선택하기#
질문을 순서대로 살펴보고, 처음으로 그렇다고 답하는 지점에서 멈춥니다.
이 차트는 일반적인 경우를 다룹니다. 나머지 대부분의 경우에는 다음 네 가지 기준으로 선택할 수 있습니다.
| 요청에 다음이 필요한 경우… | 선택 작업 | 이유 |
|---|---|---|
| 개수 및 면적("유출이 몇 건이고, 각각 얼마나 큰가")이 필요함 | segment | 시맨틱 세그멘테이션은 서로 맞닿은 객체를 하나의 영역으로 합칩니다. |
| 위에서 보았을 때 길고 가느다란 객체들이 나란히 빽빽하게 배치되어 있음 | obb | 축 정렬 박스가 서로 겹치고 NMS가 실제 객체를 제거합니다. 각도를 확인하지 않는 경우에도 마찬가지입니다. |
| 앞과 뒤 또는 왼쪽과 오른쪽의 구분이 필요함 | pose | OBB는 축을 제공하지만 방향을 알려주지는 않습니다. |
| 구조상 이미지마다 항목이 정확히 하나임(고정된 검사 스테이션) | classify | 라벨링 비용이 가장 적고 모델이 가장 빠릅니다. |
데이터셋을 만들 때 작업이 고정됩니다. Ultralytics Platform에서는 새 데이터셋 대화상자의 Task Type 필드에서 선택하므로, 첫 라벨을 만들기 전에 작업을 결정해야 합니다.

하나의 API, 일곱 가지 결과 필드#
모든 작업은 동일한 호출을 사용하며, 모델은 가중치 파일에서 작업을 확인합니다. 달라지는 점은 결과에서 어떤 필드가 채워져 반환되는지이며, 코드에서 읽을 필드도 바로 그 필드입니다.
from ultralytics import YOLO

WEIGHTS = ["yolo26n.pt", "yolo26n-seg.pt", "yolo26n-sem.pt", "yolo26n-pose.pt", "yolo26n-obb.pt", "yolo26n-cls.pt", "yolo26n-depth.pt"]
FIELDS = ("boxes", "masks", "semantic_mask", "keypoints", "obb", "probs", "depth")

for weights in WEIGHTS:
    model = YOLO(weights)
    result = model("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
    fields = [f for f in FIELDS if getattr(result, f) is not None]
    print(f"{weights:17s} task={model.task:9s} fields={fields}")
yolo26n.pt task=detect fields=['boxes']
yolo26n-seg.pt task=segment fields=['boxes', 'masks']
yolo26n-sem.pt task=semantic fields=['semantic_mask']
yolo26n-pose.pt task=pose fields=['boxes', 'keypoints']
yolo26n-obb.pt task=obb fields=['obb']
yolo26n-cls.pt task=classify fields=['probs']
yolo26n-depth.pt task=depth fields=['depth']세그멘테이션과 포즈 결과에는 boxes이 유지되므로 기존 탐지 코드가 그대로 작동합니다. 분류, 시맨틱 세그멘테이션, 깊이 결과는 이미지 전체를 설명하며 객체별 필드는 없습니다.
result.boxes을 반복하는 탐지 코드는 OBB 모델에서 TypeError: 'NoneType' object is not iterable과 함께 중단됩니다. result.boxes는 None이며, 회전된 탐지 결과는 result.obb에만 있습니다. None이 있는지 검사해 탐지 결과가 0개가 되게 하는 대신, result.obb를 읽도록 탐지 코드를 OBB에 맞게 수정하세요.
모델 하나로 충분하지 않은 경우#
탐지를 넘어서는 대부분의 프로덕션 시스템은 다음 세 가지 유형 중 하나입니다.
- 탐지 후 분류. 탐지 모델은 큰 프레임에서 작은 객체를 찾고, 이미지 분류기는 전체 해상도 크롭마다 세부적으로 분류합니다. 예를 들어 헬멧 유형, 결함 등급, 제품 SKU를 판별합니다.
- 포즈와 추적. 키포인트는 한 프레임을 설명하고, 트래커는 이를 사람별 시계열로 변환하여 반복 횟수를 세거나 낙상을 감지할 수 있게 합니다.
- 세그멘테이션 후 측정. 모델은 픽셀을 반환하고, 일반 코드로 영역, 너비, 커버리지 비율 또는 (깊이 정보를 이용한) 거리를 계산합니다.
세그멘테이션 후 측정 파이프라인의 라벨은 객체당 폴리곤 하나입니다. 다음은 Ultralytics Platform 편집기에서 창고 로봇 위의 소포를 라벨링한 예입니다.
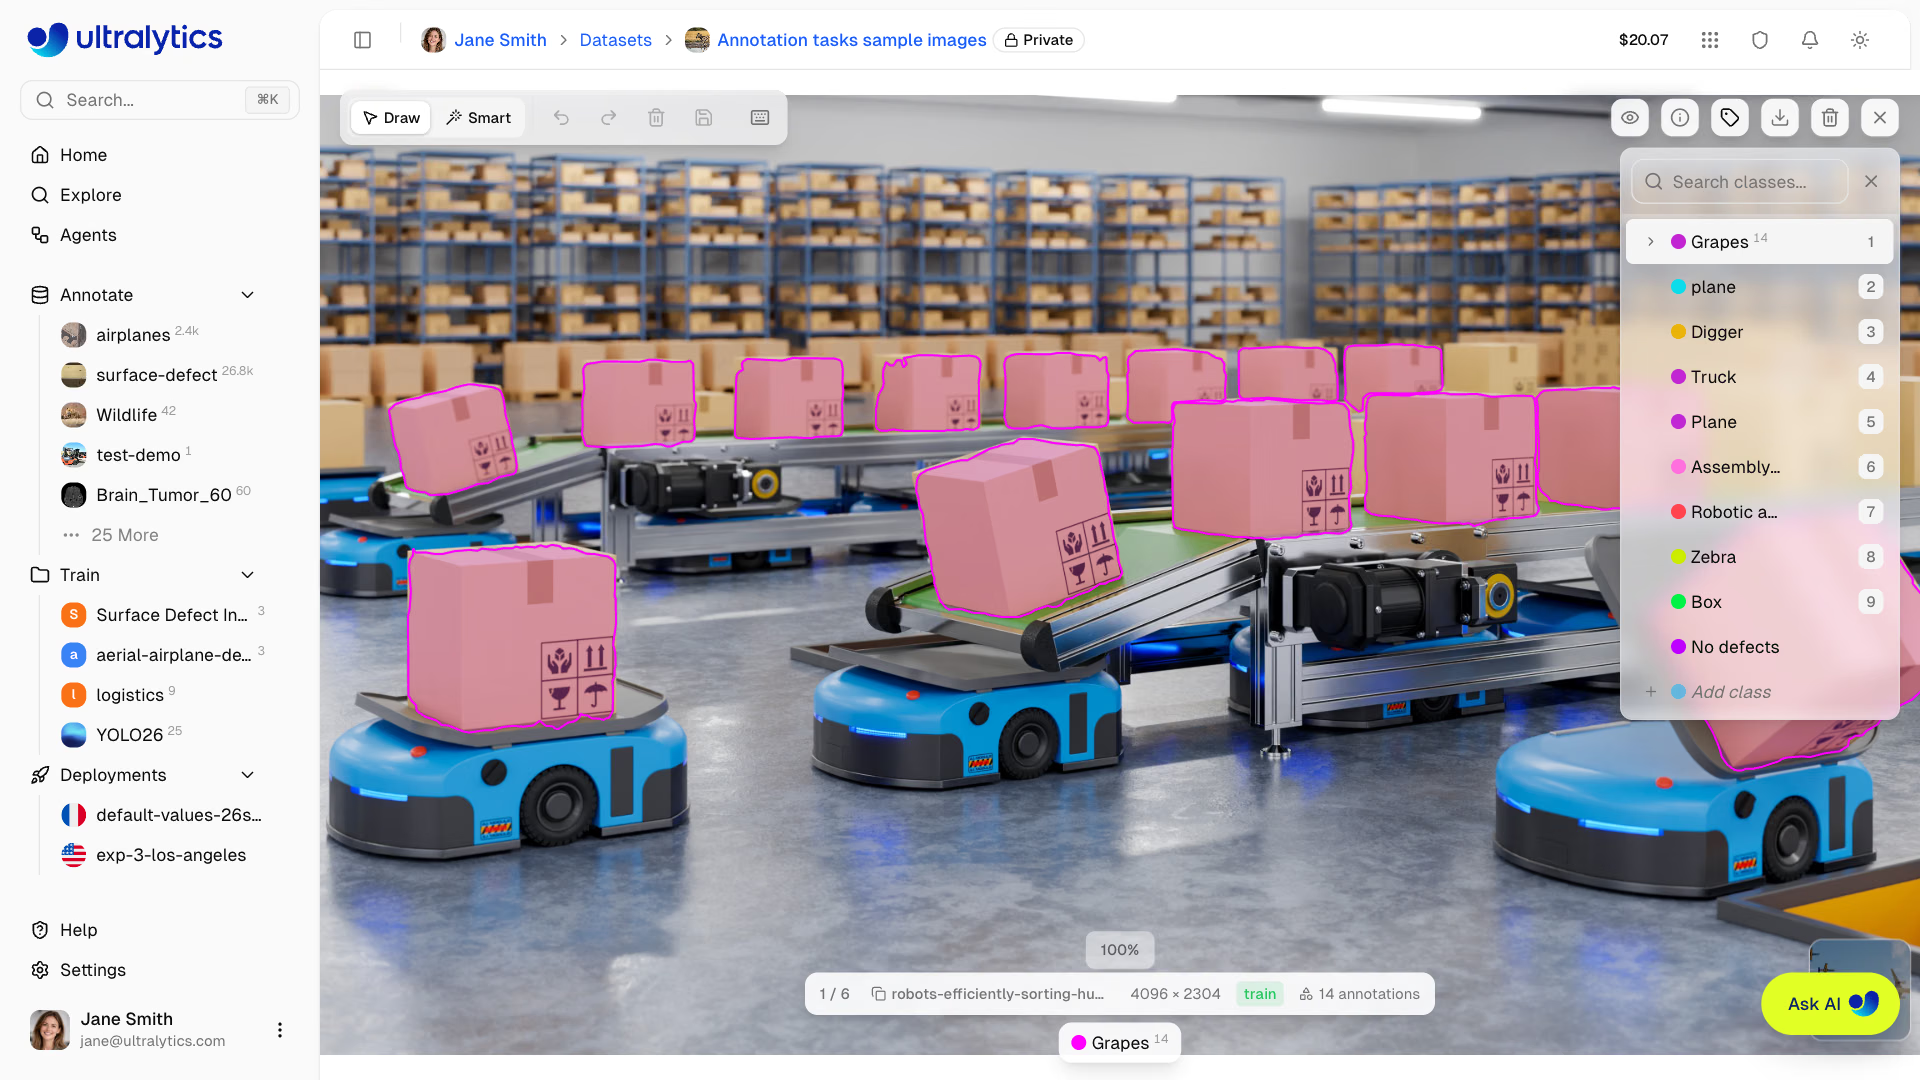
두 번째 모델을 추가하면 추론 지연 시간, 레이블을 지정하고 유지 관리할 두 번째 데이터셋, 모니터링할 두 번째 모델이 생깁니다. 한 작업만으로 질문에 답할 수 없을 때만 모델을 연결하세요. 레이블을 지정할 수 없는 3개 모델 계획보다 배포할 수 있는 1개 모델 계획이 낫습니다.
주의할 점#
증상: 마스크가 데모에서 보기 좋다는 이유로 팀이 폴리곤에 레이블을 지정했지만 제품에서는 개수만 읽습니다. 해결 방법: 레이블 지정 전에 출력을 사용하는 코드 줄을 명시하세요. 외곽선을 읽는 곳이 없다면 탐지기를 배포하세요. 박스는 레이블 지정과 실행이 모두 더 빠릅니다.
증상: 한 달 동안 레이블을 지정한 뒤 제품에 방향 정보가 필요하다는 사실을 알게 되었지만, 데이터셋에는 축 정보만 제공하는 OBB 레이블이 있습니다. 해결 방법: 계획에 정확한 속성(result.masks.xy, result.keypoints.xy, result.obb.xywhr)을 적고 첫 레이블을 지정하기 전에 선택한 가중치로 tasks.py을 실행하세요.
증상: 선명한 제품 사진에서 95%의 점수를 낸 분류기가 프로덕션의 탐지기 크롭 대부분을 잘못 분류합니다. 해결 방법: 실제 블러와 프레이밍이 반영되도록 첫 번째 단계에서 생성된 크롭으로 두 번째 단계의 데이터셋을 구성하세요. 강의 9에서 방법을 설명합니다.
정답 보기
팔레트 요청의 경우:
| 항목 | 선택 |
|---|---|
| 질문 | 팔레트의 어느 부분이라도 랙 빔 선을 넘어 돌출되어 있나요? |
| 작업 | segment — 돌출 여부는 팔레트의 윤곽에 따라 결정됩니다. 박스에는 팔레트 아래의 빈 공간과 위에 실린 화물도 포함됩니다. |
| 가중치 | 창고 카메라 프레임으로 파인튜닝한 yolo26n-seg.pt |
| 라벨 형식 | 팔레트당 폴리곤 하나 |
| 결과 필드 | 빔 선을 넘어선 픽셀을 판별하는 result.masks.data 및 retina_masks=True |
| 게이팅 지표 | 학습에서 제외한 카메라의 마스크 mAP50-95 |
| 두 번째 단계 | 없습니다 — 빔 라인은 카메라별로 고정되어 있으므로 모델이 아니라 설정입니다. |
오버행 규칙은 코드 세 줄이면 구현할 수 있습니다. 카메라별로 빔 라인을 한 번 그린 다음, 빔 라인의 잘못된 쪽에 있는 마스크 픽셀을 세고, 확인된 오버행 몇 건으로 보정한 픽셀 임계값을 초과하면 알립니다. Lesson 3에서는 이와 같은 마스크와 영역 간 비교 테스트를 정확히 보여줍니다.