Implementar e chamar um endpoint
Cria um endpoint dedicado numa das 42 regiões, dimensiona-o de acordo com o teu tráfego e chama-o com um cliente que lida com arranques a frio, erros 429 e chaves inválidas.
Um endpoint gratuito que reduz a escala a zero pode demorar até um minuto a responder ao primeiro pedido, e um cliente ingénuo transforma esse atraso num timeout visível para o utilizador. Uma chave exposta continua a funcionar mesmo depois de a eliminares. Nesta lição, implementas o teu modelo vencedor, dimensionas o endpoint de forma deliberada e escreves o pequeno cliente de que todas as integrações de produção precisam.
Prático
Inferência partilhada ou endpoint dedicado#
Já podes chamar qualquer modelo através da API de inferência partilhada da Platform, adequada para testes. O tráfego de produção deve usar um endpoint dedicado:
| Inferência partilhada | Endpoint dedicado | |
|---|---|---|
| Serviço | Partilhado entre utilizadores da Platform | Um modelo, inquilino único |
| Regiões | A tua região de dados (US, EU ou AP) | Qualquer uma das 42 regiões |
| Limite de taxa | 20 pedidos por minuto por chave | Sem limite da Platform para chamadas diretas |
| Tamanho do pedido | Cerca de 4.5 MB | 32 MB, até 1 hora por pedido (suporta vídeo) |
| Autenticação | Qualquer chave de API do workspace | Somente a chave vinculada à implantação |
Criar e dimensionar o endpoint#
Abra a guia Deploy do modelo. Seu navegador mede a latência para todas as 42 regiões (14 nas Américas, 13 na Europa, 12 na Ásia-Pacífico, 3 no Oriente Médio e na África) e ordena a tabela por latência:
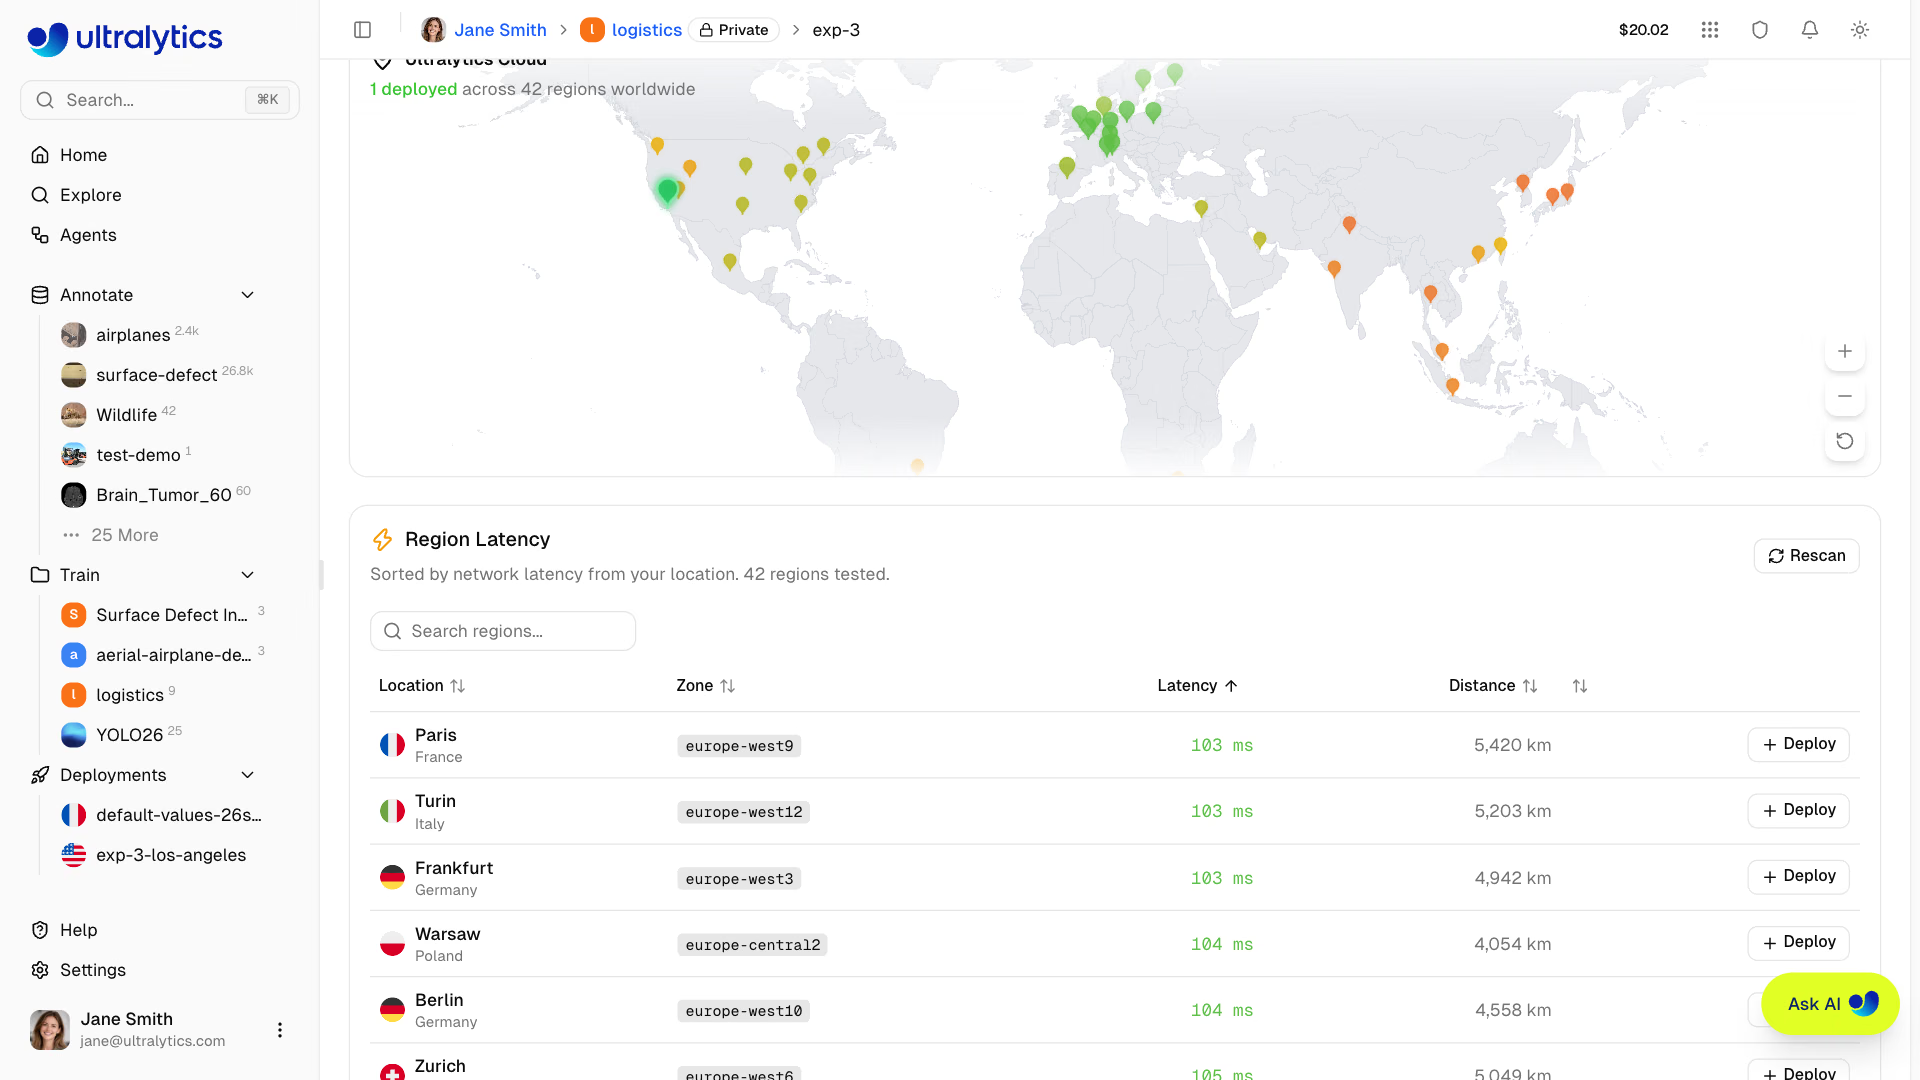
Clique em Deploy na linha mais próxima dos seus clientes, confira a CPU, a memória, o preço e o nome gerado (como yolo26n-iowa) e clique em Create Deployment. Você também pode começar por New Deployment na guia Deployments do seu perfil:
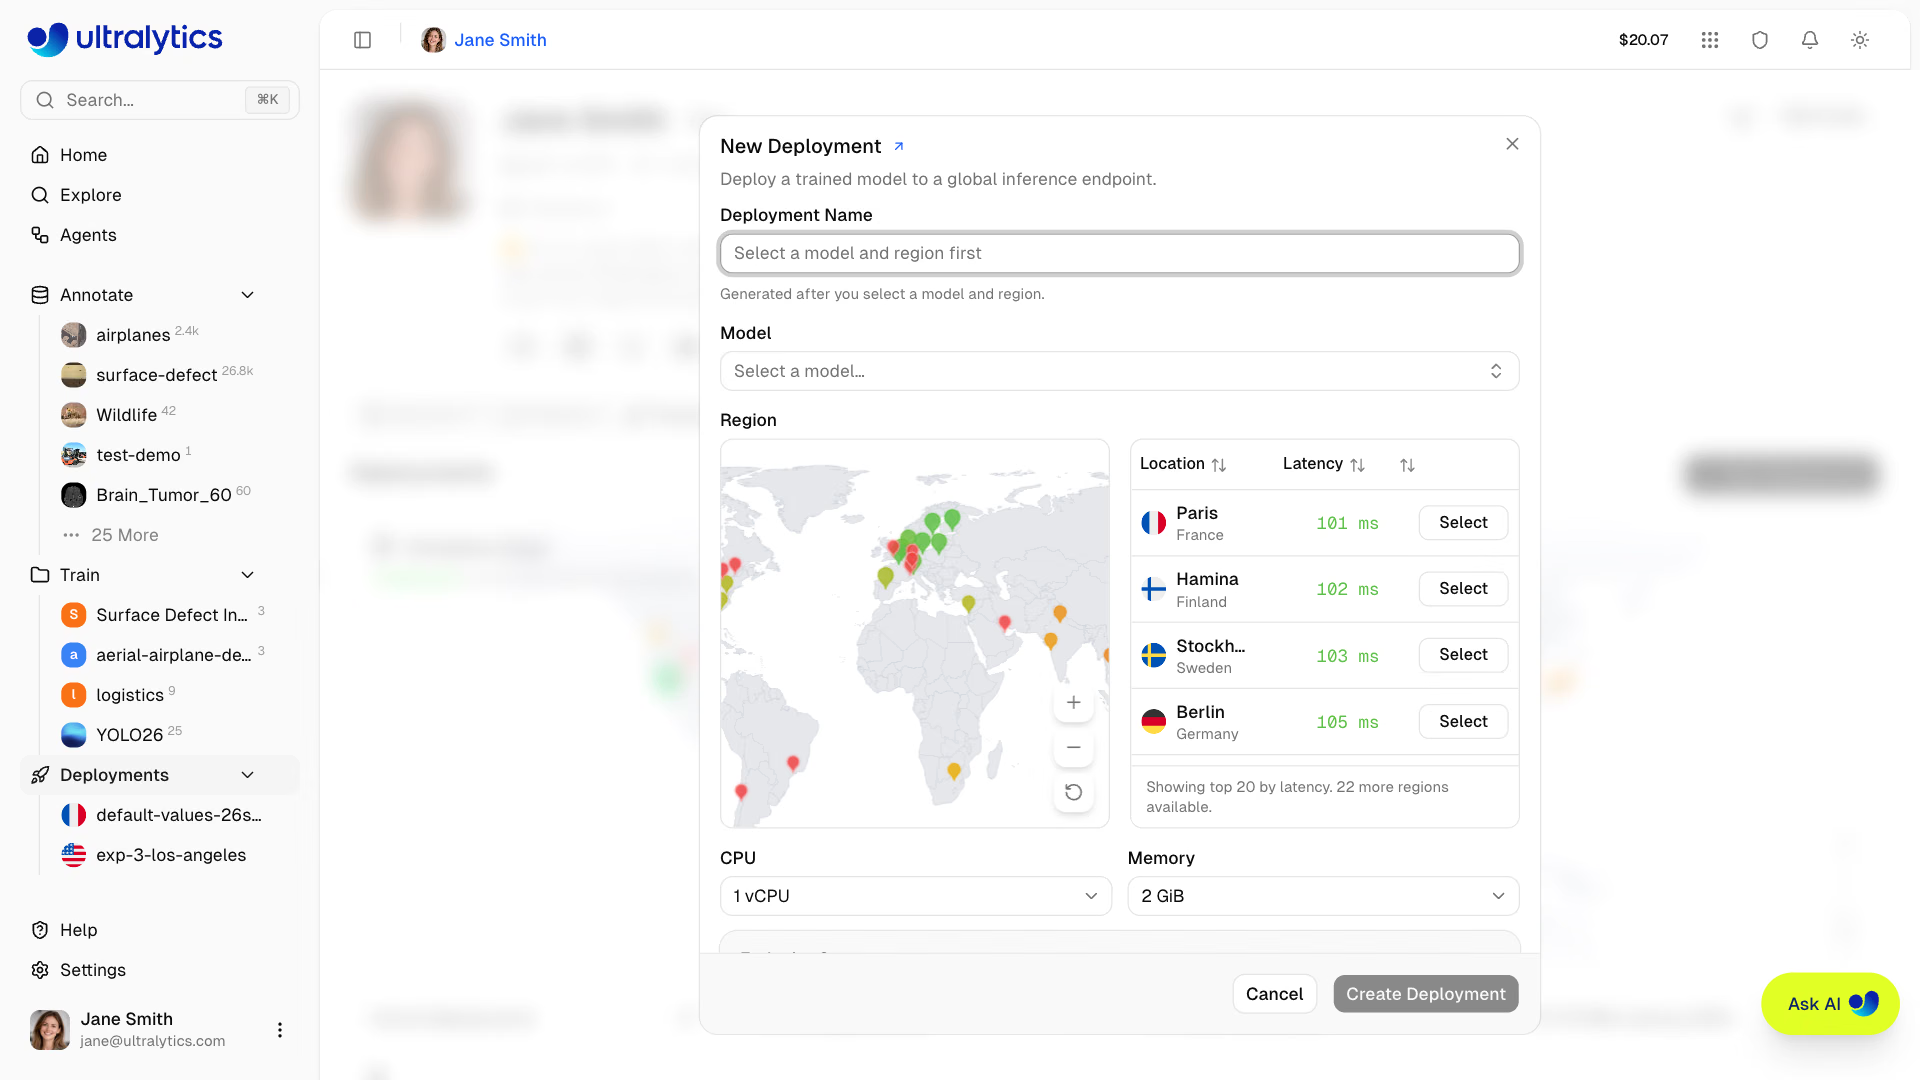
Dimensione de acordo com o padrão de tráfego:
| Tráfego | Quantidade | Custo |
|---|---|---|
| Tarefas em lote, ferramentas internas, demonstrações com picos de tráfego | Padrão: 1 vCPU, 2 GiB; escala até zero | Gratuito em todos os planos |
| Tráfego em tempo real constante que não pode esperar por uma inicialização a frio | Tamanho personalizado (1–8 vCPU, 2–32 GiB) com uma instância aquecida | Cobrança por hora a partir do momento em que fica pronta até ser interrompida, inclusive durante a inatividade: cerca de US$ 0,12/h por 1 vCPU e 4 GiB em Iowa |
| Usuários em vários continentes | Um endpoint por região, atrás do seu próprio roteador | Cada endpoint é cobrado de acordo com seu tamanho |
Os planos permitem 3 implantações (Free), 10 (Pro) ou um número ilimitado (Enterprise), e os endpoints interrompidos ainda contam. O endpoint aceita tráfego quando o selo mostra Ready:
Exemplo prático: um cliente que resiste em produção#
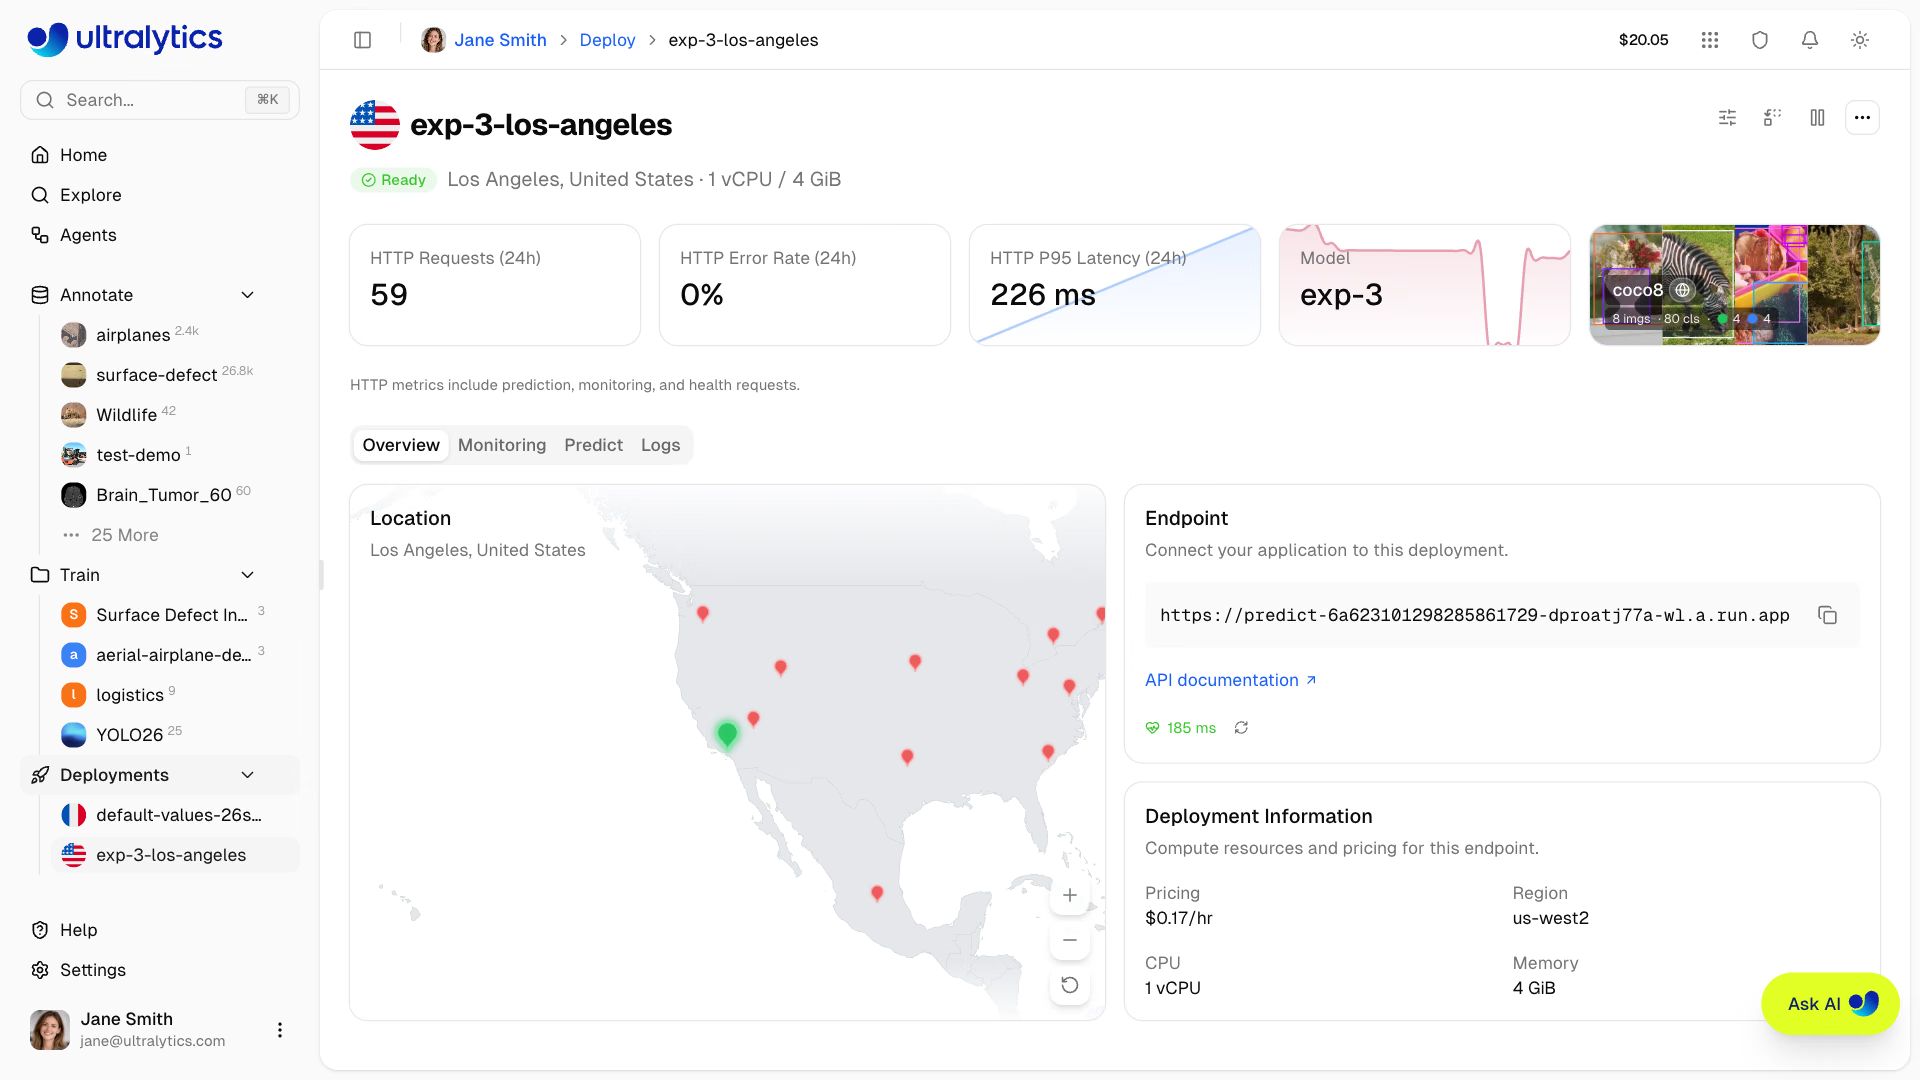
Cada endpoint tem uma URL como https://predict-<id>-<hash>-<region>.a.run.app que serve /predict (POST), /health e uma página interativa /docs. Ele aceita somente a chave de API vinculada na criação; os proprietários do workspace veem essa chave preenchida previamente na guia Predict da implantação, em Docs, ao lado dos exemplos de Python, JavaScript e cURL. Os exemplos fazem uma solicitação; o código de produção também precisa lidar com uma inicialização a frio e uma instância ocupada:
import os
import time
from collections import Counter

import httpx

URL = "https://YOUR_DEPLOYMENT_URL.run.app/predict"
HEADERS = {"Authorization": f"Bearer {os.environ['ULTRALYTICS_API_KEY']}"}  # the deployment's bound key, server-side only

def predict(client, path, conf=0.25, attempts=4):
    """POST one image; retry timeouts, 429, and 5xx with backoff; fail fast on other errors."""
    for attempt in range(attempts):
        try:
            with open(path, "rb") as f:
                r = client.post(URL, headers=HEADERS, data={"conf": conf}, files={"file": f}, timeout=90)
            if r.status_code < 400:
                return r.json()
            if r.status_code != 429 and r.status_code < 500:
                r.raise_for_status()  # 401 wrong key, 413 too large: retrying won't help
            wait, reason = float(r.headers.get("Retry-After", 2**attempt)), r.status_code
        except httpx.TimeoutException:  # a scaled-to-zero endpoint can take up to a minute to wake
            wait, reason = 2**attempt, "timeout"
        print(f"attempt {attempt + 1}: {reason}, retrying in {wait:.0f} s")
        time.sleep(wait)
    raise RuntimeError(f"endpoint still unavailable after {attempts} attempts")

with httpx.Client() as client:
    response = predict(client, "bus.jpg")
for image in response["images"]:
    counts = Counter(d["name"] for d in image["results"])
    print(f"{sum(counts.values())} objects {dict(counts)} in {image['speed']['inference']:.1f} ms")
Testamos com um stub local que responde 429 uma vez e, em seguida, retorna um resultado real do YOLO26n para bus.jpg no formato de resposta do endpoint:
attempt 1: 429, retrying in 2 s
5 objects {'bus': 1, 'person': 4} in 34.9 ms
As decisões importantes, linha por linha:
timeout=90cobre uma inicialização a frio de até cerca de um minuto; os tempos limite padrão da maioria dos clientes HTTP são bem mais curtos.- Erros 429 e 5xx são repetidos, respeitando
Retry-Afterquando o endpoint o envia. Cada endpoint atende por uma única instância e reduz a carga com429quando está ocupado. - Os outros erros 4xx falham imediatamente:
401significa que a chave está errada e413indica um corpo com mais de 32 MB; nenhum dos dois se corrige sozinho. - A resposta contém uma entrada por imagem (ou por quadro de vídeo) em
images, cada uma comresults(class,name,confidence,boxcomx1,y1,x2,y2) espeedem milissegundos.
Os campos opcionais do formulário são conf (padrão 0.25), iou (0.7), imgsz (o tamanho de treinamento do modelo), vid_stride para vídeo e normalize=true para coordenadas de 0 a 1. O equivalente em cURL usa uma linha por campo:
curl -X POST "https://YOUR_DEPLOYMENT_URL.run.app/predict" \
  -H "Authorization: Bearer $ULTRALYTICS_API_KEY" \
  -F "file=@bus.jpg" -F "conf=0.25" -F "iou=0.7" -F "imgsz=640"
Envie novas versões sem alterar a URL#
Replace model na página da implantação substitui o modelo por outro modelo concluído do mesmo workspace. O modelo antigo continua atendendo até que o novo esteja pronto; a URL, a região e a chave permanecem iguais e, se a implantação falhar, o modelo anterior continua ativo. Para reverter, basta executar a mesma ação selecionando o modelo anterior, então mantenha-o no projeto. Update configuration redimensiona a implantação no local, e Stop pausa a cobrança e mantém a URL.
Algumas alterações exigem um novo endpoint: as regiões são fixas (para mudar, é preciso excluir e recriar, gerando uma nova URL), e domínios personalizados não são aceitos; portanto, coloque seu próprio gateway na frente se os clientes precisarem de um nome de host de marca estável. Para executar fora da Platform, exporte o modelo (Export for Deployment) ou hospede-o por conta própria usando o Triton Inference Server.
Armadilhas#
Sintoma: seu endpoint recebe tráfego que você não consegue explicar. Solução: nunca coloque a chave em um aplicativo Web ou móvel; faça chamadas ao endpoint pelo seu backend. Excluir ou desativar a chave vinculada não bloqueia o endpoint, pois ele continua aceitando essa chave. Para revogar o acesso, pare ou exclua a implantação e crie uma nova vinculada a uma chave recém-gerada.
Sintoma: a primeira solicitação da manhã falha, mas a tentativa seguinte funciona. Solução: endpoints de tamanho padrão reduzem a escala a zero. Use um tempo limite de pelo menos 90 segundos, aqueça o endpoint com uma chamada /health antes do tráfego previsto ou mude para um tamanho personalizado se todas as solicitações precisarem ser rápidas.
Sintoma: os carregamentos falham com 413. Solução: endpoints dedicados aceitam corpos de solicitação de até 32 MB. Divida vídeos longos em clipes mais curtos ou envie quadros amostrados e passe vid_stride para ignorar quadros no servidor.
Mostrar solução
Exemplo de resposta para a câmera da linha de comprimidos: implante v2-finetune em europe-west1 (St. Ghislain, a região com menor latência a partir da fábrica alemã), no tamanho padrão. Solicitação a frio após uma hora de inatividade: 38 s, dentro do limite de 90 segundos; solicitação aquecida: 0,3 s. Decisão: o CLP da linha envia um quadro a cada 30 segundos durante os turnos, então o endpoint permanece aquecido durante todo o turno e somente o primeiro quadro enfrenta uma inicialização a frio. Uma chamada /health do controlador da linha 2 minutos antes de cada turno também elimina esse tempo, portanto o tamanho padrão gratuito é suficiente, economizando cerca de US$ 90 por mês em comparação com uma instância personalizada de 1 vCPU e 4 GiB. Substituir o modelo por v1-baseline retorna os resultados de v1 pela mesma URL; substitua-o novamente por v2 para concluir.