Monitore a integridade e a precisão
Consulte as métricas dos endpoints e as estatísticas de previsões da Platform, configure alertas a partir de uma verificação de integridade agendada e detecte desvios de precisão com uma tarefa de holdout.
Um endpoint pode retornar 200 OK em todas as solicitações enquanto sua precisão cai 5 pontos porque a equipe do turno da noite diminuiu a iluminação. A Platform mostra o comportamento de cada endpoint, mas não envia alertas e não consegue avaliar a precisão sem rótulos. Esta lição cria as duas verificações agendadas que resolvem essa lacuna e ensaia o alerta de precisão com um turno da noite simulado.
Prático
O que a Platform mostra#

| Sinal | Onde | Por quanto tempo fica disponível |
|---|---|---|
| Solicitações HTTP, taxa de erros (4xx e 5xx), latência P95 | Cartões na página da implantação e na guia Deployments, atualizados a cada minuto | Os cartões abrangem 24 horas; a API disponibiliza dados de 1 hora a 30 dias |
| Integridade | Cartão Endpoint na guia Overview | Ao vivo; novas tentativas automáticas enquanto estiver com problemas |
| Logs | Guia Logs: 20 entradas mais recentes, filtro Errors | A API retorna até 200 entradas por solicitação, com paginação |
| Estatísticas de previsões e exemplos temporários (até 100 imagens) | Guia Monitoring | Somente na memória da instância que atende às solicitações |
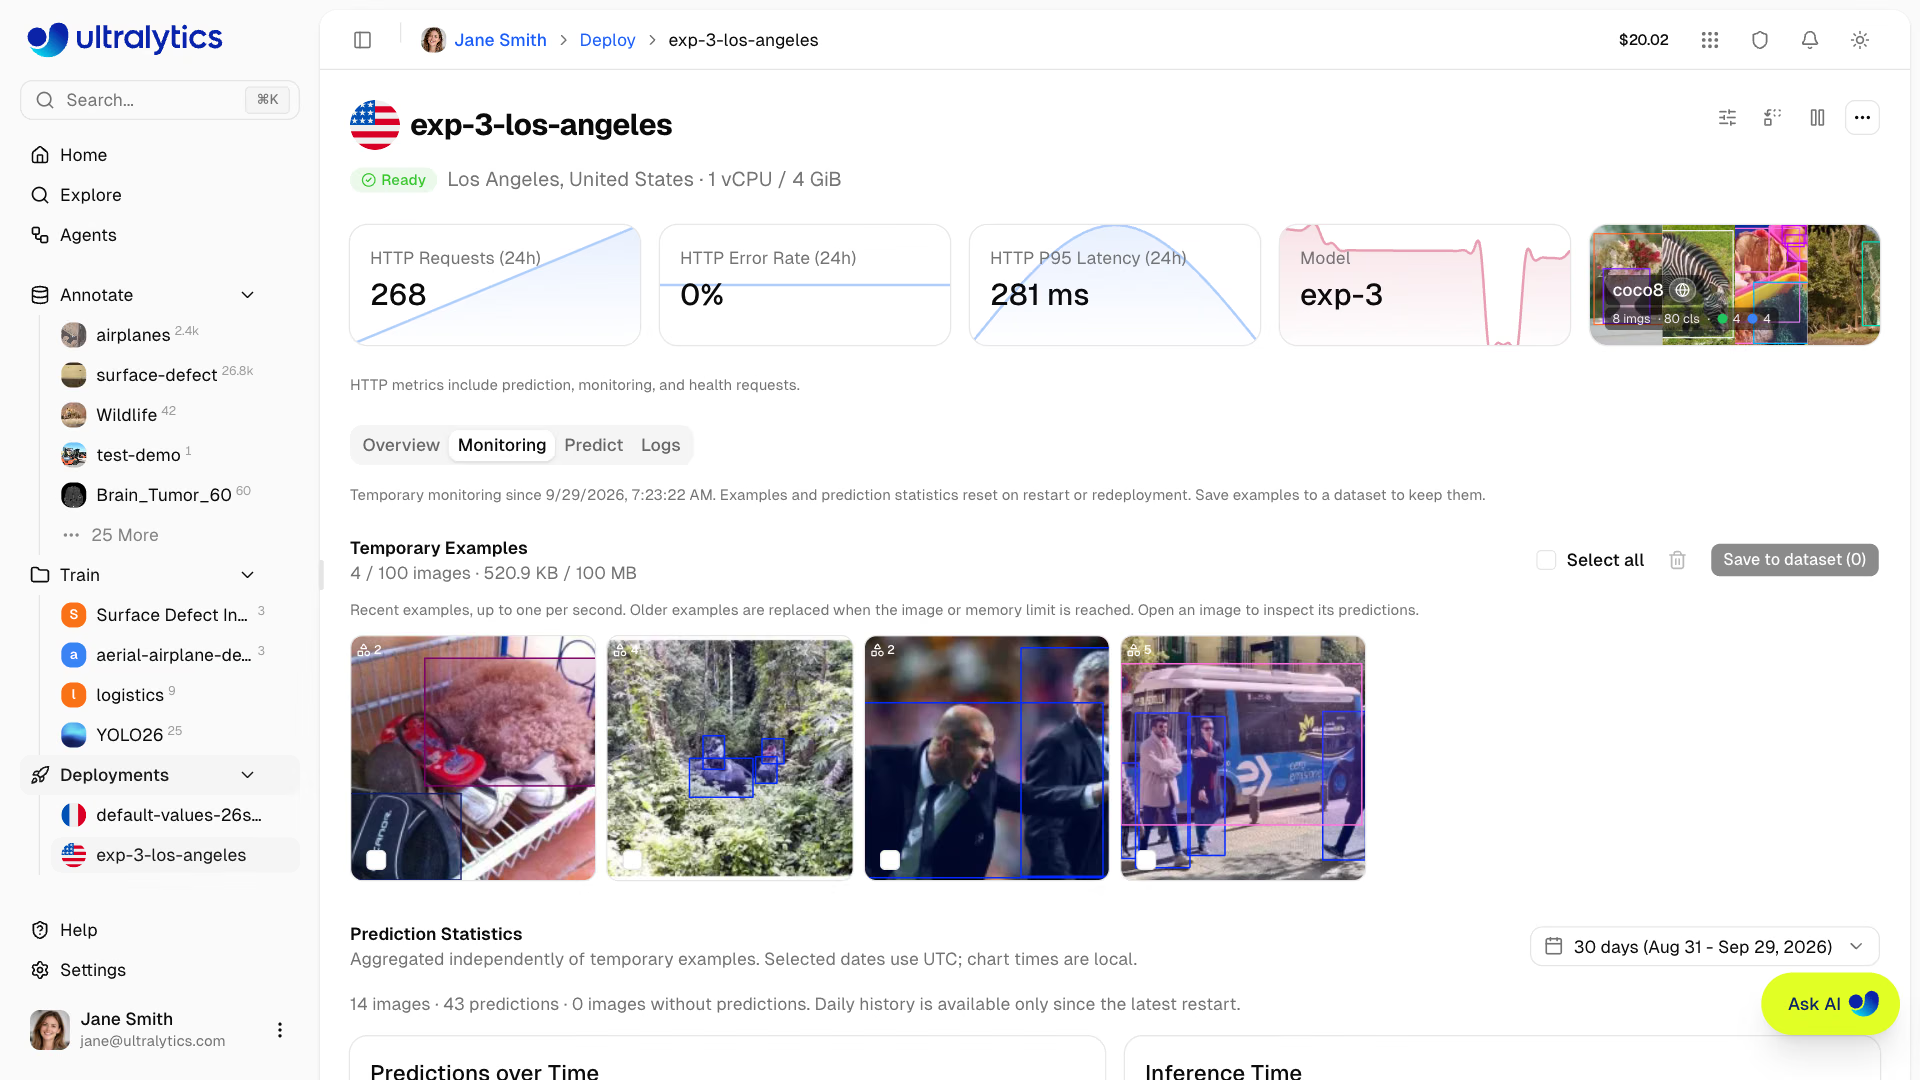
Duas ressalvas determinam todo o resto. As métricas são coletadas somente enquanto o endpoint está Ready, e excluir uma implantação encerra o acesso ao histórico dela. As estatísticas e os exemplos da guia Monitoring são perdidos sempre que o endpoint para, reinicia, é redimensionado ou tem o modelo substituído: é uma visualização ao vivo, não um arquivo.
Exemplo prático: uma verificação agendada do endpoint#
A Platform deixa o cartão de taxa de erros vermelho quando ultrapassa 5%, e o Slack pode anunciar quando uma implantação fica pronta ou falha ao iniciar, mas não há alertas por limite. Execute esta verificação a cada 5 minutos usando cron, CI ou seu agente de monitoramento e envie um alerta se o código de saída for diferente de zero:
from ultralytics_platform import Platform

OWNER, DEPLOYMENT = "your-username", "yolo26n-iowa"  # from the deployment page URL
P95_BUDGET_MS, MAX_ERROR_RATE = 300, 1.0  # errorRate is a percentage

with Platform() as client:  # reads ULTRALYTICS_API_KEY
    health = client.deployments.health(OWNER, DEPLOYMENT)
    summary = client.deployments.metrics(OWNER, DEPLOYMENT, range="1h", view="overview")["summary"]
    print(
        f"healthy={health['healthy']} requests={summary['totalRequests']} "
        f"p95={summary['p95LatencyMs']:.0f} ms errors={summary['errorRate']:.2f}%"
    )
    if not health["healthy"] or summary["p95LatencyMs"] > P95_BUDGET_MS or summary["errorRate"] > MAX_ERROR_RATE:
        for entry in client.deployments.logs(OWNER, DEPLOYMENT, severity="ERROR,WARNING", limit=5)["entries"]:
            print(entry["timestamp"], entry["severity"], entry["message"][:120])
        raise SystemExit(1)  # non-zero exit lets cron, CI, or your pager treat it as an alert
Quando executado com uma API simulada que retorna um endpoint íntegro, o código exibe uma linha e retorna 0; com P95_BUDGET_MS = 100, os mesmos dados retornam 1:
healthy=True requests=1200 p95=180 ms errors=0.40%healthverifica o endpoint e retornahealthy,statuselatencyMs. Também ativa um endpoint cuja escala chegou a zero, então uma verificação a cada 5 minutos funciona como uma chamada para mantê-lo aquecido.metrics(..., view="overview")retornatotalRequests,errorRate(uma porcentagem) ep95LatencyMspara o intervalo.logsbusca os erros e avisos mais recentes, para que o alerta já chegue com uma primeira pista.
Instale o SDK com pip install -U ultralytics-platform (o SDK exige Python 3.11 ou superior). Envie alertas somente para violações persistentes, por exemplo, três verificações com falha consecutivas, e inclua em cada alerta uma entrada de runbook de uma linha.
Exemplo prático: acompanhe a precisão com um holdout#
As métricas das solicitações não mostram a precisão, mas um holdout pode: 200–500 imagens realistas de produção, rotuladas cuidadosamente em uma versão privada própria do conjunto de dados, nunca usadas no treinamento. Avalie semanalmente o checkpoint implantado e acrescente os resultados a um arquivo de histórico:
import json
import sys
from datetime import date
from pathlib import Path

from ultralytics import YOLO

DEPLOYED = "pills-v1.pt"  # the exact best.pt behind the endpoint
HOLDOUT = sys.argv[1] if len(sys.argv) > 1 else "medical-pills.yaml"  # labeled, never trained on

metrics = YOLO(DEPLOYED).val(data=HOLDOUT, split="val", plots=False, verbose=False)
history = Path("holdout_history.jsonl")
rows = [json.loads(line) for line in history.read_text().splitlines()] if history.exists() else []
row = {"date": date.today().isoformat(), "data": HOLDOUT, "map50_95": round(float(metrics.box.map), 4)}
history.write_text("".join(json.dumps(r) + "\n" for r in [*rows, row]))

baseline = rows[0]["map50_95"] if rows else row["map50_95"]
drop = baseline - row["map50_95"]
print(f"holdout mAP50-95 {row['map50_95']:.3f} (baseline {baseline:.3f}, drop {drop:+.3f})")
if drop > 0.01:  # more than 1 mAP point below the deployment-day baseline
    raise SystemExit("ALERT: holdout accuracy regressed - open the retraining runbook")
A primeira execução registra a linha de base do dia da implantação. Em seguida, ensaie o alerta antes de precisar dele: este script cria uma cópia do holdout do "turno da noite", com os mesmos rótulos e imagens a 15% de brilho:
import shutil
from pathlib import Path

import cv2

from ultralytics.data.utils import check_det_dataset

src = Path(check_det_dataset("medical-pills.yaml")["path"])
dst = Path("pills-night")
(dst / "images/val").mkdir(parents=True, exist_ok=True)
for img in (src / "images/val").glob("*.jpg"):  # darken every holdout image to mimic a dim night shift
    cv2.imwrite(str(dst / "images/val" / img.name), (cv2.imread(str(img)) * 0.15).astype("uint8"))
shutil.copytree(src / "labels/val", dst / "labels/val", dirs_exist_ok=True)  # same labels, darker pixels
Path("pills-night.yaml").write_text(f"path: {dst.resolve()}\ntrain: images/val\nval: images/val\nnames:\n  0: pill\n")
print("wrote pills-night.yaml")
$ python holdout_check.py
holdout mAP50-95 0.659 (baseline 0.659, drop +0.000)
$ python simulate_night_shift.py
wrote pills-night.yaml
$ python holdout_check.py pills-night.yaml
holdout mAP50-95 0.609 (baseline 0.659, drop +0.050)
ALERT: holdout accuracy regressed - open the retraining runbookTodas as solicitações durante o turno da noite ainda retornariam 200 em milissegundos, mas o modelo perdeu 5 pontos de mAP. Só o holdout detecta isso. Atualize o holdout a cada trimestre com novas imagens de produção rotuladas e redefina a linha de base sempre que implantar um novo modelo. O guia de monitoramento de modelos e a lição Observabilidade e deriva abordam testes estatísticos de deriva.
Leia a guia Monitoring para detectar deriva#
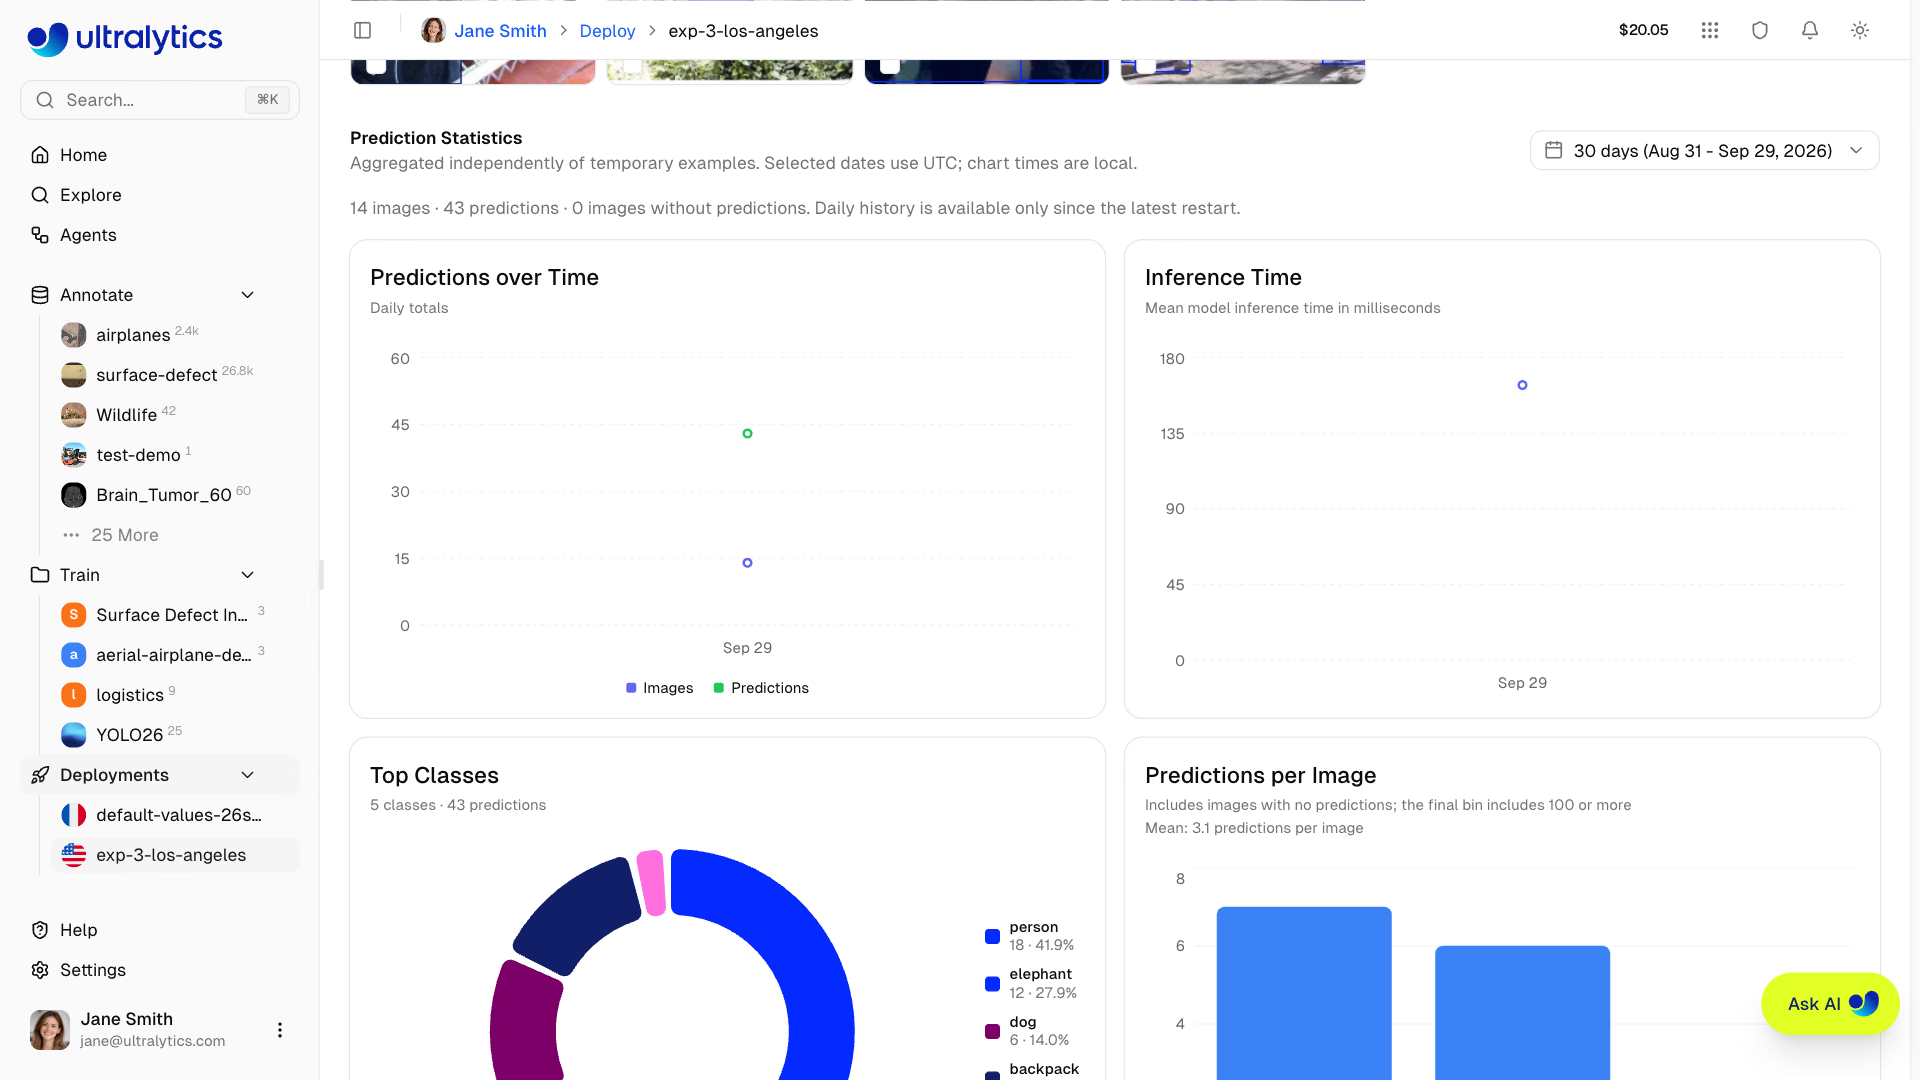
Observe o formato dos gráficos na semana da implantação e depois compare. A confiança mede a certeza, não a correção; por isso, analise estes dados junto com o holdout:
| Padrão | Causa provável | Ação |
|---|---|---|
| A confiança cai, o holdout permanece estável | Mudança benigna de domínio | Acompanhe; salve exemplos para a próxima versão do conjunto de dados |
| A confiança e o holdout caem | Regressão real de precisão | Treine novamente (lição 10) |
| O tamanho ou a localização das caixas muda de repente | A câmera foi movida, ou a lente ou o local mudou | Verifique a câmera antes de mexer no modelo |
| As previsões por imagem diminuem, mas a confiança permanece estável | Câmera desconectada, cena mais tranquila ou bug no cliente | Investigue os sistemas upstream |
| A latência P95 aumenta, mas o tempo de inferência permanece estável | Processamento da solicitação, tamanho do payload ou capacidade | Infraestrutura, não o modelo |
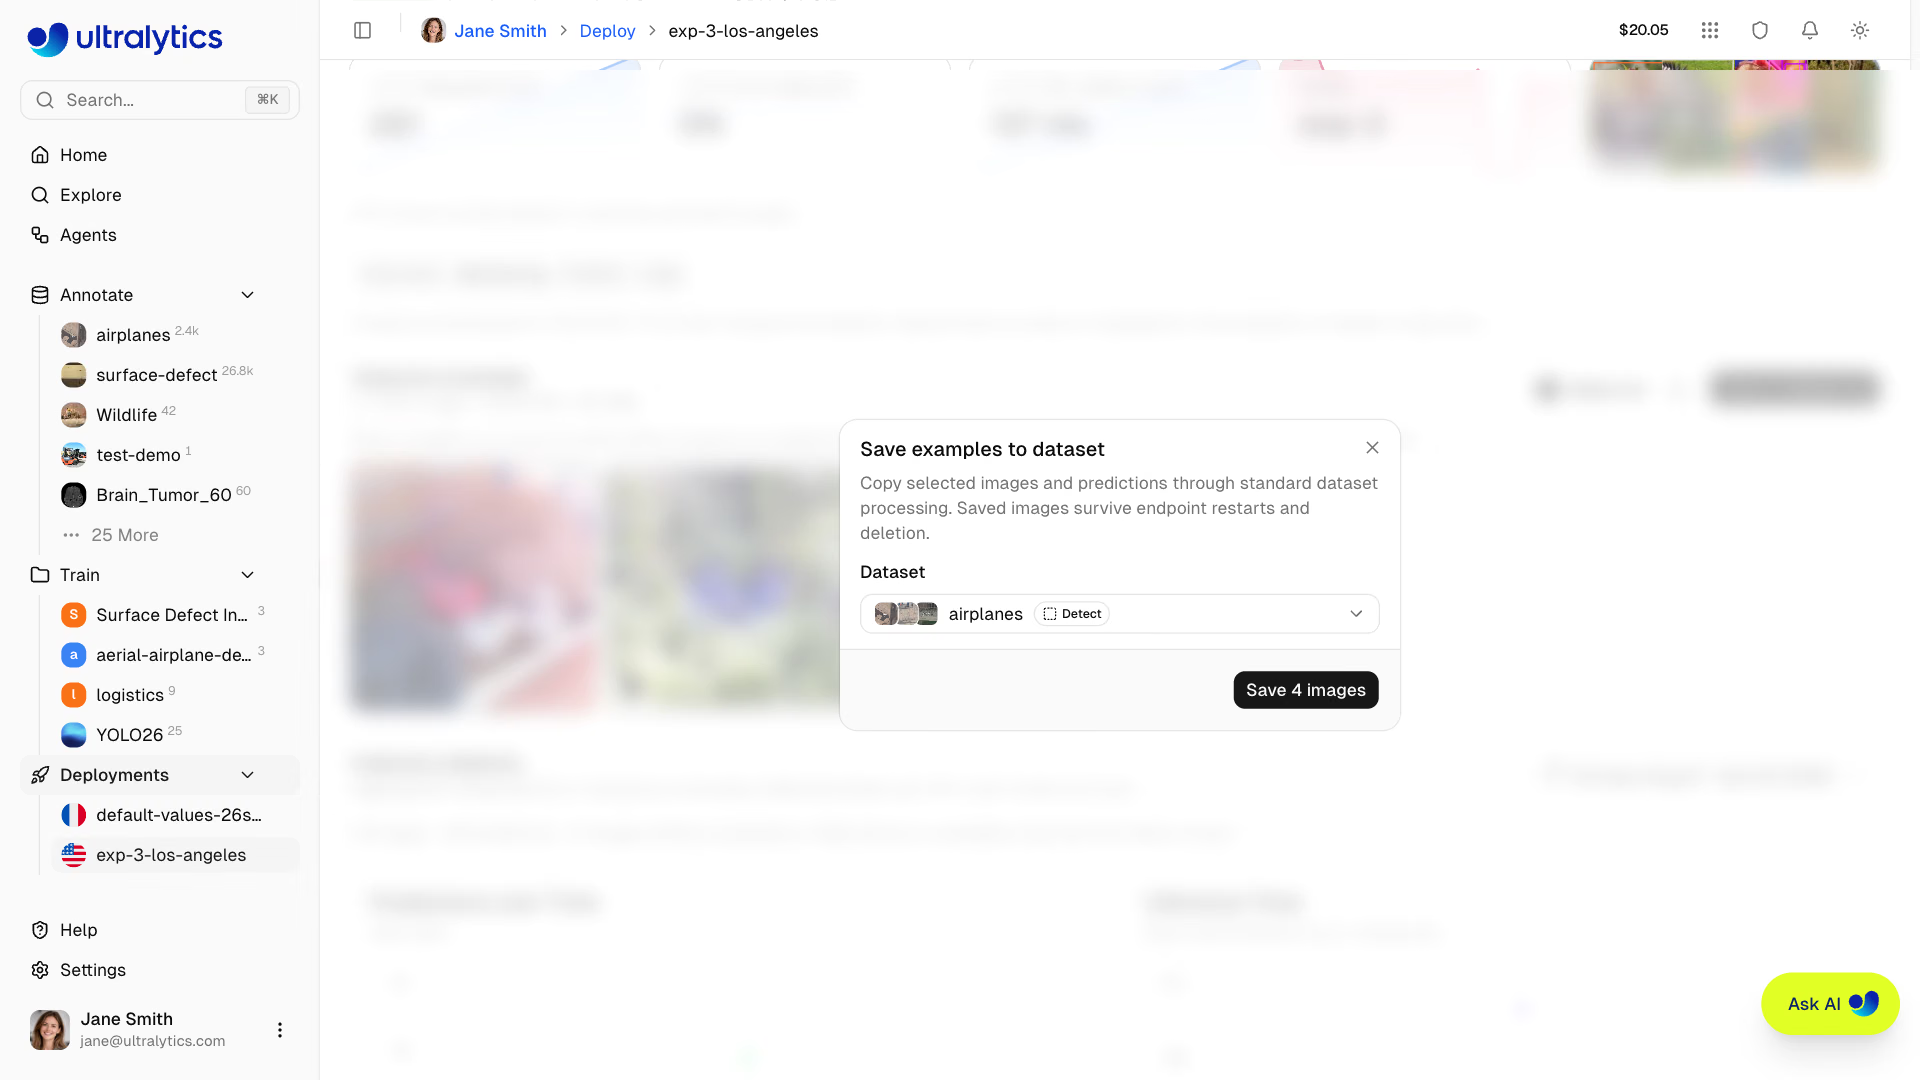
Incorpore imagens de produção ao conjunto de dados#
Na guia Monitoring, selecione exemplos e clique em Save to dataset; eles passam pelo processo normal de ingestão, junto com as previsões, e mantêm deploymentId e a região nos metadados. O modelo Collect Uncertain Detections de Agents faz o mesmo para um conjunto de dados inteiro: prevê usando sua implantação e copia as imagens com detecções dentro de um intervalo de confiança para um conjunto de dados de revisão.
Armadilhas#
Sintoma: os exemplos que você pretendia rotular desaparecem após redimensionar a instância ou trocar de modelo. Solução: eles ficam na memória da instância de serviço. Salve-os em um conjunto de dados e aguarde a conclusão da ingestão antes de parar, redimensionar ou substituir o modelo.
Sintoma: o alerta do conjunto de validação é acionado logo após a implantação de um modelo melhor, ou nunca mais é acionado. Solução: a linha de base é a primeira linha do histórico. Inicie um novo holdout_history.jsonl (ou registre uma nova linha de linha de base) sempre que substituir o modelo.
Sintoma: a taxa de erros aumenta durante um pico de tráfego, enquanto o estado de saúde permanece normal. Solução: respostas 429 contam como erros, mas significam 'no limite da capacidade'. Confira os registros; se forem erros 429, distribua o tráfego entre mais endpoints ou use um tamanho personalizado maior.
Mostrar solução
Resposta resolvida para o endpoint de pílulas: uma entrada cron */5 * * * * python endpoint_check.py || ./page-oncall.sh com P95_BUDGET_MS = 300 e MAX_ERROR_RATE = 1.0; definir o orçamento como 100 ms diante de um P95 real de 180 ms termina com o código 1 e envia um alerta, portanto, a configuração funciona. O trabalho semanal de CI executa holdout_check.py com DEPLOYED = "pills-v2.pt" na versão privada de 300 imagens do conjunto de validação: linha de base de 0.69. O ensaio do turno da noite reduz esse valor em 0.05 e exibe a linha ALERT com o código de saída 1, o que faz o trabalho de CI falhar e notifica o canal. Doze exemplos de Monitoramento do turno da noite são enviados para pill-review por meio de Salvar no conjunto de dados, cada um marcado com deploymentId e europe-west1.