Organizar, remover duplicados e dividir
Encontra duplicados entre divisões e lacunas nas classes com dois scripts curtos, divide segundo a unidade relevante e congela uma versão auditada do conjunto de dados.
A fiabilidade de uma pontuação de validação depende da fiabilidade da divisão. COCO128, um conjunto de dados de demonstração popular, usa deliberadamente as mesmas 128 imagens para treino e validação; se reproduzires esse erro nos teus próprios dados, terás um modelo «excelente» que falha com a próxima câmara. Nesta lição, são feitas duas auditorias em dados reais: uma verificação de duplicados e uma auditoria das classes por divisão. Em seguida, os dados são divididos por câmara e é congelada uma versão que passou ambas as verificações.
Prático
Exemplo prático: encontrar imagens partilhadas entre divisões#
A Platform mantém uma cópia de cada imagem por divisão e pergunta como gerir colisões durante o carregamento, mas nada impede que a mesma imagem ou cena acabe tanto no treino como na validação. Verifica antes de carregar e novamente depois de combinar conjuntos de dados:
import hashlib
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("coco128.yaml")  # any local YOLO dataset YAML before you upload it

def hashes(split_dir):
    return {hashlib.md5(p.read_bytes()).hexdigest(): p.name for p in Path(split_dir).rglob("*.jpg")}

train, val = hashes(data["train"]), hashes(data["val"])
shared = train.keys() & val.keys()
print(f"train {len(train)} images, val {len(val)} images, identical in both: {len(shared)}")
print("examples:", sorted(val[h] for h in shared)[:3])
train 128 images, val 128 images, identical in both: 128
examples: ['000000000009.jpg', '000000000025.jpg', '000000000030.jpg']Todas as imagens de validação do COCO128 também são imagens de treino. Isso é intencional num conjunto de dados de teste rápido e explica exatamente por que motivo o mAP de validação não diz nada sobre a generalização. Nos teus dados, qualquer contagem diferente de zero indica uma fuga: move ou elimina uma cópia de cada imagem antes do treino.
Detetar quase duplicados com o Agrupamento#
Os hashes só detetam bytes idênticos. Fotogramas de vídeo consecutivos, fotografias em sequência e cópias reencodificadas diferem em alguns píxeis. Abre o ícone de gráfico de dispersão na barra de ferramentas da galeria e clica em Analyze Dataset (de 20 a 200,000 imagens, apenas conjuntos de dados carregados):
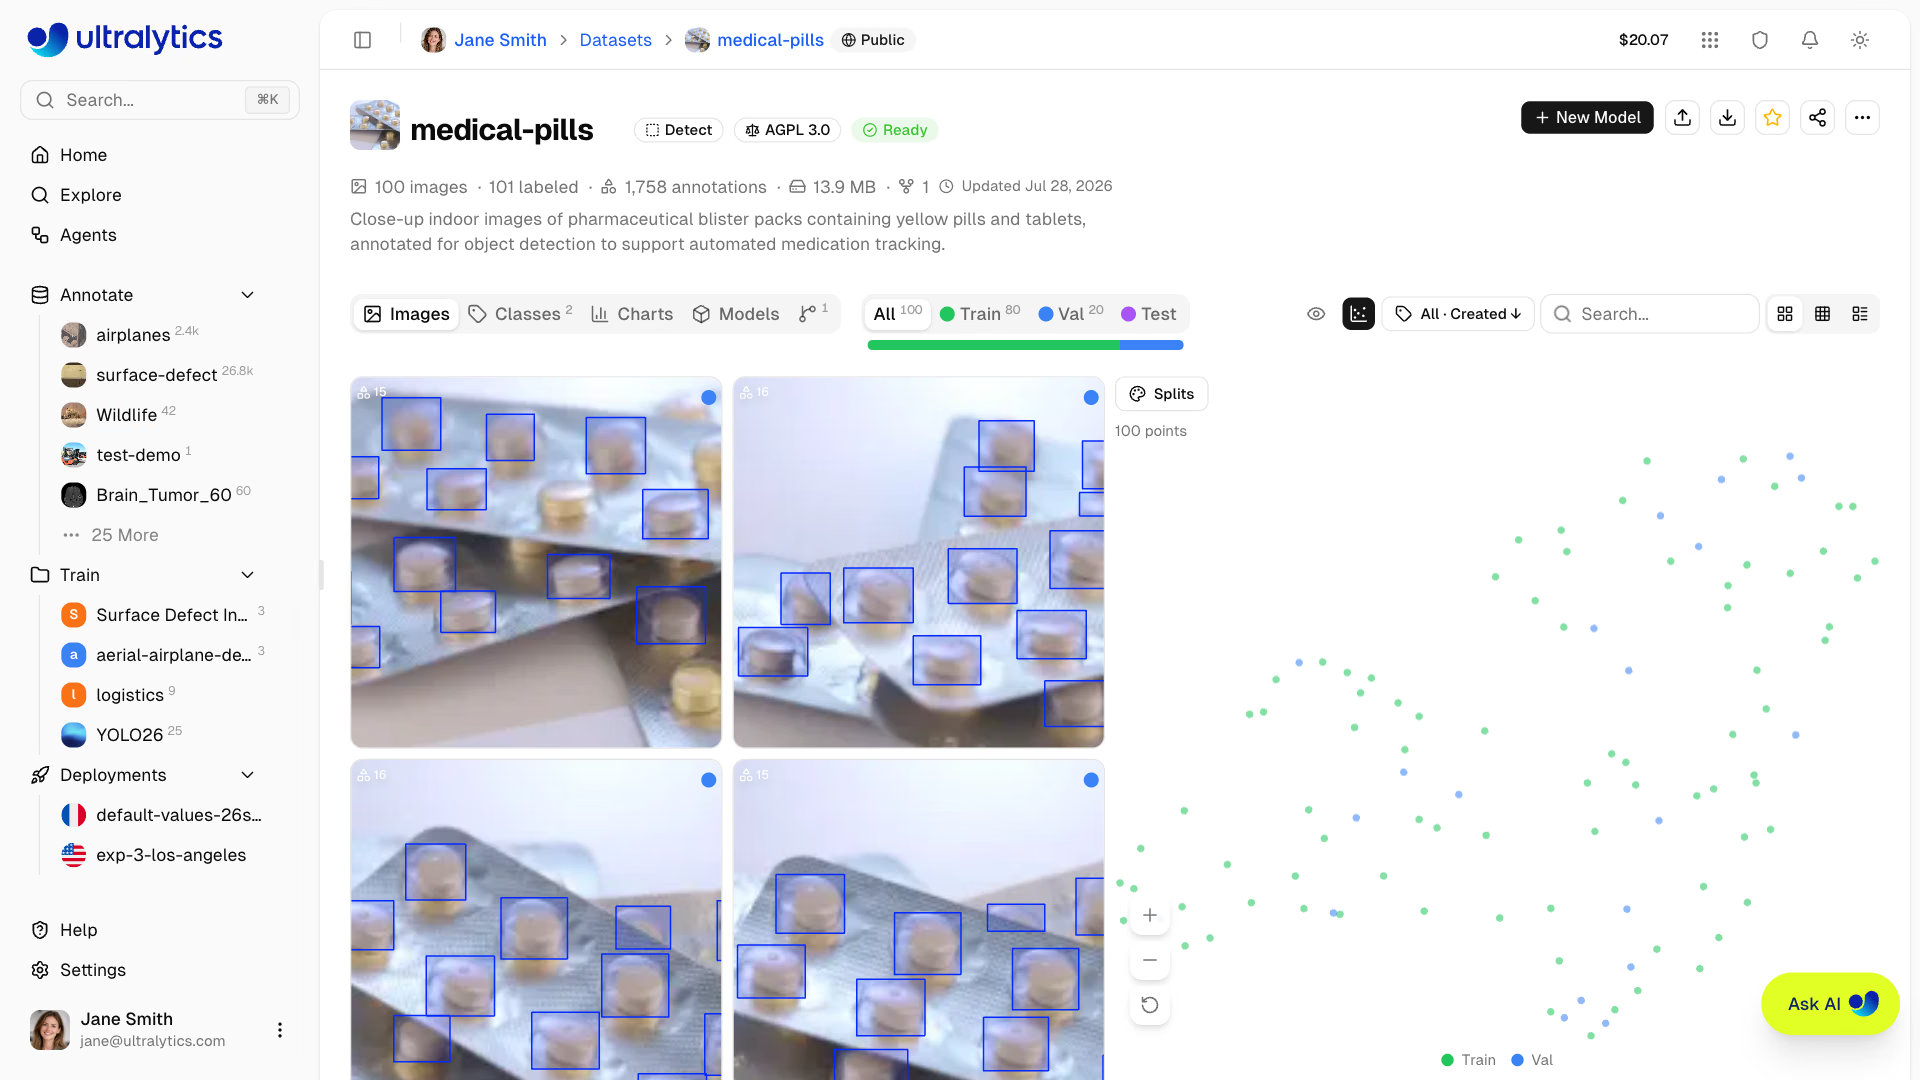
- Colorir por divisões: um grupo compacto que mistura pontos de treino e validação indica uma fuga de quase duplicados.
- Colorir por grupos ou classes: um grande grupo de uma só classe mostra o que está sobrerrepresentado no conjunto de dados; pontos isolados são valores atípicos (câmara incorreta, fotograma corrompido, imagem com etiquetas erradas).
- Seleciona com o laço ou clica numa região para filtrar a galeria e mostrar essas imagens (até 1,000); depois, elimina-as, move-as ou altera as respetivas etiquetas.
As mesmas incorporações alimentam a opção Encontrar imagens semelhantes no menu de contexto da imagem, que adiciona imagens parecidas de conjuntos de dados públicos e da equipa a train como imagens sem etiqueta: a forma mais rápida de preencher uma lacuna detetada na auditoria abaixo.
Exemplo prático: auditar as classes por divisão#
Descarrega a exportação NDJSON a partir do cabeçalho do conjunto de dados ou do separador Versões. Cada linha depois do cabeçalho corresponde a uma imagem com a respetiva divisão e etiquetas, pelo que bastam algumas linhas de Python para contar todas as classes em cada divisão. O exemplo seguinte usa a exportação pública do COCO8:
import json
from collections import Counter, defaultdict

counts = defaultdict(Counter)  # split -> class name -> instances
images = Counter()
with open("coco8.ndjson") as f:  # the NDJSON export from the dataset header or Versions tab
    header = json.loads(f.readline())
    names = header["class_names"]
    for line in f:
        record = json.loads(line)
        images[record["split"]] += 1
        for box in (record.get("annotations") or {}).get("boxes", []):
            counts[record["split"]][names[str(box[0])]] += 1

print("images per split:", dict(images))
for name in sorted(set(counts["train"]) | set(counts["val"])):
    train, val = counts["train"][name], counts["val"][name]
    flag = "missing in train" if not train else "too few in val" if val < 10 else ""
    print(f"{name:<14} train {train:>3}  val {val:>3}  {flag}")
images per split: {'train': 4, 'val': 4}
bowl train 3 val 0 too few in val
broccoli train 1 val 0 too few in val
dog train 0 val 1 missing in train
elephant train 0 val 2 missing in train
giraffe train 2 val 0 too few in val
horse train 0 val 2 missing in train
orange train 4 val 0 too few in val
person train 0 val 10 missing in train
potted plant train 1 val 1 too few in val
umbrella train 0 val 1 missing in train
vase train 1 val 0 too few in val
zebra train 1 val 0 too few in valComo interpretar: a linha do cabeçalho contém class_names; cada caixa de deteção é [class, x, y, w, h]. Em falta no treino significa que o modelo não consegue aprender a classe e que o AP de validação será zero. Poucas instâncias na validação significa que o AP vai variar muito entre execuções: com 7 paletes na validação, uma palete não detetada altera o AP das paletes em cerca de 14 pontos. O COCO8 é um teste rápido com 8 imagens, por isso todas as classes falham; a tua versão de produção não deve apresentar avisos. Corrige as lacunas recolhendo mais exemplos, não ajustando os parâmetros.
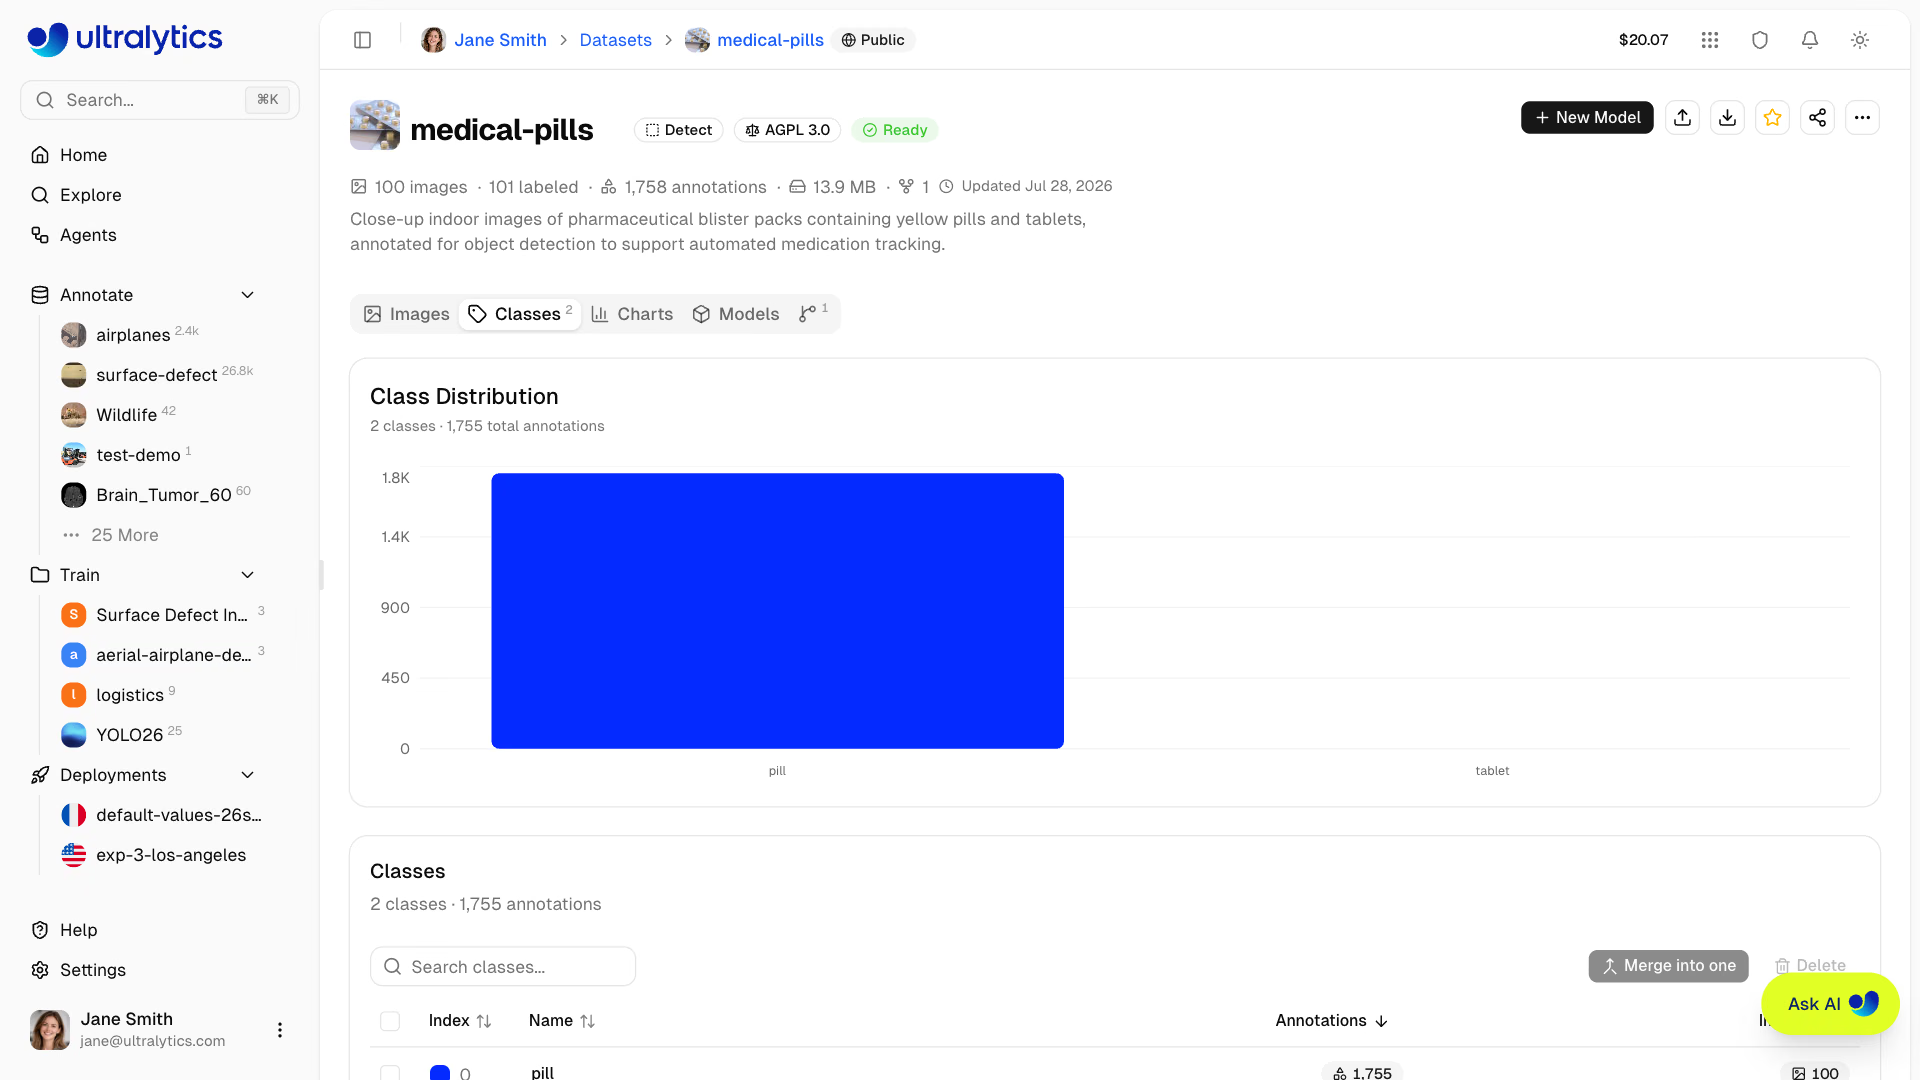
O separador Classes apresenta as mesmas contagens para o conjunto de dados ativo, com uma opção de escala logarítmica para dados desequilibrados. Combinar numa só agrega classes duplicadas, como car, automobile e vehicle, numa única classe sem perder anotações; Eliminar remove uma classe e todas as respetivas anotações.
Divide segundo a unidade em que pretendes generalizar#
Os fotogramas da mesma câmara, sessão ou dia estão correlacionados. Se aparecerem tanto no treino como na validação, o modelo é avaliado em cenas que já viu. Reserva unidades completas que variem em produção: se houver câmaras novas, reserva câmaras; se forem as mesmas câmaras em dias diferentes, reserva dias.
As ferramentas de divisão da Platform diferem exatamente neste aspeto:
| Ferramenta | Método de atribuição | Utilização |
|---|---|---|
Pastas train/, val/, test/ num carregamento | Mantém a atribuição existente | Divisões de grupos preparadas offline |
| Filtro de divisão definido antes do carregamento | Todos os ficheiros desse carregamento vão para a divisão selecionada | Carregamento de uma câmara por divisão |
| Mover para a divisão na vista de tabela | Move as imagens selecionadas | Corrigir imagens específicas |
| Barra de divisões, Redistribuir divisões | Reatribui aleatoriamente todas as imagens | Apenas fotografias independentes |

A lição Dividir corretamente o conjunto de dados aborda a escolha da unidade; em conjuntos de dados muito pequenos, a validação cruzada k-fold permite extrair mais informação. Para verificar os grupos depois do carregamento, adiciona uma chave de grupo à auditoria de classes (por exemplo, record["file"].split("_")[0] para ficheiros com nomes como cam07_000123.jpg, ou um campo camera nos metadados da imagem) e indica todos os grupos que aparecem em duas divisões.
Congela uma versão aprovada#
O treino exige uma captura fixa dos dados. No separador Versões, introduz uma descrição («v5: cam07 reservada, +80 imagens de paletes») e clica em Nova versão. Cada versão é uma captura NDJSON numerada e imutável que podes descarregar, comparar ou restaurar; a opção Guardar versão do conjunto de dados na caixa de diálogo de treino faz o mesmo no início do treino e reutiliza uma versão correspondente quando não há alterações. As versões não estão disponíveis para conjuntos de dados ligados à nuvem ou On Premise.
Armadilhas#
Sintoma: depois de clicar em Automático para dividir 80/20, o mAP de validação dispara, mas a precisão em produção não melhora. Solução: Redistribuir divisões reatribui aleatoriamente cada imagem (e remove duplicatas exatas no processo), colocando quadros consecutivos nos conjuntos de treino e validação. Use pastas de carregamento ou Mover para a divisão para dados agrupados.
Sintoma: uma exportação antiga ou as previsões de um modelo passam de repente a exibir nomes de classe incorretos. Solução: os IDs de classe são posicionais, então mesclar ou excluir uma classe desloca para baixo todos os índices seguintes. Crie uma versão antes de qualquer alteração de classe e treine novamente em vez de reutilizar arquivos de rótulos antigos.
Sintoma: uma nova execução tem uma pontuação 5 pontos menor, sem que mais nada tenha mudado. Solução: as métricas só são comparáveis quando usam a mesma divisão. Ao alterar a divisão, anote isso na descrição da versão e execute novamente a linha de base na nova versão antes de comparar qualquer coisa.
Mostrar solução
Exemplo de solução para um conjunto de dados de empilhadores com 8 câmaras. A verificação de duplicados encontra 41 imagens idênticas entre o treino e a validação, todas provenientes de uma pasta carregada novamente; elimina as cópias da validação. A auditoria, ampliada com group = record['file'].split('_')[0], mostra cam02 tanto no treino como na validação; seleciona as imagens de validação dessa câmara na vista de tabela e escolhe Mover para a divisão > Treino. Também assinala pallet: train 63, val 7, too few in val: usa Encontrar imagens semelhantes em duas imagens de paletes para adicionar 40 imagens semelhantes sem etiqueta, etiqueta-as e move 15 imagens de paletes da cam07 para a validação, para manter a cam07 inteira. Volta a executar as verificações: 0 duplicados, 0 grupos com fugas, 22 paletes na validação. O Agrupamento com cores por divisão não mostra grupos mistos. Guarda v5: cam07 val, cam08 test, +40 pallets.