Comparar execuções e escolher a vencedora
Compara execuções num projeto da Platform, regista o motivo de cada execução e decide se um candidato deve ser lançado através de um critério de promoção automatizado.
Os modelos maiores costumam vencer na métrica principal e depois falham numa classe que ninguém verificou. Sem uma regra definida antecipadamente, a execução lançada é simplesmente a que alguém preferiu. Nesta lição, registas cada execução para que possas consultar mais tarde o raciocínio por detrás dela, e transformas «é melhor?» num script de validação que devolve PASS ou FAIL.
Prático
Comparar execuções num projeto#
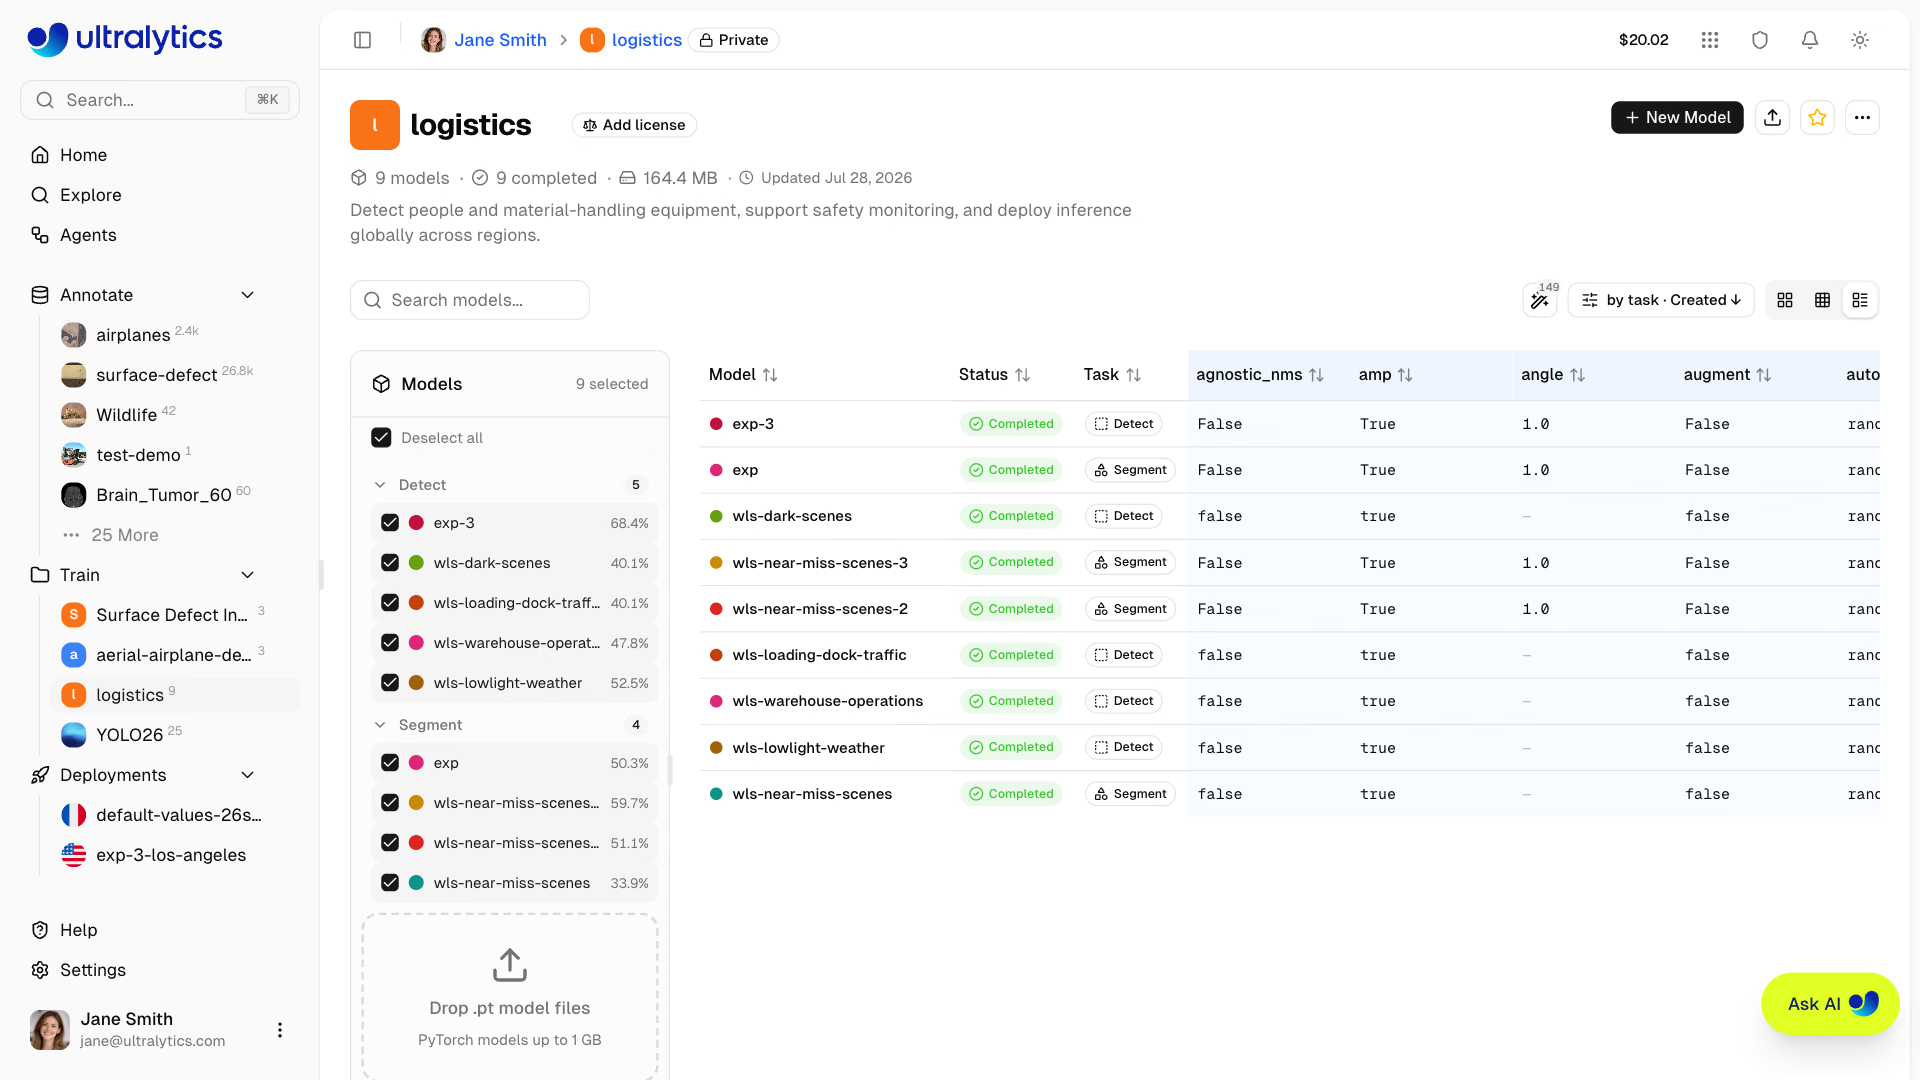
Um projeto lista os modelos com caixas de seleção. Os modelos selecionados são sobrepostos no painel Charts; a vista Table alinha os argumentos de treino e as métricas finais, e Diff oculta as colunas idênticas para veres de imediato que duas execuções diferem apenas em imgsz. A comparação funciona dentro de um único projeto, por isso mantém as experiências relacionadas juntas (podes recortar e colar modelos entre projetos). Ao interpretar as curvas, compara o valor final, a rapidez com que cada execução o atingiu e a suavidade do percurso.

Com dois ou mais modelos concluídos, Compare with AI pede ao Ask AI para resumir as diferenças e propor a próxima experiência. Trata a proposta como uma hipótese para a próxima execução, não como um veredito.
Torna cada execução explicável#
Os nomes transmitem o significado: run_5 não diz nada, mas v3_pallets_added e v4_imgsz1024 indicam a versão do conjunto de dados e o que mudou. Para registar o raciocínio, abre More actions > Information na página do modelo e guarda uma nota JSON como Custom Metadata:
{
  "hypothesis": "Pallet AP is low because val holds only 7 pallets",
  "change": "Dataset v3: +80 pallet images from cam03 and cam07; fine-tuned from v2",
  "result": "Pallet AP 0.31 -> 0.58, overall mAP50-95 0.51 -> 0.59",
  "next": "Forklift recall drops at night; collect dawn and dusk footage"
}
A Platform regista o resto: o cartão Run Information mostra a GPU, a tarifa horária, o custo total, a versão ultralytics, o anfitrião, o modelo de origem, a versão fixada do conjunto de dados, o commit do Git quando disponível e um comando yolo train que podes copiar. As comparações só são justas entre execuções com a mesma versão do conjunto de dados, por isso cada execução deve ter uma versão fixada.
Escolhe a métrica e define os critérios antes de veres os resultados#
| Métrica | Quando é a escolha certa |
|---|---|
| mAP50-95 | Predefinição para detect, segment, pose e OBB: recompensa caixas bem ajustadas e é suficientemente estável para permitir comparações |
| mAP50 | Objetos grandes e bem separados, nos quais o ajuste das caixas tem pouca importância |
| AP por classe para uma única classe | Uma classe determina o valor para o negócio |
| Recall com precisão fixa | Sistemas de segurança e alarmes |
| Latência de inferência no dispositivo de destino | Sempre, como limite rígido |
O guia de métricas de desempenho do YOLO explica cada métrica. Um candidato só é lançado se cumprir todos os critérios:
Exemplo prático: um script de critério de promoção#
Descarrega os ficheiros best.pt dos finalistas e avalia-os com dados idênticos e o mesmo código. Este exemplo usa dois checkpoints oficiais, por isso pode ser executado em qualquer ambiente:
from ultralytics import YOLO

DATA = "coco8.yaml"  # identical held-out data for both runs; use your test split for the final call
BASELINE, CANDIDATE = "yolo26n.pt", "yolo26s.pt"  # e.g. best.pt from two Platform runs
NOISE, CLASS_FLOOR, LATENCY_BUDGET_MS = 0.005, 0.90, 100.0

def evaluate(weights):
    m = YOLO(weights).val(data=DATA, plots=False, verbose=False)
    per_class = {m.names[int(c)]: ap for c, ap in zip(m.box.ap_class_index, m.box.ap)}
    return m.box.map, per_class, m.speed["inference"]

(base_map, base_ap, _), (cand_map, cand_ap, cand_ms) = evaluate(BASELINE), evaluate(CANDIDATE)
weak = [n for n, ap in base_ap.items() if cand_ap.get(n, 0) < CLASS_FLOOR * ap]
gates = {
    f"mAP50-95 {base_map:.3f} -> {cand_map:.3f} beats noise": cand_map - base_map > NOISE,
    f"every class keeps {CLASS_FLOOR:.0%} of its AP (weak: {', '.join(weak) or 'none'})": not weak,
    f"inference {cand_ms:.1f} ms within {LATENCY_BUDGET_MS:.0f} ms": cand_ms <= LATENCY_BUDGET_MS,
}
for name, ok in gates.items():
    print("PASS" if ok else "FAIL", name)
print("verdict:", "ship the candidate" if all(gates.values()) else "keep the baseline, run more experiments")
raise SystemExit(0 if all(gates.values()) else 1)  # non-zero exit blocks a CI release step
PASS mAP50-95 0.669 -> 0.693 beats noise
FAIL every class keeps 90% of its AP (weak: elephant, potted plant)
PASS inference 44.1 ms within 100 ms
verdict: keep the baseline, run more experimentsO que aconteceu: o modelo maior vence no resultado global por 2.4 pontos, mas duas classes perdem mais de 10% do respetivo AP, por isso falha. É esta regressão que uma comparação baseada apenas na métrica principal não revela. O dicionário por classe provém de ap_class_index e ap, que abrangem apenas as classes presentes nos dados; a latência é medida na máquina que executa o script, por isso executa o critério em hardware semelhante ao do teu ambiente de implementação. O COCO8 tem apenas 8 imagens de validação, muito poucas para uma decisão real. Usa um conjunto de dados de validação separado com pelo menos algumas centenas de imagens e fornece split="test" exatamente uma vez, para a decisão final.
Analisa as imagens com resultados fracos#
Nas execuções de deteção treinadas com uma versão guardada do conjunto de dados, a vista Validation inclui Validation insights: as imagens com melhor e pior desempenho, ordenadas pelo F1 por imagem e apresentadas com a verdade de referência; um explorador de características que correlaciona o F1 com o tamanho e a proporção das imagens e o número de instâncias; e as classes mais associadas às falhas. A opção Find similar nas imagens com pior desempenho adiciona imagens semelhantes ao conjunto de treino como imagens sem anotações, transformando um critério falhado numa tarefa de dados concreta.
Armadilhas#
Sintoma: o mAP de teste informado é ótimo, mas o desempenho em produção é pior. Solução: faça o ajuste usando a validação. Se você comparou dez execuções no conjunto de teste, ajustou o modelo com base nele e a pontuação está otimista. Avalie os finalistas no conjunto de teste uma única vez, no fim do processo.
Sintoma: uma execução 'vence' por 4 pontos, e ninguém consegue reproduzir o motivo. Solução: confira a versão fixada do conjunto de dados no cartão Run Information de cada execução. Se forem diferentes, execute novamente a linha de base na nova versão antes de comparar.
Sintoma: o vencedor muda toda vez que você treina novamente com uma nova semente. Solução: na maioria dos conjuntos de dados, diferenças inferiores a cerca de 0,5 ponto de mAP são ruído entre execuções. Mantenha o limite de ruído no critério e use um conjunto de validação maior quando os resultados estiverem tão próximos.
Mostrar solução
Exemplo de resposta para o modelo de pílulas: modelo de referência v1-baseline (10 épocas) contra o candidato v2-finetune (mais 5 épocas, SGD, lr0 0.001). Define DATA = "medical-pills.yaml" e os dois pesos em gate.py. Resultado: PASS mAP50-95 0.659 -> 0.687 beats noise, PASS every class keeps 90% of its AP (weak: none), PASS inference 4.0 ms within 100 ms; veredito «lançar o candidato». Custom Metadata na v2: hipótese «a v1 ainda estava a melhorar na época 10», alteração «ajuste fino de 5 épocas, SGD lr0 0.001», resultado «mAP50-95 0.659 -> 0.687». Nota a incluir nos metadados: os dados de validação medical-pills também orientaram o treino, por isso confirma o resultado com um conjunto de validação separado antes da produção.