Divida o conjunto de dados corretamente
Meça o vazamento causado por divisões aleatórias, divida grupos inteiros, como clipes, câmeras ou dias, com um script, verifique a cobertura das classes e bloqueie o conjunto de teste.
Uma divisão descuidada produz uma métrica em que você confia, mas que não é verdadeira. Quando quadros de vídeo adjacentes ficam tanto no treino quanto na validação, o mAP de validação mede memorização em vez de generalização, e a diferença só aparece em produção. Todo número que você informa sobre o modelo depende dessa divisão, então escolha-a deliberadamente uma vez e mantenha-a fixa.
Prático
Três divisões, três funções#
| Divisão | Proporção típica | Função |
|---|---|---|
| Treino | 70% | O modelo aprende seus pesos com esses dados |
| Validação | 15% | Escolher a melhor época, comparar execuções e ajustar configurações |
| Teste | 15% | Uma decisão final de aprovação ou reprovação com base no teste de aceitação |
Os guias da Ultralytics recomendam 70–80% para treino e 10–20% para cada uma das divisões de validação e teste: etapas de um projeto de CV sugerem 10–15% para cada uma, e o guia de pré-processamento usa 70/20/10. Conte as proporções em objetos também, além das imagens, pois uma imagem cheia pode conter mais rótulos do que dez imagens com poucos objetos. As porcentagens exatas importam muito menos do que o uso de cada divisão.
Divisões aleatórias causam vazamento em dados correlacionados#
Os quadros 124 e 125 do mesmo clipe são quase idênticos. Se um for para o treino e o outro para a validação, o modelo será avaliado com imagens que, na prática, já viu. Meça isso no conjunto de prática de Colete dados representativos de alta qualidade, cujos nomes de arquivo começam com uma chave de grupo câmera-dia:
import random
from pathlib import Path

images = sorted(Path("datasets/practice/images").glob("*.jpg"))
random.Random(0).shuffle(images)
train, val = images[:90], images[90:109]  # a random per-image 70/15 split

def group(image):
    return image.stem.rsplit("_", 1)[0]

shared = {group(p) for p in train} & {group(p) for p in val}
print(f"{len(shared)} of {len({group(p) for p in val})} val groups also appear in train")
13 of 13 val groups also appear in trainCada grupo câmera-dia da validação também aparece no treino. Em imagens reais, isso significa que os quadros de validação compartilham iluminação, plano de fundo e, muitas vezes, os mesmos objetos exatos que os quadros de treino. Assim, o mAP de validação parece ótimo, mas o mAP em produção não.
Escolha a unidade de divisão#
Escolha o grupo que corresponde à generalização exigida pela implantação:
Em caso de dúvida, divida pela unidade mais geral que puder: ela fornece o resultado mais confiável. Divisões aleatórias por imagem só são seguras quando cada imagem é uma captura independente, como fotos de produtos tiradas com semanas de intervalo.
Divida por grupo no código#
Este script atribui grupos inteiros às divisões até que cada uma atinja sua proporção de 70/15/15, grava as listas de arquivos aceitas por um YAML de dados e informa a cobertura das classes:
import random
from collections import Counter, defaultdict
from pathlib import Path

root = Path("datasets/practice")  # contains images/ and labels/

def group(image):
    return image.stem.rsplit("_", 1)[0]  # "cam2_2026-05-01_000124" -> "cam2_2026-05-01"

groups = defaultdict(list)
for image in sorted((root / "images").glob("*.jpg")):
    groups[group(image)].append(image)

keys = sorted(groups)
random.Random(0).shuffle(keys)  # fixed seed: the same split on every run
total, assigned = sum(len(v) for v in groups.values()), 0
splits = {"train": [], "val": [], "test": []}
for key in keys:  # assign whole groups until each split reaches its 70/15/15 share
    share = assigned / total
    splits["train" if share < 0.70 else "val" if share < 0.85 else "test"] += groups[key]
    assigned += len(groups[key])

counts = {}
for split, images in splits.items():
    (root / f"{split}.txt").write_text("".join(f"./images/{p.name}\n" for p in images))
    labels = [root / "labels" / f"{p.stem}.txt" for p in images]
    counts[split] = Counter(int(r.split()[0]) for f in labels if f.exists() for r in f.read_text().splitlines() if r.strip())

all_classes = set().union(*counts.values())
for split, images in splits.items():
    missing = len(all_classes - set(counts[split]))
    print(f"{split:>5}: {len(images):3d} images, {len({group(p) for p in images}):2d} groups, {missing} of {len(all_classes)} classes missing")
train: 90 images, 11 groups, 5 of 71 classes missing
val: 20 images, 2 groups, 36 of 71 classes missing
test: 18 images, 3 groups, 41 of 71 classes missingComo interpretar o resultado:
- Nenhum grupo cruza uma divisão, por construção. Assim, o vazamento é eliminado.
- A validação contém 2 grupos e não inclui 36 classes, portanto não é possível medir o AP dessas classes. Com 71 classes em 128 imagens, nenhuma semente resolve isso; a solução real é obter mais grupos (mais câmeras ou dias), como ocorre em um conjunto de dados de produção com mais de 1.500 imagens por classe.
- Faltam 5 classes no treino, que aparecem apenas na validação ou no teste. O modelo não pode aprendê-las com essa divisão.
A regra de decisão: quando uma classe está ausente de uma divisão, adicione ou mova grupos inteiros que a contenham, nunca quadros individuais, pois isso reintroduziria o vazamento. Aponte as chaves train, val e test do YAML de dados para os três arquivos .txt; Escreva um YAML de conjunto de dados explica o restante do arquivo.
Equilibre as classes entre as divisões#
Para classificação, o train_test_split(..., stratify=labels) do scikit-learn mantém as proporções das classes iguais entre as divisões com um único argumento. Imagens de detecção contêm várias classes ao mesmo tempo, então faça o equilíbrio no nível dos grupos: após group_split.py, compare as contagens por classe entre as divisões e troque grupos inteiros até que cada classe fique dentro de aproximadamente ±20% da proporção esperada.

Na Ultralytics Platform, Redistribute Splits reatribui imagens aleatoriamente, e Auto define a divisão recomendada de 80/20 entre treino e validação (documentação sobre divisões). A ferramenta remove imagens duplicadas exatas durante o processo, mas não identifica seus grupos. Portanto, use-a para capturas independentes e envie divisões agrupadas para dados de vídeo ou de várias câmeras.
Acompanhe separadamente dois conjuntos de validação#
Em geral, você vai querer dois conjuntos de validação: um conjunto de regressão estável e selecionado manualmente e outro realista para produção, que muda à medida que novos quadros são coletados. O YAML de dados aceita uma lista de pastas de validação, mas as combina em um único conjunto de validação com uma única pontuação:
path: ./datasets/forklift
train: images/train
val:
  - images/val_curated      # stable, your regression suite
  - images/val_production   # rotates with newly collected frames
test: images/test
Para ver cada pontuação, mantenha um YAML de dados por conjunto de validação (os mesmos train e names, mas um val diferente) e valide os pesos treinados com cada conjunto:
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")  # your fine-tuned checkpoint
for data in ("val_curated.yaml", "val_production.yaml"):
    metrics = model.val(data=data)
    print(f"{data:<20} mAP50-95={metrics.box.map:.3f}")
Uma queda no conjunto selecionado indica uma regressão; uma queda no conjunto de produção indica mudança de domínio.
Bloqueie o conjunto de teste#
O erro de divisão mais caro é comparar dez variantes do modelo no conjunto de teste. Depois que o teste influencia qualquer decisão, o número final fica otimista. Faça todos os ajustes e compare as execuções na validação; execute o teste de aceitação no conjunto de teste apenas uma vez, no final.
Toda métrica que você publica está vinculada a esta divisão. Embaralhar de novo mais tarde altera todos os números e torna incomparáveis as execuções antigas e novas. Mantenha a unidade de divisão, a semente e as três listas de arquivos junto com o conjunto de dados.
Validação cruzada K-fold para conjuntos de dados pequenos#
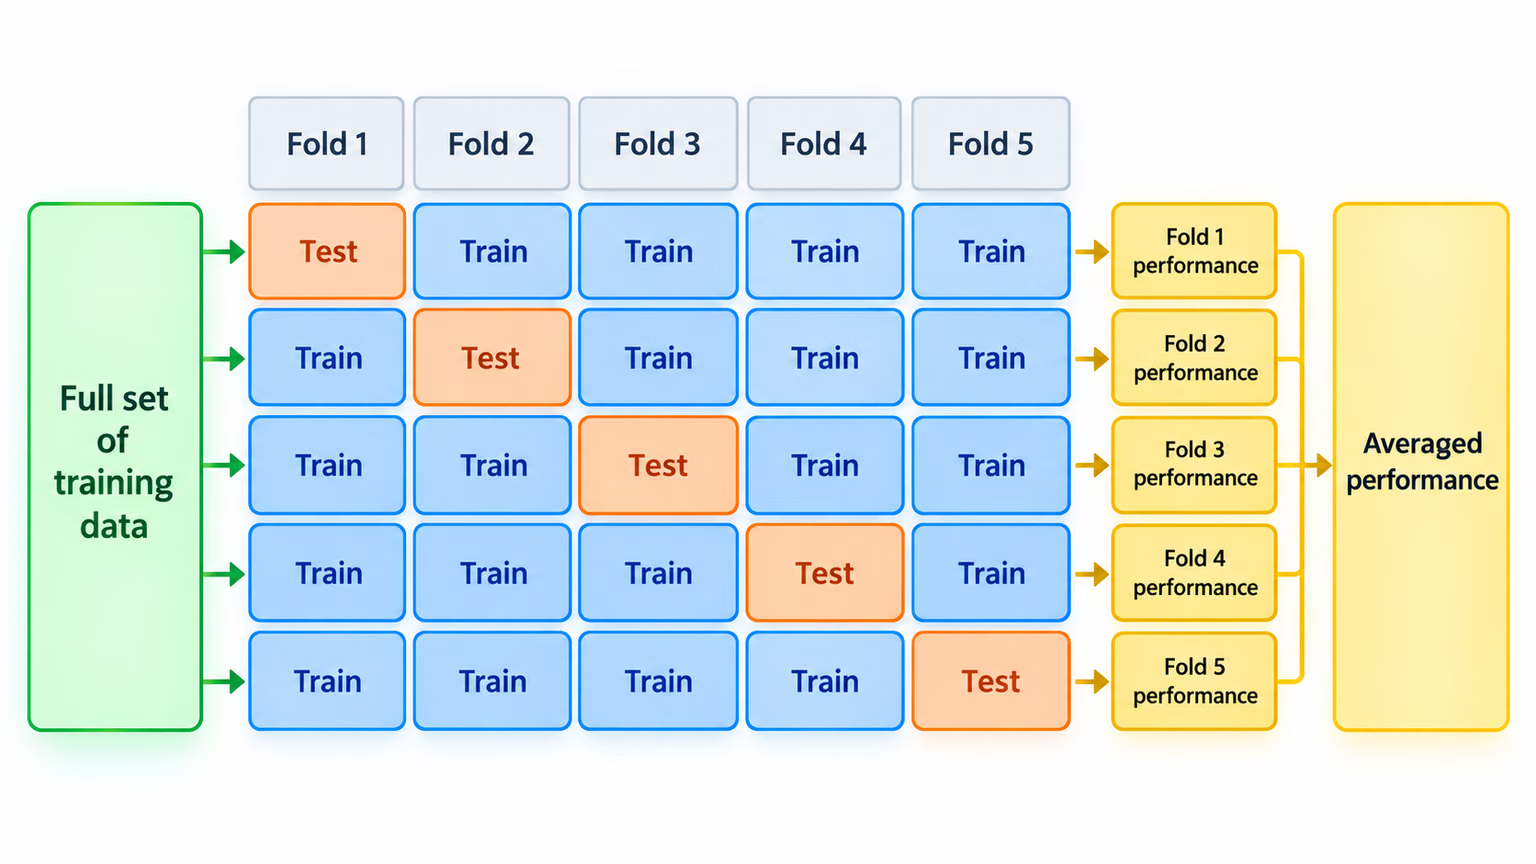
Quando o conjunto de dados é pequeno (menos de aproximadamente 500 imagens por classe) e uma única divisão parece estatisticamente frágil, a validação cruzada K-fold treina k modelos em divisões rotativas e calcula a média dos resultados: k vezes mais computação para uma estimativa muito mais estável. Crie os folds a partir de grupos da mesma forma, ou haverá vazamento em cada fold.
Mostrar solução
Para câmeras fixas de armazém que precisam continuar funcionando em dias novos, divida por câmera-dia: cam2_2026-05-01. Depois de group_split.py, verifique se nenhum grupo cruza o limite entre divisões:
from pathlib import Path

root = Path("datasets/practice")
groups = {s: {Path(p).stem.rsplit("_", 1)[0] for p in (root / f"{s}.txt").read_text().split()} for s in ("train", "val", "test")}
print("train & val: ", groups["train"] & groups["val"] or "none")
print("train & test:", groups["train"] & groups["test"] or "none")
print("val & test:  ", groups["val"] & groups["test"] or "none")
train & val: none
train & test: none
val & test: noneA divisão de prática passa na verificação de vazamento, mas falha na verificação de cobertura: faltam 36 das 71 classes na validação. A solução é um plano de coleta, não uma nova divisão. Capture pelo menos mais dois grupos câmera-dia para validação e teste, cada um cobrindo as classes mais importantes para a especificação, e execute os dois scripts novamente.