Boas práticas de anotação
Escreve um guia de anotação, escolhe uma ferramenta, evita os dez erros que prejudicam a precisão sem dar nas vistas e mede a concordância entre anotadores com um script antes de expandir o processo.
A qualidade das etiquetas limita a qualidade do modelo. Dez anotadores que interpretam «palete» de formas ligeiramente diferentes produzem um conjunto de dados que ensina as dez interpretações ao mesmo tempo, e nenhum volume de treino resolve a contradição. Um guia escrito, uma ronda de calibração com resultados medidos e uma lista curta de erros conhecidos mantêm as etiquetas consistentes, quer uma pessoa anote 500 imagens, quer uma equipa anote 50 000.
Prático
Escolhe a ferramenta de anotação#
A ferramenta certa depende da tarefa, da equipa e do local onde o treino ocorre:
| Ferramenta | Ideal para | Notas |
|---|---|---|
| Ultralytics Platform | Todas as sete tarefas YOLO: um editor para caixas, polígonos, máscaras semânticas, pontos-chave, caixas rodadas e classes de imagem, além de mapas de profundidade carregados; anotação inteligente com SAM | Etiquetas, gráficos do conjunto de dados e treino num só lugar; sem necessidade de exportação |
| CVAT | Equipas grandes, vídeo e fluxos de revisão complexos | Autoalojado ou na nuvem |
| Label Studio | Projetos multimodais (imagem + texto + áudio) | Configuração flexível, curva de aprendizagem mais acentuada |
| Labelme | Anotação de polígonos para equipas pequenas | Aplicação de ambiente de trabalho simples |
| LabelImg | Protótipos rápidos apenas com caixas | Leve; o repositório foi arquivado |
Na Ultralytics Platform, a anotação inteligente com SAM 2.1, SAM 3 e SAM 3.1 funciona em conjuntos de dados de deteção, segmentação, segmentação semântica e OBB. Seja qual for a tua escolha, confirma que exporta no formato YOLO necessário para a tua tarefa; Preparar um conjunto de dados personalizado explica o formato das etiquetas e a conversão.
Os sete tipos de etiqueta#

| Tipo de etiqueta | O que desenhas | Tarefa |
|---|---|---|
| Etiqueta de classe | Um rótulo por imagem | Classificação |
| Caixa delimitadora | Retângulo alinhado com os eixos para cada objeto | Deteção |
| Polígono | Contorno de cada instância de objeto | Segmentação de instâncias |
| Máscara densa | Uma classe para cada pixel | Segmentação semântica |
| Pontos-chave | Pontos identificados por nome, como articulações | Pose |
| Caixa orientada | Retângulo rodado para cada objeto | OBB |
| Mapa de profundidade | Nada: um mapa de distâncias por píxel obtido por um sensor de profundidade e associado a cada imagem | Estimativa de profundidade |
Escreve primeiro o guia de anotação#
Antes de alguém desenhar uma caixa, escreve um guia com cinco secções:
- Definições das classes: um parágrafo por classe, com exemplos positivos, elementos semelhantes que não pertencem à classe e casos-limite.
- Regras de desenho: caixas ajustadas ao objeto visível; polígonos que acompanham o contorno visível.
- Regras de oclusão e dimensão: um limiar para objetos parcialmente visíveis («anota se conseguires identificar a classe») e outro para objetos pequenos («anota pessoas com mais de 10 píxeis de altura»), aplicados em todos os casos.
- Registo de casos ambíguos: cada pergunta do tipo «e este caso?» com a resposta acordada e uma captura de ecrã.
- O que ignorar: tudo o que não vale a pena anotar para esta tarefa.
Uma ou duas páginas com capturas de ecrã são suficientes. Depois, o guia orienta um ciclo curto que deve ocorrer antes de expandir a anotação:
Rotule todos os objetos relevantes em todas as imagens. Uma empilhadeira sem rótulo ensina o modelo que empilhadeiras às vezes são fundo, e ele aprende a não detectá-las. Um conjunto de dados parcialmente rotulado parece idêntico a um conjunto menor totalmente rotulado até você iniciar o treinamento. Termine cada imagem antes de passar à próxima.
Dez erros que prejudicam a precisão#
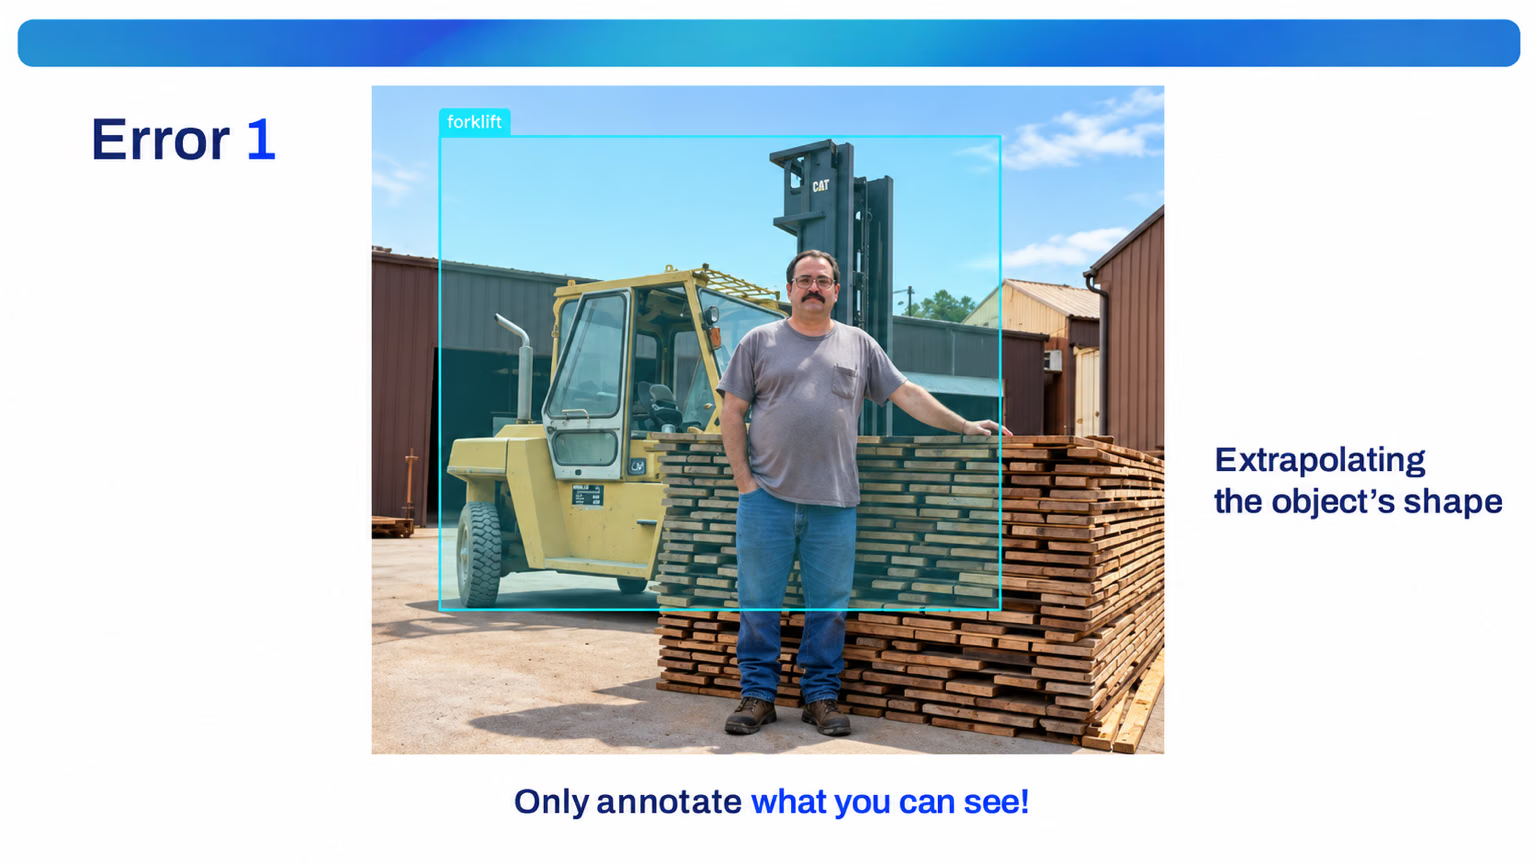
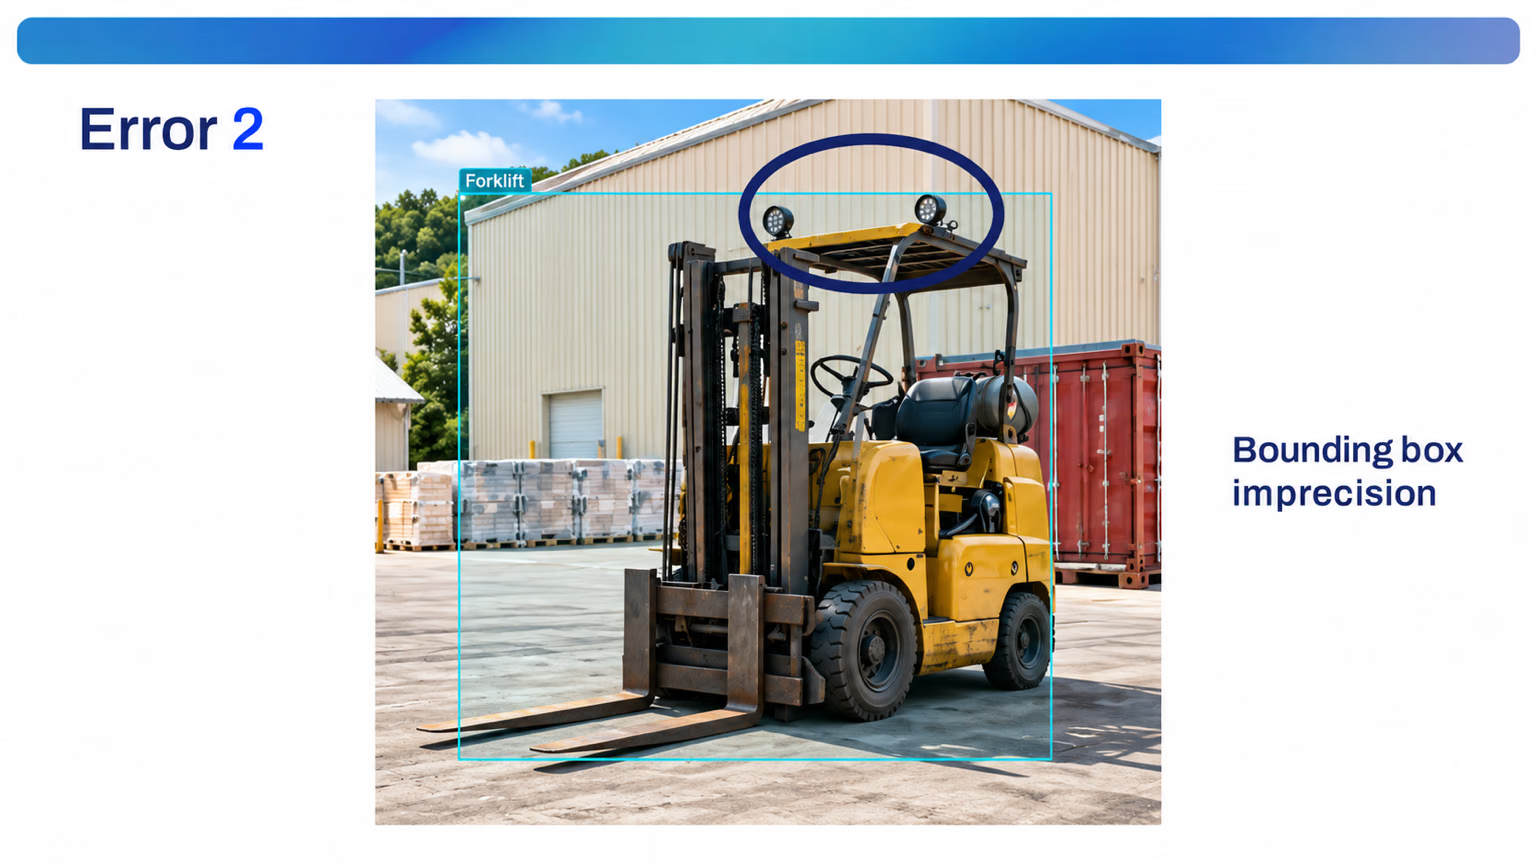
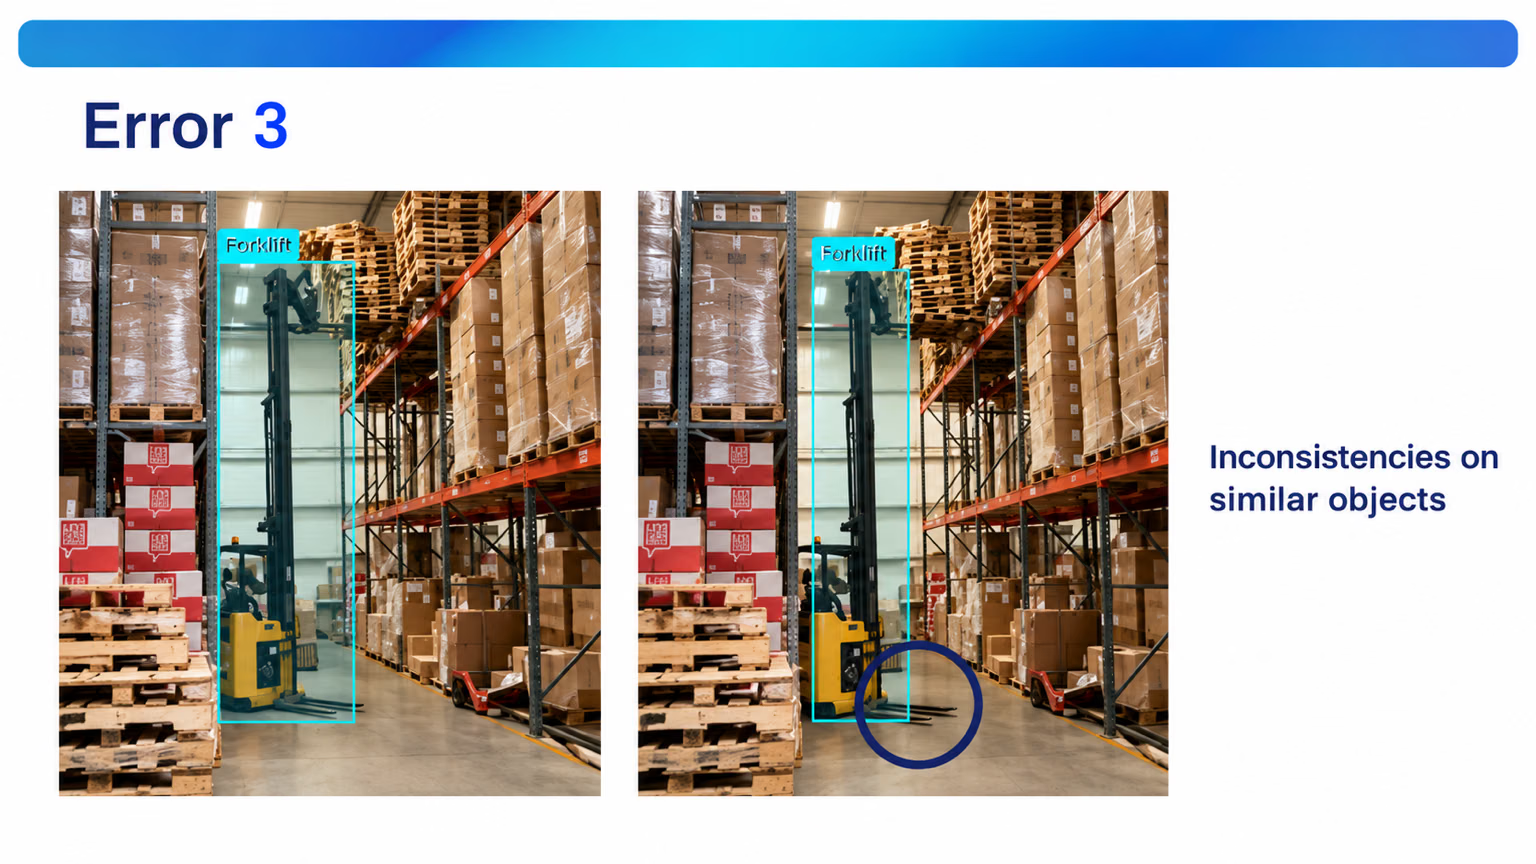
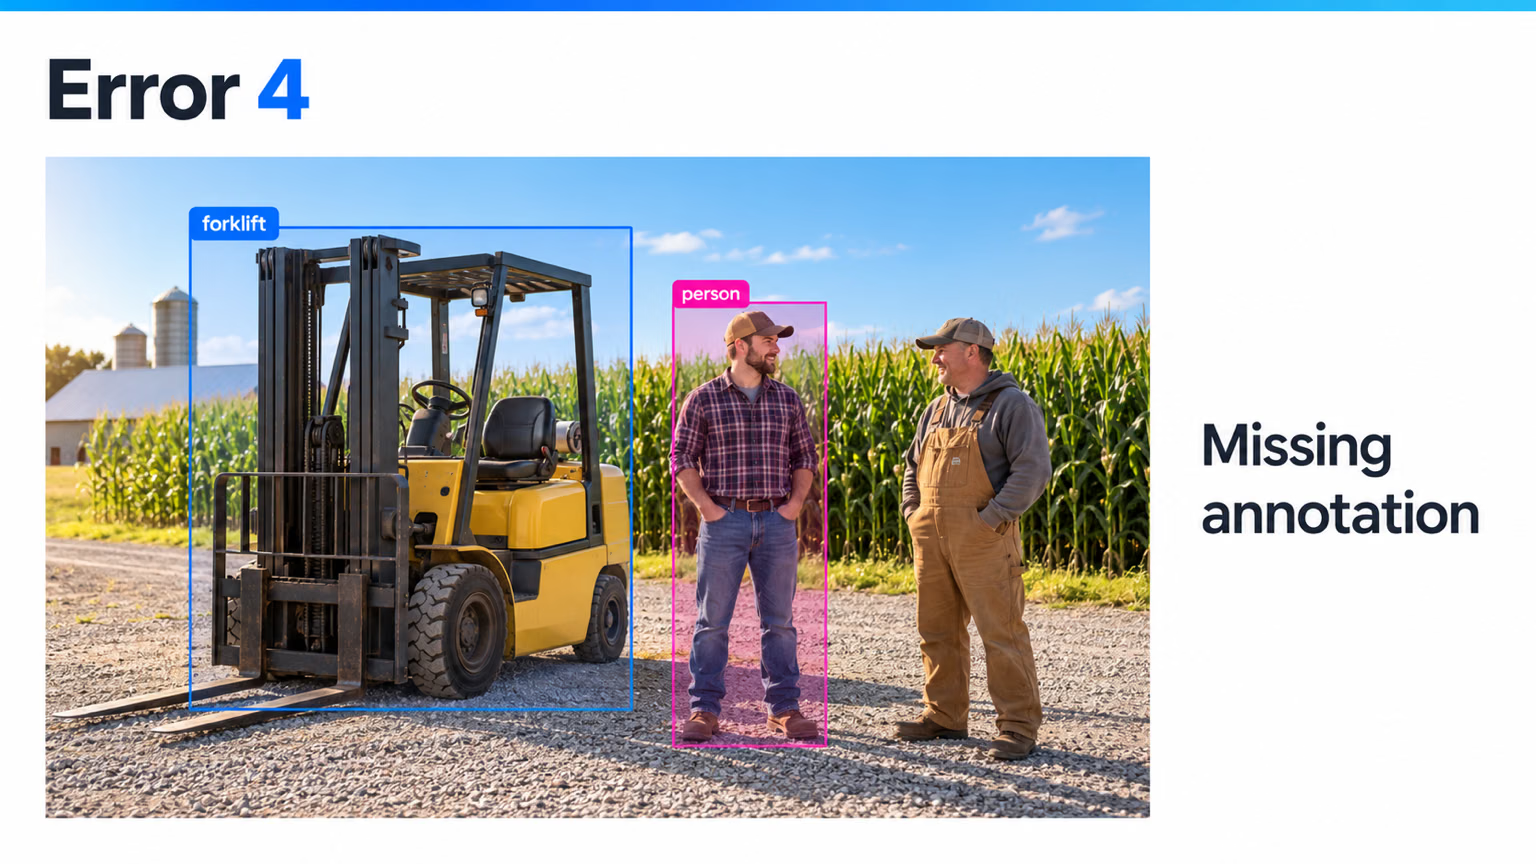
Os erros que a equipa de anotação da Ultralytics encontra com mais frequência, ilustrados com imagens de empilhadores, pessoas e paletes (adaptado de uma apresentação de Alexis Schutzger). Usa-os como as primeiras entradas do teu guia.
1. Extrapolar a forma do objeto. Anota apenas o que consegues ver. Neste caso, o empilhador está atrás de uma pessoa e de uma pilha de madeira, mas a caixa atravessa ambos até ao ponto onde o anotador imaginou que terminava o resto do veículo. Delimita apenas a parte visível.
2. Caixas imprecisas. As caixas têm de acompanhar de perto o objeto. Esta corta as luzes do tejadilho de proteção; uma caixa que corta parte do objeto ou deixa uma margem de chão ensina uma extensão incorreta.
3. Convenções inconsistentes para objetos semelhantes. A caixa da esquerda inclui os garfos; a da direita deixa-os de fora. O modelo recebe duas respostas para a mesma pergunta, por isso define a convenção por escrito: incluir os garfos ou excluí-los.
4. Anotações em falta. Duas pessoas estão ao lado do empilhador, mas apenas uma está delimitada. A que não foi anotada acaba por ensinar que «as pessoas são fundo».
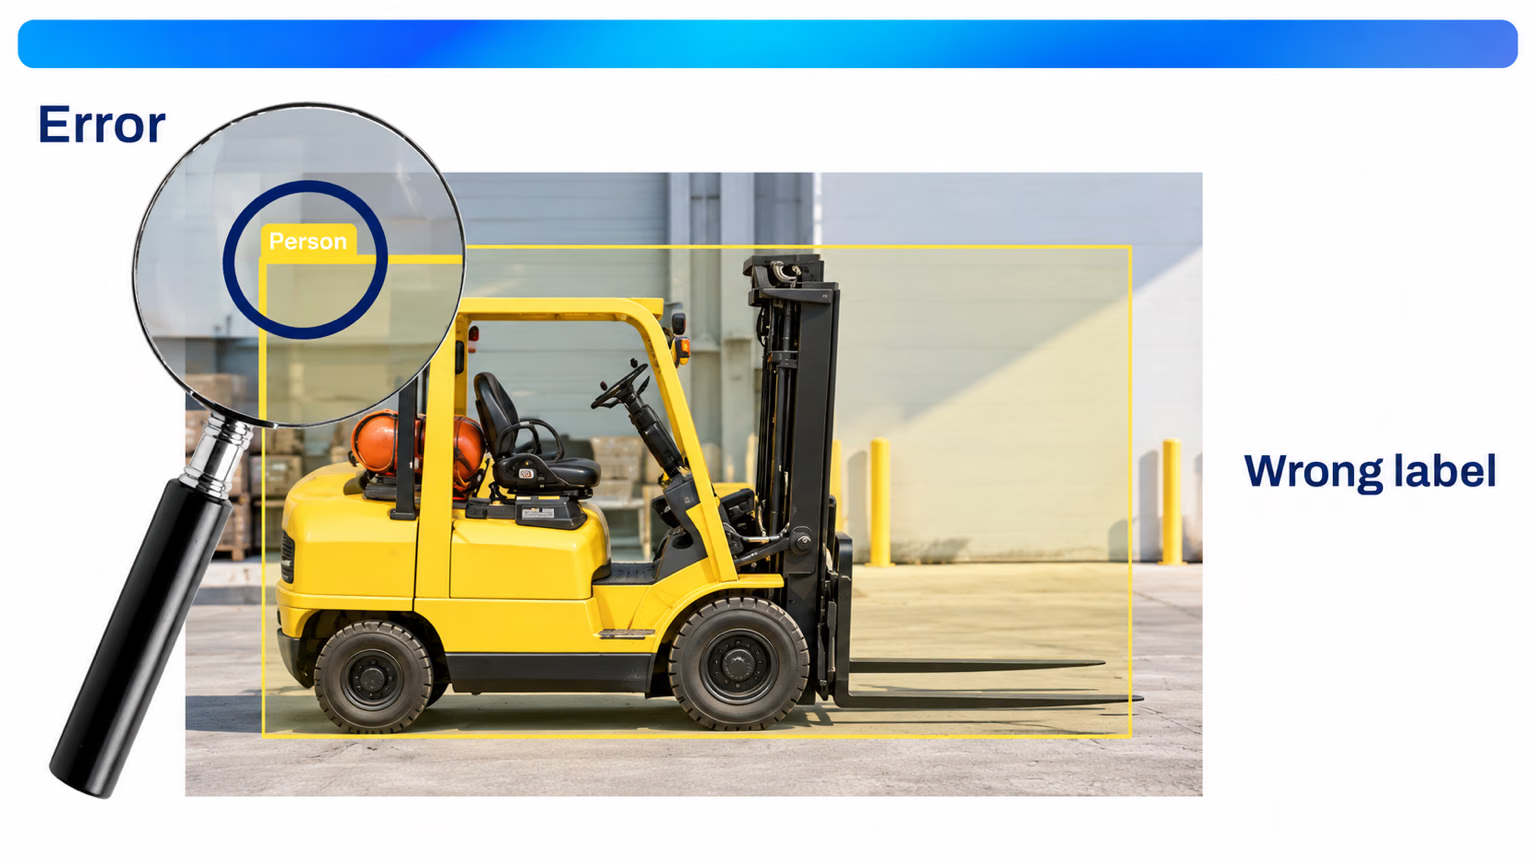
5. Classe errada. Verifica a classe, não apenas a caixa. Uma caixa correta em torno de uma empilhadeira marcada como person corrompe ambas as classes, geralmente por um deslize ao usar um atalho de teclado.
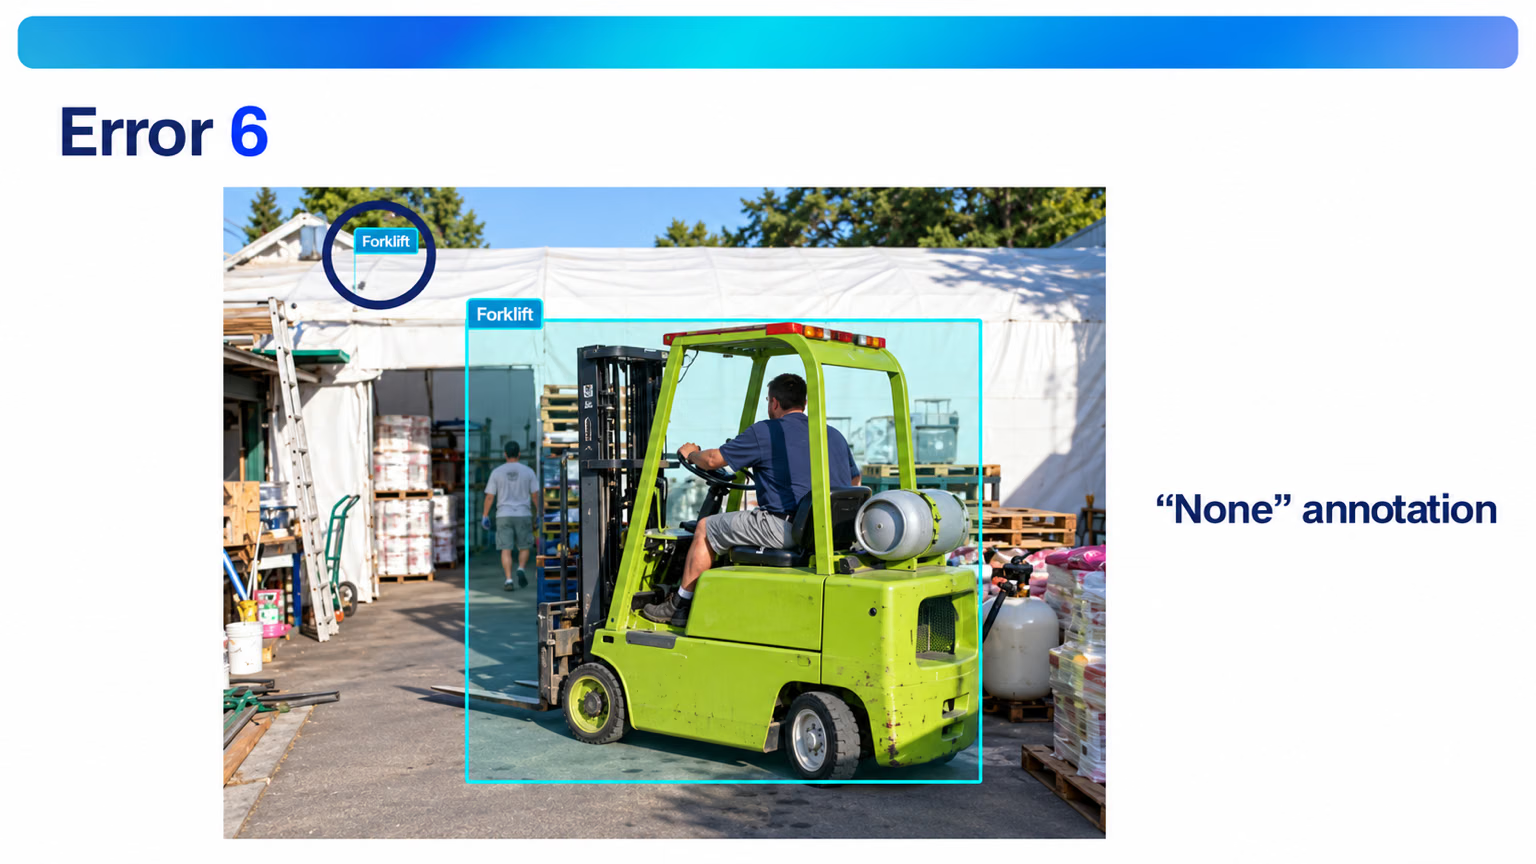
6. Anotações vazias ou perdidas. Cada anotação precisa corresponder a um objeto real e a uma classe real. Um clique perdido deixa uma caixa quase vazia, como a que aparece aqui no canto; uma caixa salva sem classe pode ser exportada como None ou classe 0. Corrige-as ou elimina-as.
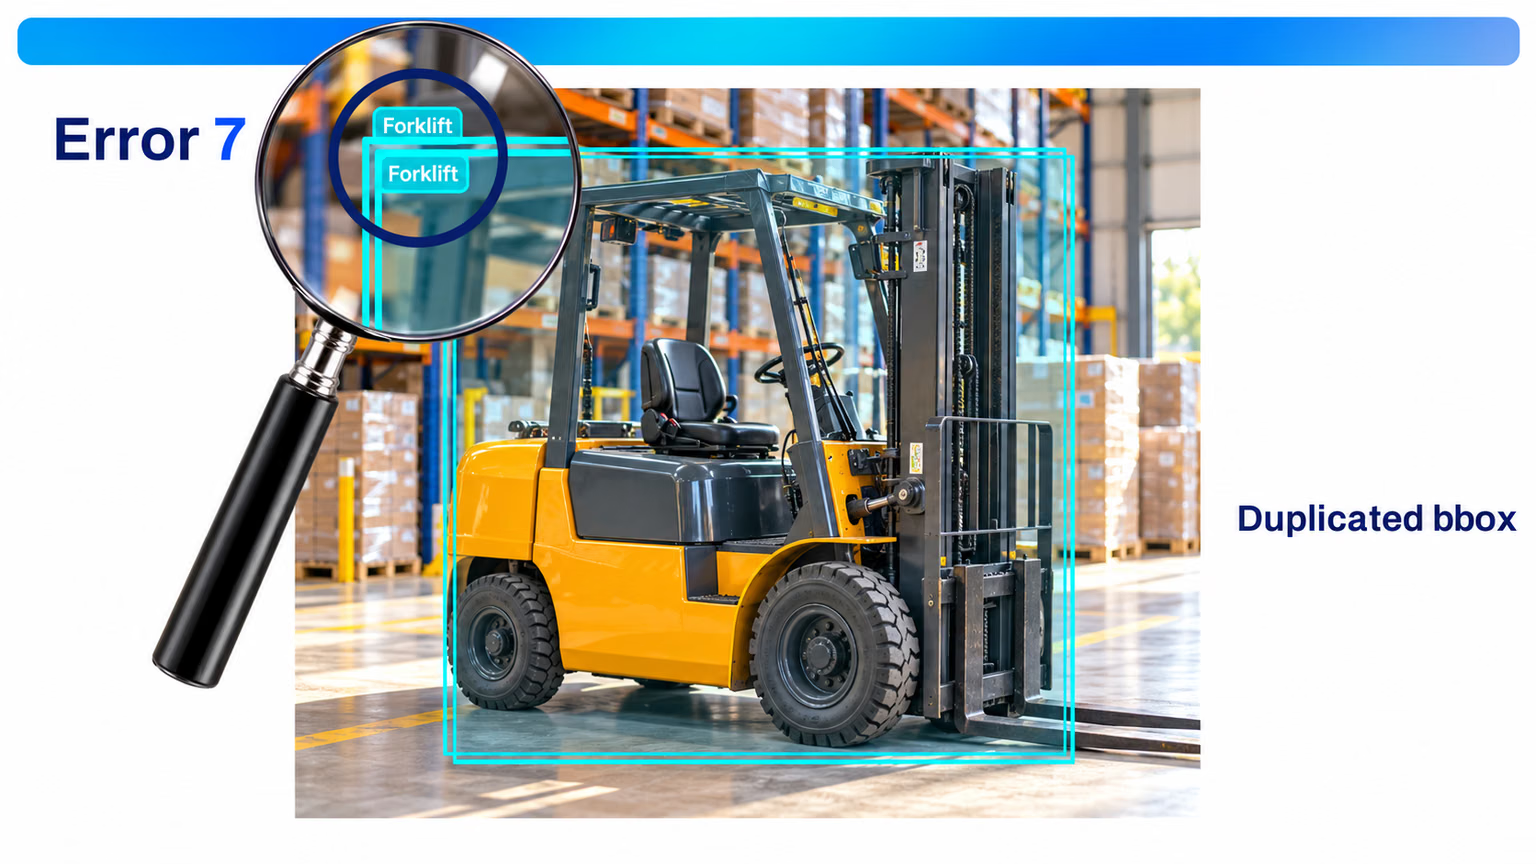
7. Caixas duplicadas. Um objeto, uma caixa. Duas caixas sobrepostas na mesma empilhadeira aumentam artificialmente a contagem de instâncias e ensinam o modelo a prever duplicatas.
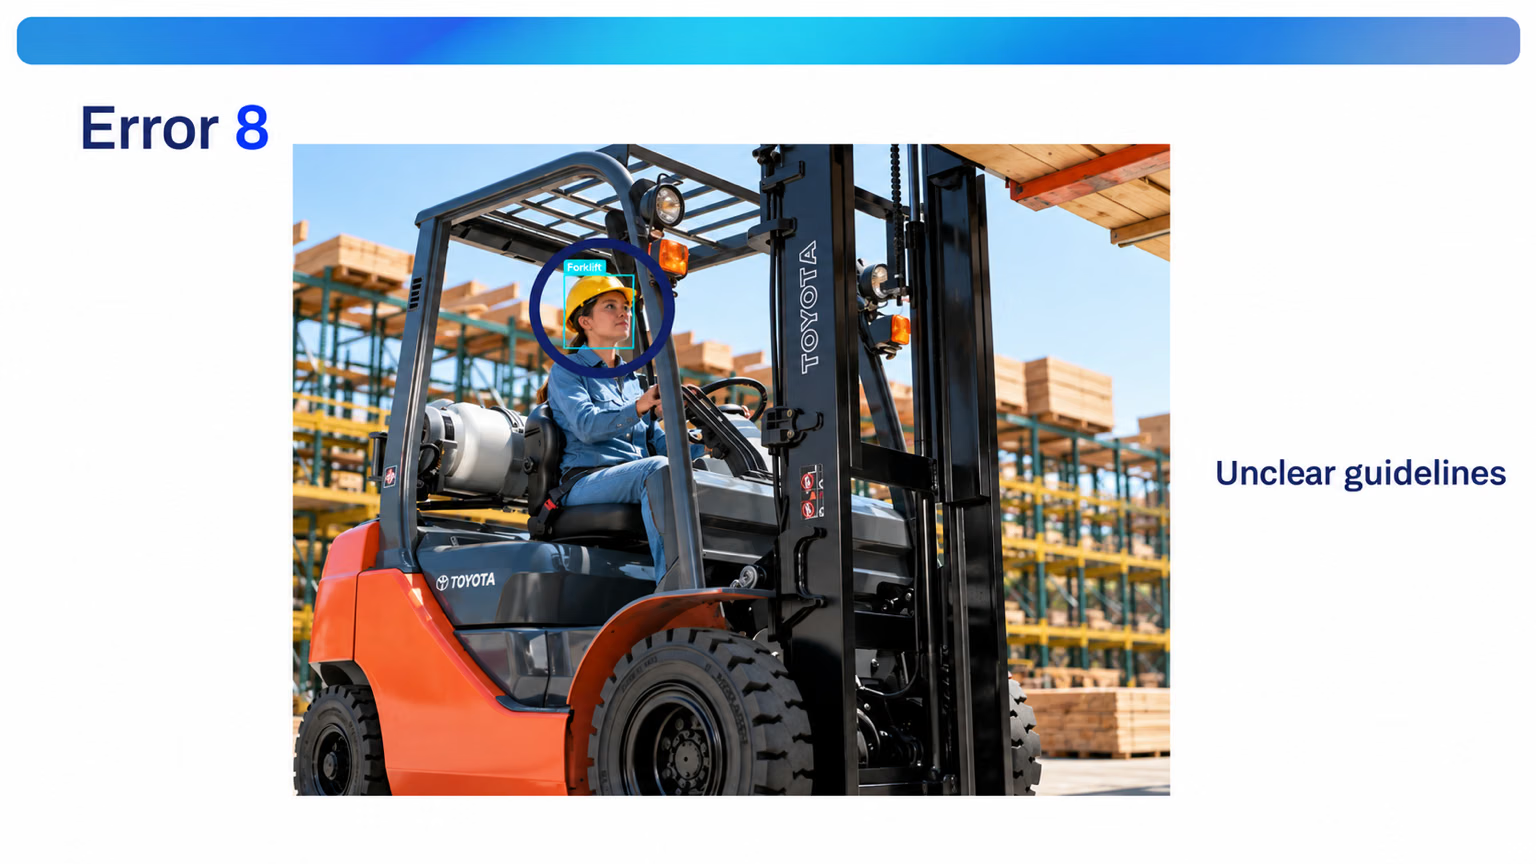
8. Diretrizes pouco claras. Sem uma regra escrita, quem anota improvisa: neste caso, alguém delimitou apenas a cabeça do motorista e atribuiu-lhe a classe forklift. O motorista faz parte da empilhadeira ou é um person separado? Responde a essa pergunta uma vez, no guia.
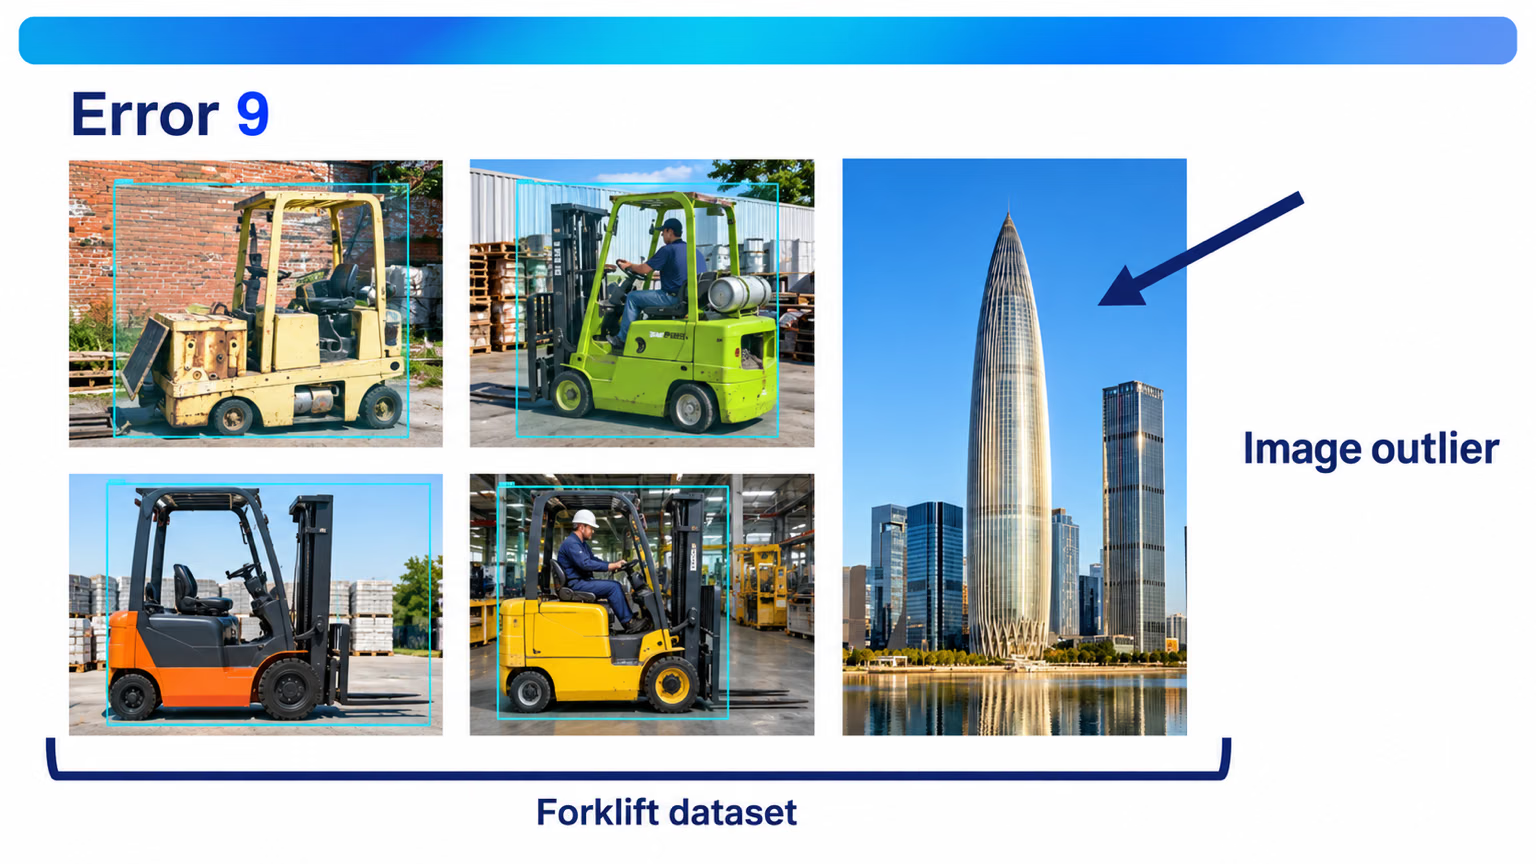
9. Imagens atípicas. Exclui imagens que não correspondam ao ambiente de implantação. Uma foto do horizonte de uma cidade num conjunto de dados de empilhadeiras não ensina nada útil e dilui o restante.
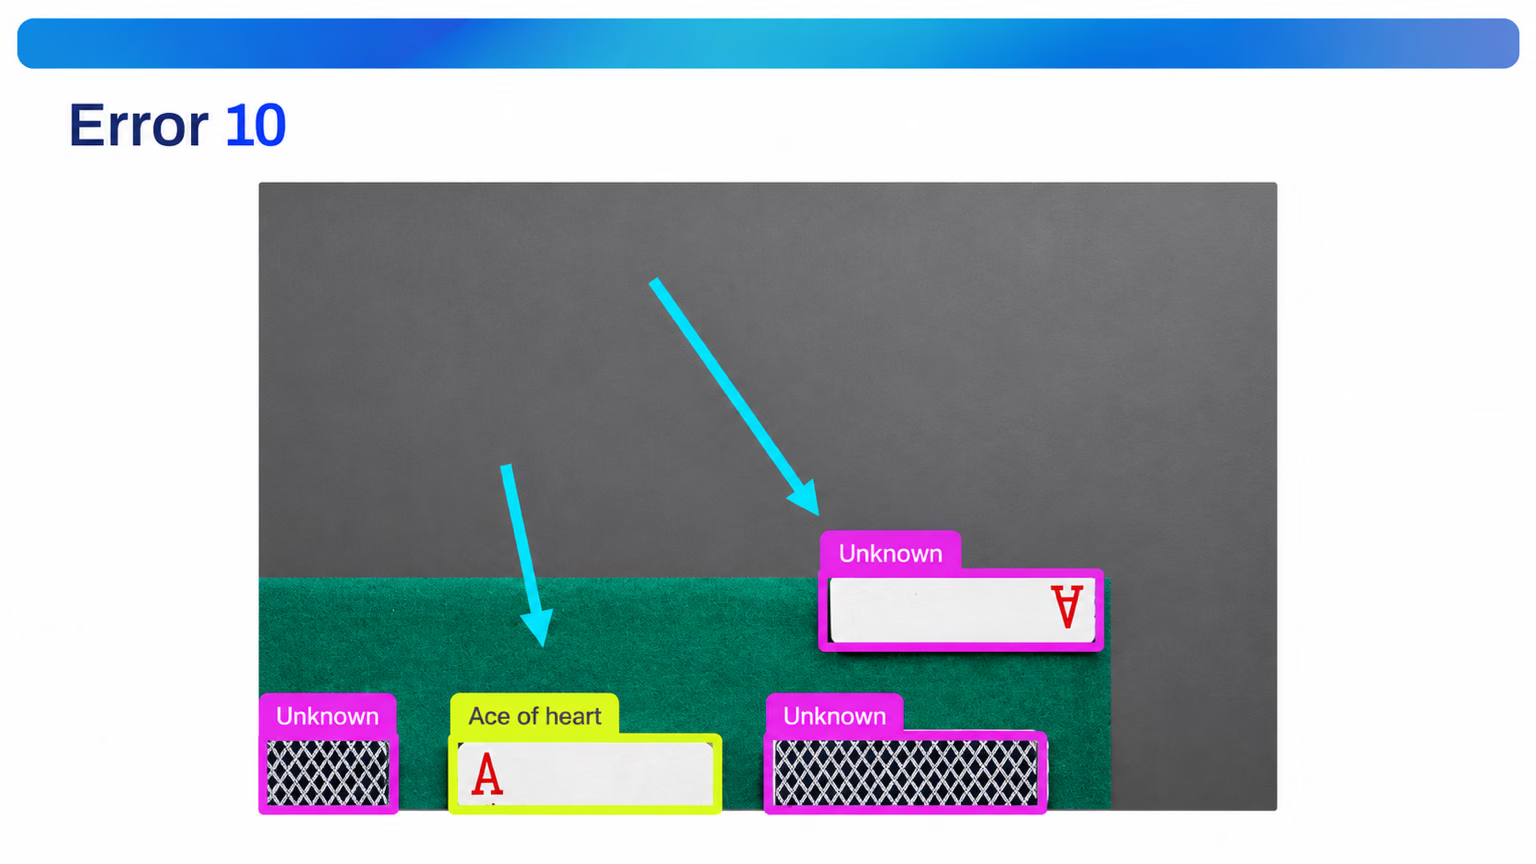
10. Ambiguidade causada por aumento de dados. Quando um recorte pode remover a característica que define uma classe, duas classes tornam-se idênticas. Recorta o símbolo do canto de um ás de copas e ele fica parecido com as cartas rotuladas unknown. Usa o aumento de dados com cuidado explica como corrigir isso.
Mede a concordância, não a adivinhes#
Uma rodada de calibração fornece as mesmas imagens a duas pessoas que anotam e compara os rótulos objeto por objeto. Dois rótulos concordam quando têm a mesma classe e uma sobreposição com IoU de pelo menos 0,5. Este script calcula a pontuação nas imagens de validação de COCO8. Para executá-lo sem uma segunda pessoa, um modelo pré-treinado faz o papel da pessoa B; com uma equipa real, lê as caixas de B nos ficheiros de rótulos dessa pessoa:
from pathlib import Path

import torch

from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset, img2label_paths
from ultralytics.utils.metrics import box_iou
from ultralytics.utils.ops import xywh2xyxy

data = check_det_dataset("coco8.yaml")
model = YOLO("yolo26n.pt")  # stands in for a second annotator; compare two label folders the same way
names = data["names"]

matched = total = 0
for image in sorted(Path(data["val"]).glob("*.jpg")):
    rows = [r.split() for r in Path(img2label_paths([str(image)])[0]).read_text().splitlines() if r.strip()]
    a_cls = torch.tensor([int(r[0]) for r in rows])  # annotator A: the dataset labels
    a_box = xywh2xyxy(torch.tensor([[float(v) for v in r[1:]] for r in rows]))
    b = model(image, conf=0.5, verbose=False)[0].boxes  # annotator B: confident model proposals
    iou = box_iou(a_box, b.xyxyn)
    used = set()
    for i in range(len(rows)):  # pair each A object with the best unused same-class B box at IoU >= 0.5
        ok = [j for j in range(len(b)) if j not in used and b.cls[j] == a_cls[i] and iou[i, j] >= 0.5]
        if ok:
            used.add(max(ok, key=lambda j: iou[i, j]))
        else:
            print(f"{image.name}: {names[int(a_cls[i])]} labeled by A only")
    for j in set(range(len(b))) - used:
        print(f"{image.name}: {names[int(b.cls[j])]} labeled by B only")
    matched += len(used)
    total += len(rows) + len(b) - len(used)

print(f"agreement: {matched}/{total} objects = {matched / total:.0%}")
000000000049.jpg: person labeled by A only
000000000049.jpg: person labeled by A only
000000000049.jpg: potted plant labeled by A only
000000000049.jpg: person labeled by A only
000000000049.jpg: person labeled by A only
000000000049.jpg: person labeled by A only
000000000061.jpg: person labeled by A only
000000000061.jpg: elephant labeled by A only
000000000061.jpg: person labeled by A only
agreement: 8/17 objects = 47%Como interpretar o resultado:
- A pontuação é o número de objetos correspondentes dividido pelo total de objetos desenhados por qualquer uma das pessoas: 8 de 17.
- As divergências concentram-se. As nove estão em duas imagens, e a maioria envolve pessoas que ocupam bem menos de 1% do enquadramento. Não são nove erros aleatórios; falta uma regra: rotulamos pessoas distantes?
- A solução é acrescentar uma regra ao guia, por exemplo: «rotular todas as pessoas com pelo menos 10 píxeis de altura numa imagem de 640 píxeis». As duas pessoas voltam a anotar essas duas imagens e mede-se novamente a pontuação.
A regra de decisão: só aumenta a escala da anotação quando a concordância chegar a 90%. Abaixo disso, cada nova pessoa que anota multiplica as inconsistências.
Usa a anotação inteligente para acelerar#
A anotação inteligente permite que um modelo YOLO ou SAM proponha rótulos que uma pessoa aceita ou corrige, o que pode multiplicar a produtividade várias vezes. Avança por rodadas: treina com um lote revisto, usa esse modelo para propor o lote seguinte, revê e volta a treinar. Esse é o ciclo de aprendizagem ativa, e Anotação inteligente e rotulagem em lote explica como o fazer na Ultralytics Platform.
Um modelo que não detecta pessoas pequenas não propõe caixas para elas, e um revisor que clica em "aceitar tudo" nunca as adiciona. O próximo modelo, treinado com esses rótulos, deixa de detectá-las com ainda mais confiança. Revise todas as imagens e adicione o que o modelo não detectou, além de corrigir o que desenhou.
Verifica visualmente#
Cada execução de treino da Ultralytics grava labels.jpg e train_batch*.jpg na pasta da execução. O primeiro apresenta gráficos da contagem de classes e das posições e dimensões das caixas; os restantes mostram imagens reais de treino com os respetivos rótulos desenhados. Abre-os antes de terminar a primeira época. O olhar deteta o que as métricas nunca detetarão: caixas à volta de sombras, IDs de classe trocados e polígonos que não se fecham.
Mostrar solução
As divergências em COCO8 transformam-se em entradas do guia como estas:
| Divergência | Regra acrescentada ao guia |
|---|---|
Pessoas distantes em 000000000049.jpg rotuladas apenas por A | Rotular todas as pessoas com pelo menos 10 píxeis de altura numa imagem de 640 píxeis; ignorar as mais pequenas em todas as imagens. |
| Planta em vaso junto à margem do enquadramento, rotulada apenas por A | Rotular um objeto cortado pela margem do enquadramento se pelo menos metade dele estiver visível. |
Elefante parcialmente oculto por outro elefante em 000000000061.jpg | Rotular animais ocluídos se a cabeça ou metade do corpo estiver visível; delimitar apenas a parte visível. |
Para comparar duas pessoas em vez de uma pessoa e um modelo, lê as linhas da pessoa B na segunda pasta de rótulos, exatamente como o script lê as de A (Path("labels_b", image.stem + ".txt")); cria b_cls e b_box a partir delas, usando as mesmas duas linhas, e utiliza esses valores onde o script lê b.cls e b.xyxyn. Executa novamente após a nova anotação; a rodada termina quando a pontuação ultrapassa 90%.