Preparar um conjunto de dados personalizado
Organiza imagens e rótulos no formato Ultralytics YOLO, converte caixas em píxeis em linhas de rótulos normalizadas e deteta rótulos danificados antes do treino.
Uma pasta com o nome errado ou um rótulo não normalizado não interrompe o treino. O Ultralytics ignora as imagens danificadas e continua, por isso treinas com apenas uma parte dos dados, obténs um modelo medíocre e perdes uma tarde à procura da causa no sítio errado.
Esta lição aborda a parte mecânica de um conjunto de dados de deteção: pastas, linhas de rótulos, conversão e verificações. Vais trabalhar com o verdadeiro conjunto de dados de comprimidos médicos, com 115 imagens, usado no resto deste curso. A decisão sobre o que recolher e como o anotar é abordada em Boas práticas de anotação.
Prático
Obter o conjunto de dados de prática#

A estrutura abaixo também é aceite como ficheiro ZIP pela janela Novo conjunto de dados da Ultralytics Platform, pelo que podes carregar sem alterações um conjunto de dados preparado aqui. Transfere 92 imagens de treino e 23 de validação de comprimidos em blísteres e extrai-as para my_dataset:
curl -L -o medical-pills.zip https://github.com/ultralytics/assets/releases/download/v0.0.0/medical-pills.zip
unzip -q medical-pills.zip -d my_dataset
my_dataset/
├── images/
│ ├── train/ Frame_0.jpg, Frame_100.jpg, ... (92 images)
│ └── val/ Frame_144.jpg, ... (23 images)
└── labels/
├── train/ Frame_0.txt, Frame_100.txt, ... (92 files)
└── val/ Frame_144.txt, ... (23 files)Não há manifesto. O Ultralytics encontra cada rótulo substituindo /images/ por /labels/ no caminho da imagem e a extensão por .txt; assim, images/val/Frame_144.jpg lê labels/val/Frame_144.txt. Daí resultam duas consequências:
- As pastas têm de se chamar exatamente
imageselabelse ficar lado a lado. - Uma imagem com um ficheiro de rótulos vazio ou em falta é uma imagem de fundo: é válida e útil para ensinar ao modelo o que não deve detetar, mas apenas se essa for a tua intenção.
Interpretar uma linha de rótulo#
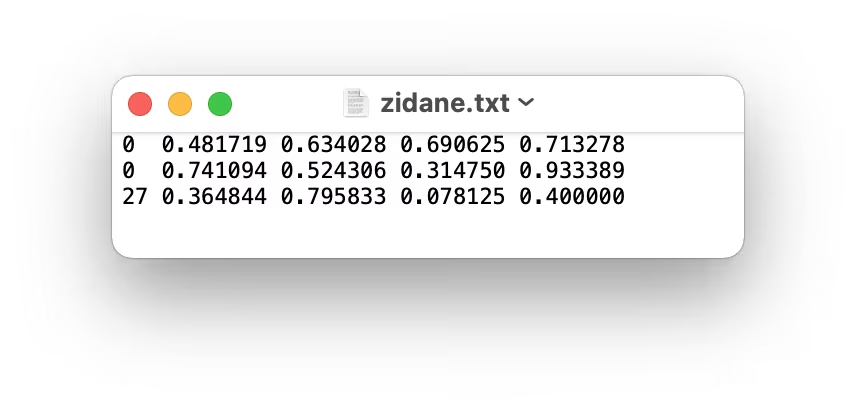
Cada linha representa um objeto: um índice de classe inteiro, seguido do centro e do tamanho da caixa delimitadora como frações da largura e da altura da imagem. Uma linha real de labels/train/Frame_0.txt:
0 0.330729 0.816204 0.103125 0.1212960: índice de classe 0, que o YAML identificará comopill.0.330729 0.816204: o centro da caixa fica a 33% da largura e a 82% da altura da imagem.0.103125 0.121296: a caixa tem cerca de 10% da largura e 12% da altura da imagem.
Exemplo prático: converter uma caixa em píxeis#
As ferramentas de anotação exportam frequentemente os cantos em píxeis (x1, y1, x2, y2). Divide-os pelas dimensões da imagem. A pessoa mais à esquerda na imagem bus.jpg, de 810×1080, da lição anterior, vai de (49, 398) a (240, 902):
| Campo | Fórmula | Valor |
|---|---|---|
x_center | (x1 + x2) / 2 / largura | (49 + 240) / 2 / 810 = 0.178395 |
y_center | (y1 + y2) / 2 / altura | (398 + 902) / 2 / 1080 = 0.601852 |
width | (x2 − x1) / largura | 191 / 810 = 0.235802 |
height | (y2 − y1) / altura | 504 / 1080 = 0.466667 |
A maioria das ferramentas de anotação, incluindo ferramentas como Roboflow, consegue exportar diretamente no formato YOLO. Para JSON COCO, segue o guia de treino com JSON COCO; o repositório JSON2YOLO abrange outros formatos. Para XML Pascal VOC, a fórmula acima pode ser implementada num pequeno script:
import xml.etree.ElementTree as ET
from pathlib import Path

CLASSES = ["person", "bus"]  # index = class id; must match names in data.yaml

def voc_to_yolo(xml_file: Path, out_dir: Path) -> None:
    root = ET.parse(xml_file).getroot()
    w, h = int(root.find("size/width").text), int(root.find("size/height").text)
    lines = []
    for obj in root.iter("object"):
        name = obj.find("name").text
        if name not in CLASSES:
            continue
        box = obj.find("bndbox")
        x1, y1, x2, y2 = (float(box.find(k).text) for k in ("xmin", "ymin", "xmax", "ymax"))
        xc, yc, bw, bh = (x1 + x2) / 2 / w, (y1 + y2) / 2 / h, (x2 - x1) / w, (y2 - y1) / h
        lines.append(f"{CLASSES.index(name)} {xc:.6f} {yc:.6f} {bw:.6f} {bh:.6f}")
    out_dir.mkdir(parents=True, exist_ok=True)
    (out_dir / f"{xml_file.stem}.txt").write_text("\n".join(lines) + "\n")

voc_to_yolo(Path("bus.xml"), Path("labels"))
print(Path("labels/bus.txt").read_text())
Executado num bus.xml com as caixas da pessoa e do autocarro da lição anterior, o script apresenta o exemplo prático e o autocarro:
0 0.178395 0.601852 0.235802 0.466667
1 0.495679 0.454167 0.991358 0.482407
Verificar antes do treino#
Desenha alguns ficheiros de rótulos sobre as respetivas imagens. Uma classe deslocada, coordenadas x e y trocadas ou caixas à volta de sombras são óbvias a olho nu e invisíveis nas métricas:
from ultralytics.data.utils import visualize_image_annotations

visualize_image_annotations(
    "my_dataset/images/train/Frame_0.jpg",
    "my_dataset/labels/train/Frame_0.txt",
    {0: "pill"},
)
Depois, deixa o Ultralytics verificar todos os ficheiros. Analisa os rótulos na primeira leitura do conjunto de dados e decide, linha a linha, se cada imagem pode ser usada:
A linha de análise apresenta o resultado: 23 images, 0 backgrounds, 0 corrupt é o aspeto de um conjunto de dados íntegro. Qualquer outro resultado corresponde a um dos erros abaixo.
Evita estes erros#
Sintoma: ignoring corrupt image/label: non-normalized or out of bounds coordinates [634. 881. 198. 163.] e uma contagem corrupt diferente de zero. Causa: valores de píxeis em vez de frações. Solução: divide pela largura e altura da imagem. Qualquer valor de etiqueta superior a 1 significa que a caixa nunca foi normalizada.
Sintoma: yolo val percorre 0 images, 23 backgrounds e apresenta o aviso No labels found; o treino termina com ValueError: train: No labels found — neste caso, porque a pasta de etiquetas se chamava annotations. Solução: dá exatamente às pastas os nomes images e labels, com nomes de ficheiro correspondentes.
Sintoma: Label class 1 exceeds dataset class count 1. Possible class labels are 0-0. Causa: a ferramenta de exportação numerou as classes a partir de 1. Solução: as classes YOLO começam em 0; subtrai 1 no script de conversão ou corrige a configuração de exportação.
Se as caixas aparecerem deslocadas meia caixa para baixo e para a direita, escreveste x1 y1 w h em vez de x_center y_center w h. Desenhar um ficheiro deteta isto em segundos; nenhuma verificação de análise consegue fazê-lo.
Para verificações sistemáticas em todo o conjunto de dados, consulta Controlo de qualidade do conjunto de dados. Os conjuntos integrados, como coco8, coco128 e african-wildlife, são bons exemplos de estrutura; a visão geral dos conjuntos de dados apresenta-os todos. O treinador aplica aumento de dados aos teus rótulos, por isso uma rápida limpeza de dados nesta fase compensa em cada época.
Mostrar solução
for s in train val; do
  echo "$s: $(ls my_dataset/images/$s | wc -l) images, $(ls my_dataset/labels/$s | wc -l) labels"
done
# train: 92 images, 92 labels
# val:   23 images, 23 labels
from pathlib import Path
for txt in Path("my_dataset/labels").rglob("*.txt"):
for line in txt.read_text().splitlines():
values = [float(v) for v in line.split()[1:]]
if any(v < 0 or v > 1 for v in values):
print(txt, line)Se o script não apresentar nada, todas as coordenadas estão normalizadas. Contagens iguais por divisão significam que cada imagem tem um ficheiro de rótulos; a linha de análise da próxima lição confirma que não há ficheiros danificados.