Validar e diagnosticar
Valida best.pt em comparação com uma referência, consulta a matriz de confusão, os valores por classe e as imagens de previsão, e transforma-os numa lista específica de correções.
Um único valor de mAP indica-te quanto o modelo erra, mas não o quê. Objetos pequenos não detetados, duas classes confundidas entre si e caixas pouco ajustadas reduzem todos o mAP, e cada problema exige uma correção diferente. Se adivinhares mal, passarás uma semana a recolher dados errados.
Nesta lição, vais executar o modo Val em best.pt, comparar os resultados com a referência e consultar a matriz de confusão e as imagens de previsão até conseguires elaborar a lista de correções para a próxima ronda. O guia de métricas de desempenho é o complemento detalhado.
Prático
Exemplo prático: validar best.pt#
from ultralytics import YOLO

model = YOLO("runs/detect/pills_v1/weights/best.pt")
metrics = model.val(data="my_dataset/data.yaml")

print(f"precision {metrics.box.mp:.3f}  recall {metrics.box.mr:.3f}")
print(f"mAP50 {metrics.box.map50:.3f}  mAP50-95 {metrics.box.map:.3f}")
Resultado real de val.py:
precision 0.970  recall 0.957
mAP50 0.977  mAP50-95 0.659
Os gráficos ficam numa nova pasta runs/detect/val (depois val-2, ...). Coloca os valores ao lado da referência:
| Modelo | mAP50 | mAP50-95 |
|---|---|---|
yolo26n.pt pré-treinado (sem classe de comprimidos) | 0.001 | 0.0002 |
pills_v1 (10 épocas, imgsz 320, CPU) | 0.977 | 0.659 |
O que os números dizem:
- Precisão 0.970, revocação 0.957: equilibrado. Poucos falsos alarmes e poucas falhas.
- mAP50 0.977: com um requisito de sobreposição pouco rigoroso, o modelo encontra quase todas as pílulas.
- mAP50-95 0.659: com uma sobreposição rigorosa, muitas caixas não são precisas. Uma diferença tão grande aponta para a localização — mais épocas, um
imgszmaior ou rótulos mais precisos — e não para falta de dados.
Para saber como precisão, revocação e mAP se equilibram, consulta Interpretar as métricas de deteção com rigor.
Sabe que ficheiro responde a cada pergunta#
| Pergunta | Arquivo |
|---|---|
| Que classes são confundidas e quais não são detetadas? | confusion_matrix_normalized.png |
| Como é que cada classe equilibra precisão e revocação? | BoxPR_curve.png |
| Em que limiar de confiança implementar? | BoxF1_curve.png: o seu pico é um bom ponto de partida para conf |
| Como são as falhas? | val_batch0_labels.jpg vs. val_batch0_pred.jpg |
| O modelo está sobreajustado? | results.png na pasta de treino |
Lê a matriz de confusão#
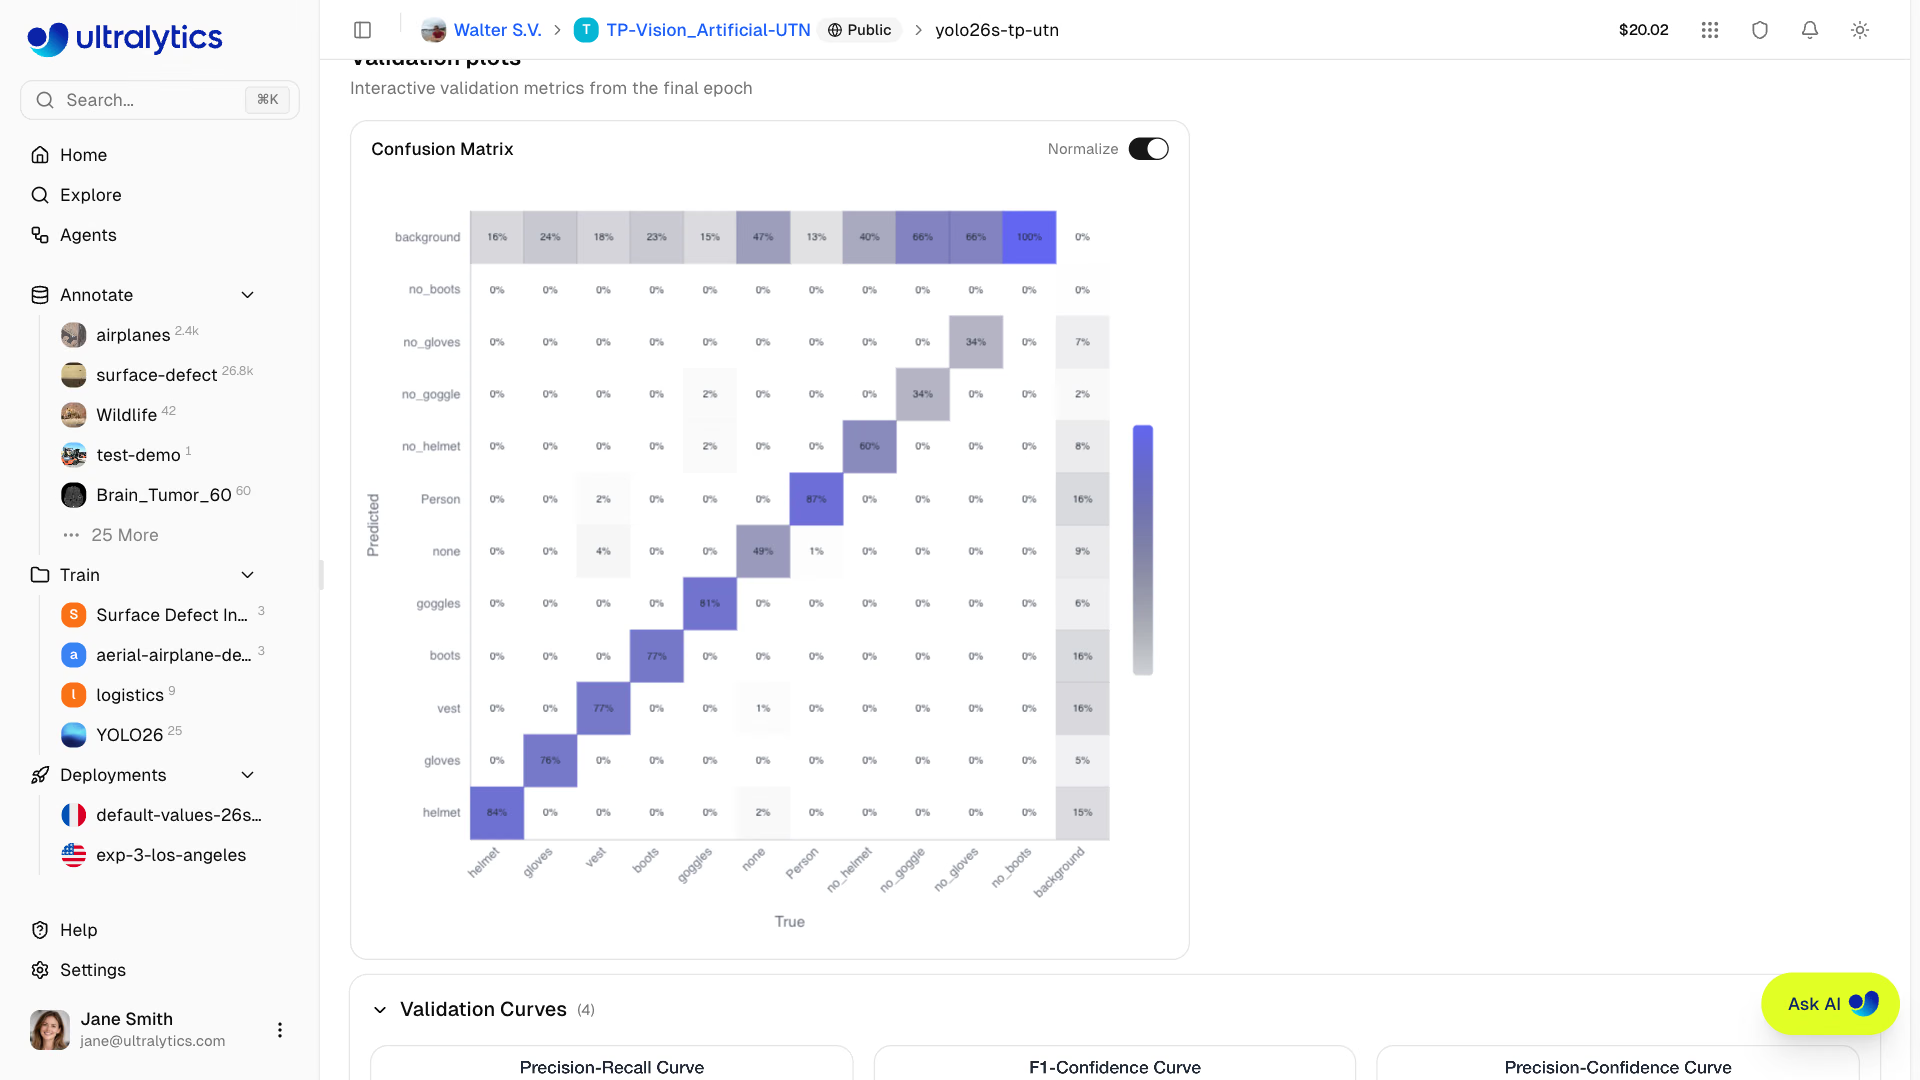
A matriz de confusão é o diagnóstico individual mais útil. Nos gráficos do Ultralytics, as colunas representam a classe verdadeira e as linhas representam a classe prevista, com uma linha e uma coluna background adicionais. A versão normalizada divide cada coluna pelo respetivo total, para que cada coluna mostre para onde foram os objetos dessa classe. O conjunto Pills tem uma só classe, por isso pratica com este exemplo de armazém com três classes (números ilustrativos):
| Prevista ↓ / Verdadeira → | empilhador | pessoa | palete | fundo |
|---|---|---|---|---|
| empilhador | 0.78 | 0.03 | 0.18 | 0.45 |
| pessoa | 0.04 | 0.91 | 0.00 | 0.20 |
| palete | 0.10 | 0.00 | 0.65 | 0.35 |
| fundo | 0.08 | 0.06 | 0.17 | — |
- Diagonal: proporção de cada classe detetada corretamente. A palete, com 0.65, é a classe mais fraca.
- Fora da diagonal: confusões. 18% das paletes verdadeiras foram previstas como empilhadores, e 10% dos empilhadores como paletes.
- Linha do fundo: falhas de deteção. 17% das paletes não foram detetadas.
- Coluna do fundo: falsos positivos, caixas desenhadas em espaços vazios. Desses, 45% foram classificados como empilhadores.
Cada tipo de célula corresponde a uma correção:
| Padrão | Solução |
|---|---|
| Duas classes confundem-se entre si | Adiciona exemplos que as distingam: empilhadores a transportar paletes, paletes empilhadas junto a empilhadores |
| Linha do fundo elevada (falhas de deteção) | Mais exemplos dessa classe nas condições em que não é detetada |
| Coluna do fundo elevada (falsos alarmes) | Imagens de fundo das cenas que os desencadeiam, como corredores vazios |
Lê os números de cada classe#
Com várias classes, o registo de validação apresenta uma linha por classe, e metrics.box.maps contém o mAP50-95 por classe para utilização no código. Continuando com o exemplo do armazém:
                 Class     Images  Instances      Box(P          R      mAP50  mAP50-95)
                   all         50        102       0.78       0.71       0.74       0.51
              forklift         30         45       0.85       0.78       0.81       0.58
                person         40         50       0.92       0.88       0.91       0.64
                pallet          5          7       0.58       0.48       0.51       0.31
pallet está muito abaixo das outras classes e tem apenas 7 instâncias na validação. Ou o modelo é fraco na deteção de paletes ou há poucos dados de validação para avaliar. Ambas as hipóteses levam à mesma medida: recolhe mais paletes para treino e validação.
Analisa as falhas#
Abre val_batch0_labels.jpg e val_batch0_pred.jpg lado a lado. As diferenças mostram as falhas em imagens, e os padrões entre elas permitem fazer o diagnóstico: falhas nas margens da imagem, objetos pequenos, uma condição de iluminação ou um objeto semelhante que causa confusão. Padrões como estes no conjunto de dados são quase sempre mais importantes do que ajustar hiperparâmetros.
Nas imagens de validação do modelo de pílulas, as pílulas claramente visíveis têm pontuações próximas de 1.0. As caixas com baixa confiança, cerca de 0.3–0.5, concentram-se em pílulas parcialmente escondidas sob outra embalagem blister e em pílulas cortadas pela margem da imagem. Não é algo que se resolva ajustando conf; é uma questão de política de anotação. Deve contar uma pílula meio escondida? Decide, regista a regra e anota todas as imagens da mesma forma.
Depois, abre results.png. As perdas de treino e validação devem diminuir em conjunto. Se a perda de treino continuar a diminuir enquanto a perda de validação aumenta, o modelo está sobreajustado; se ambas permanecerem elevadas, há subajuste. O compromisso entre viés e variância ajuda a compreender ambos.
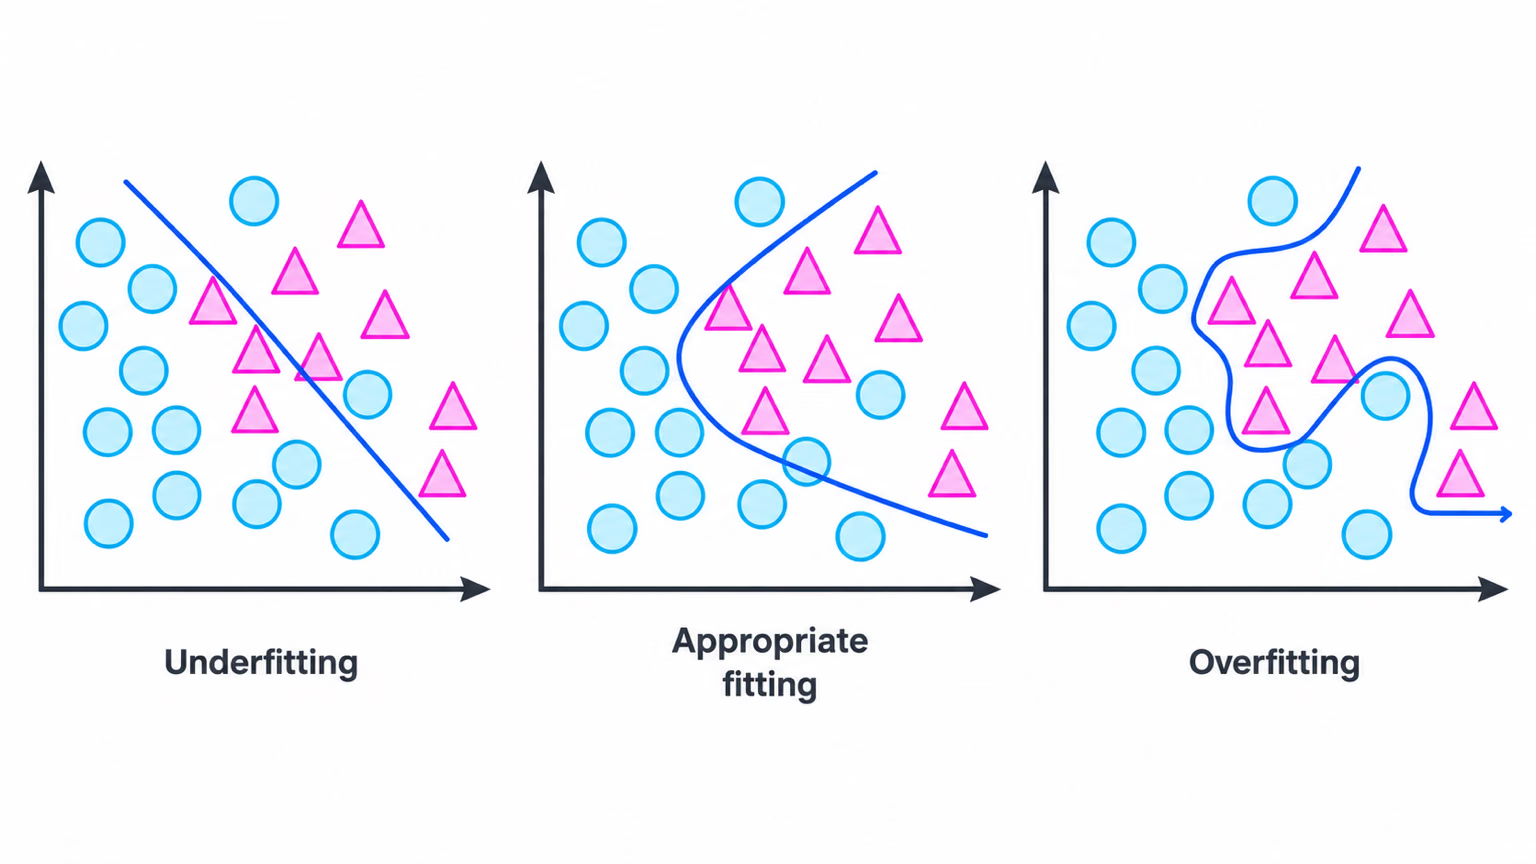
Para corrigir o sobreajuste, por ordem da frequência com que funcionam: dados mais variados; menos épocas ou um patience mais rigoroso; e aumento de dados (hsv_h, degrees, translate, scale, fliplr, mosaic, ...). As predefinições de aumento de dados já são eficazes; altera-as apenas quando houver um motivo, como desativar fliplr quando a distinção entre esquerda e direita for importante.
Transforma as conclusões numa lista de correções#
Corrige os dados antes de ajustar os hiperparâmetros e altera uma coisa por ciclo para saberes o que ajudou. A parte do ciclo dedicada ao conjunto de dados é abordada em Primeiro ajuste fino e ciclo de iteração.
Evita estes erros#
Sintoma: um modelo que obteve 0.659 mAP50-95 passa de repente a obter 0.403. Causa: pills_v1 foi treinado com imgsz=320 e validado com imgsz=640; os objetos aparecem duas vezes maiores do que qualquer coisa que o modelo tenha aprendido. Solução: valida e implementa com o imgsz usado no treino e compara execuções apenas com o mesmo tamanho.
A validação é executada com conf=0.001 para poder traçar a curva completa de precisão-revocação, e é por isso que val_batch0_pred.jpg apresenta caixas que a tua aplicação nunca mostraria. Escolhe o limiar de implementação a partir de BoxF1_curve.png e, depois, verifica-o com predict.
Com 23 imagens, a precisão de uma época oscilou de 0.93 para 0.80 e voltou a subir. Avalia as tendências ao longo de épocas e execuções, e aumenta o conjunto de validação antes de confiar em diferenças de um ou dois pontos.
Mostrar solução
Baseline mAP50-95 0.0002 -> pills_v1 0.659 (mAP50 0.977), both at imgsz=320

Failures:
- Low-confidence boxes (about 0.3-0.5) on pills half-hidden under another pack.
- Low-confidence or missing boxes on pills cut off at the image edge.

Overfitting: none. val/box_loss flattened near 1.05; val/cls_loss spiked at epochs 4-6
and then fell to its lowest value (1.08) at epoch 10.

Fix list:
1. Write a labeling rule for partly hidden and edge pills, then relabel the val set to match.
2. Train longer and larger: epochs=50, imgsz=640 (mAP50-95 lags mAP50, so box tightness is the gap).
3. Add 20 frames with overlapping packs, labeled under the new rule.