Treina o teu primeiro modelo
Faz o ajuste fino de YOLO26 com o teu conjunto de dados numa única chamada, lê o registo de treino em tempo real, linha a linha, e encontra o best.pt e os gráficos importantes na pasta da execução.
Treinar um detetor do zero demora dias e exige conjuntos de dados enormes. O ajuste fino de um YOLO26 pré-treinado com cerca de cem imagens demora aproximadamente um minuto num CPU de portátil, porque a aprendizagem por transferência reutiliza tudo o que o modelo já sabe sobre arestas, formas e objetos.
Nesta lição, vais treinar com o conjunto de dados de comprimidos, observar o mAP50-95 subir de um valor de referência próximo de zero para 0.66 em dez épocas e aprender a perceber, a partir do registo e logo no início, se uma execução está a correr bem ou a desperdiçar o teu tempo.
Prático
Exemplo prático: treinar o detetor de comprimidos#
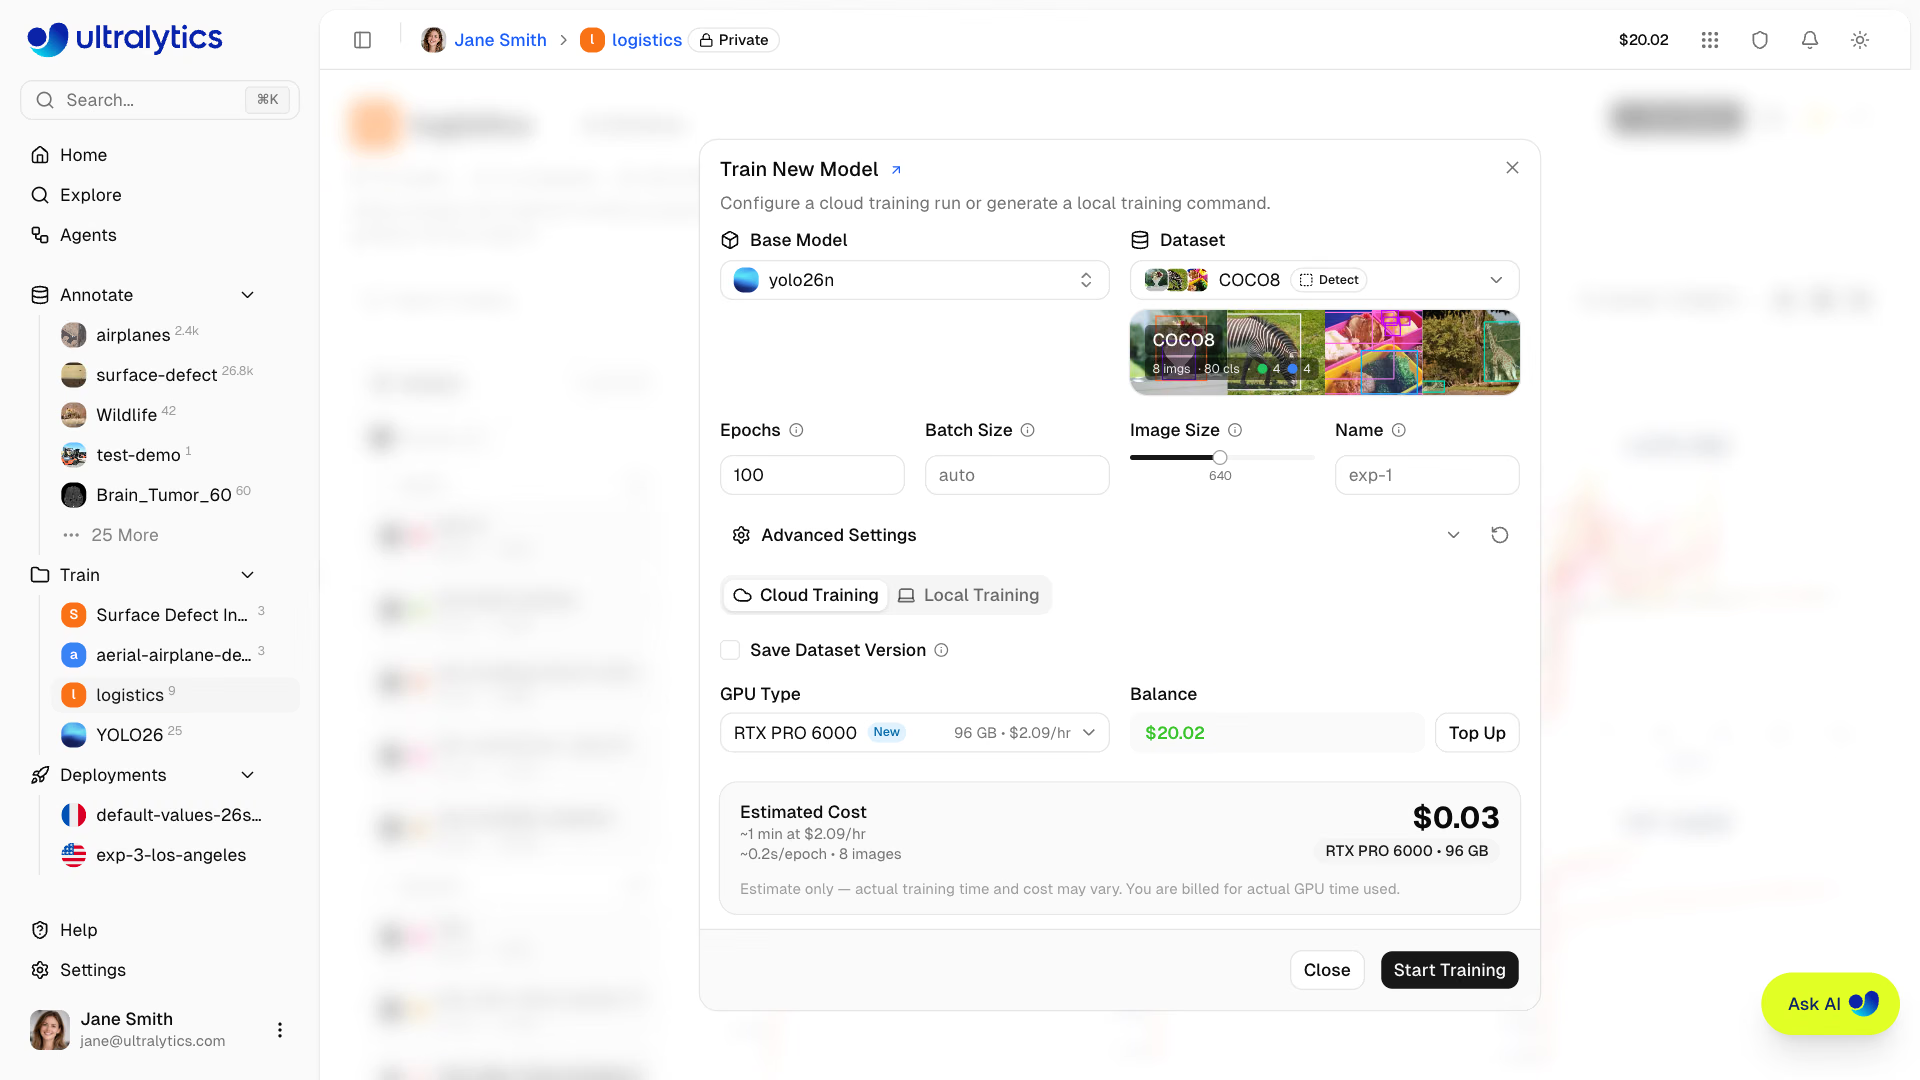
A caixa de diálogo Train New Model da Ultralytics Platform pede as mesmas opções que o código abaixo — modelo base, conjunto de dados, épocas e tamanho da imagem — e executa-as em GPUs na cloud ou gera o comando local correspondente. Estas definições permitem concluir o treino em cerca de um minuto num CPU de portátil:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # pré-treinado em COCO
results = model.train(data="my_dataset/data.yaml", epochs=10, imgsz=320, name="pills_v1")
print(results.save_dir)
CLI e Python são equivalentes. epochs=10 e imgsz=320 mantêm curtas as execuções em CPU; com um GPU, omite ambos e aceita as predefinições (epochs=100, imgsz=640), porque mais épocas e píxeis quase sempre ajudam. O modo Train executa este ciclo por ti:
Lê o registo linha a linha#
Resultado real, reduzido às duas primeiras e às duas últimas épocas:
optimizer: AdamW(lr=0.002, momentum=0.9) with parameter groups ...
Using 92 train, 23 val images for fraction=1.0 at imgsz=320
      Epoch    GPU_mem   box_loss   cls_loss    l1_loss  Instances       Size
       1/10         0G      1.818      3.899   0.008805        206        320: 100% 6/6 3.3s
                   all         23        399      0.957      0.805      0.927      0.548
       2/10         0G      1.434      3.291   0.006285        208        320: 100% 6/6 4.4s
                   all         23        399      0.953      0.911      0.964      0.592
       ...
       9/10         0G      1.121      1.103   0.005143        194        320: 100% 6/6 5.0s
                   all         23        399      0.949      0.957      0.975      0.656
      10/10         0G      1.174      1.125   0.005068        212        320: 100% 6/6 5.1s
                   all         23        399       0.97      0.957      0.977      0.659
10 epochs completed in 0.015 hours.
optimizer: AdamW(lr=0.002 ...): a predefiniçãooptimizer=autoescolheu o otimizador e a taxa de aprendizagem por ti.Using 92 train, 23 val images: confirma que estes valores correspondem ao teu conjunto de dados. Um número mais baixo significa que algumas imagens foram ignoradas.GPU_mem 0G: treino no CPU. Num GPU, verias aqui a memória em utilização;0Gnuma máquina com GPU significa que o GPU não está a ser utilizado.- Primeira linha de cada época: as três perdas do conjunto de treino, mais o número de objetos anotados no último lote (
Instances) e o tamanho da imagem. - Linha
allde cada época: precisão, revocação, mAP50 e mAP50-95 no conjunto de validação. É esta linha que deves observar.
| Coluna | Significado | Tendência saudável |
|---|---|---|
box_loss | Distância entre as caixas previstas e as caixas anotadas | Diminui e depois estabiliza |
cls_loss | Grau de erro das pontuações das classes | Diminui e depois estabiliza |
l1_loss | Erro direto das coordenadas das caixas de YOLO26 | Diminui |
P, R | Precisão e revocação no conjunto de validação | Aumentam e mantêm-se equilibradas |
mAP50, mAP50-95 | Qualidade da deteção; o mAP50-95 também recompensa caixas bem ajustadas | Aumenta e depois estabiliza |
Neste caso, o mAP50-95 passou da referência de 0.0002 para 0.548 após uma época e 0.659 após dez. A precisão caiu para 0.80 na época 4 e recuperou: os resultados de épocas isoladas são ruidosos com 23 imagens de validação, por isso avalia a tendência, não uma única linha. Regras para tomar decisões enquanto a execução está ativa:
- As perdas diminuem e o mAP aumenta: deixa a execução continuar.
- As perdas mantêm-se estáveis desde a época 1: interrompe com Ctrl+C e verifica os rótulos e o YAML.
- A precisão é muito superior à revocação: o modelo é cauteloso e não deteta alguns objetos. A revocação é muito superior à precisão: o modelo deteta objetos onde não existem.
- O mAP mantém-se estável durante muitas épocas: mais épocas não vão ajudar; altera os dados ou
imgsz.
As três perdas são componentes da função de perda de YOLO26; o guia de métricas de desempenho explica cada métrica em detalhe.
Encontra o que a execução gerou#
Tudo fica em runs/detect/pills_v1/:
| Arquivo | Para que serve |
|---|---|
weights/best.pt | Checkpoint com a melhor aptidão de validação ao longo das épocas; usa-o para inferência e exportação |
weights/last.pt | Checkpoint mais recente; utilizado para retomar uma execução interrompida |
args.yaml | Todos os argumentos utilizados na execução, para a poderes reproduzir |
results.csv, results.png | Perdas e métricas de cada época, em dados e em gráficos |
labels.jpg | Contagens de classes e histogramas do tamanho e da posição das caixas |
train_batch*.jpg | Lotes de treino aumentados, com os rótulos desenhados |
val_batch*_labels.jpg, val_batch*_pred.jpg | Verdade de referência e previsões em imagens de validação |
confusion_matrix*.png, Box*_curve.png | Matriz de confusão e curvas de precisão, revocação, F1 e PR |
Abre primeiro train_batch0.jpg. Se as caixas não estiverem sobre os objetos, os rótulos estão errados e nenhuma quantidade de épocas vai corrigir isso.
Altera primeiro estes argumentos#
| Argumento | Padrão | Quando alterar |
|---|---|---|
epochs | 100 | Experiências curtas em CPU ou conjuntos de dados pequenos que começam a apresentar sobreajuste (reduz); conjuntos de dados grandes que continuam a melhorar (aumenta, 200–300) |
imgsz | 640 | Objetos pequenos (aumenta para 1024 ou 1280) ou experiências em CPU (reduz) |
batch | 16 | Tamanho do lote: reduz em caso de erros de falta de memória ou usa -1 para ajustar automaticamente o tamanho a cerca de 60% da memória do GPU |
patience | 100 | Para antecipadamente quando a aptidão de validação não melhorar durante N épocas, por exemplo, patience=20 |
device | automático | Força cpu, mps, um índice de GPU como 0 ou vários índices, como [0, 1] |
name | train | Sempre: dá às execuções nomes que indiquem o que foi alterado |
model.train(data="my_dataset/data.yaml", epochs=200, imgsz=1024, batch=-1, patience=20, name="pills_v1_1024")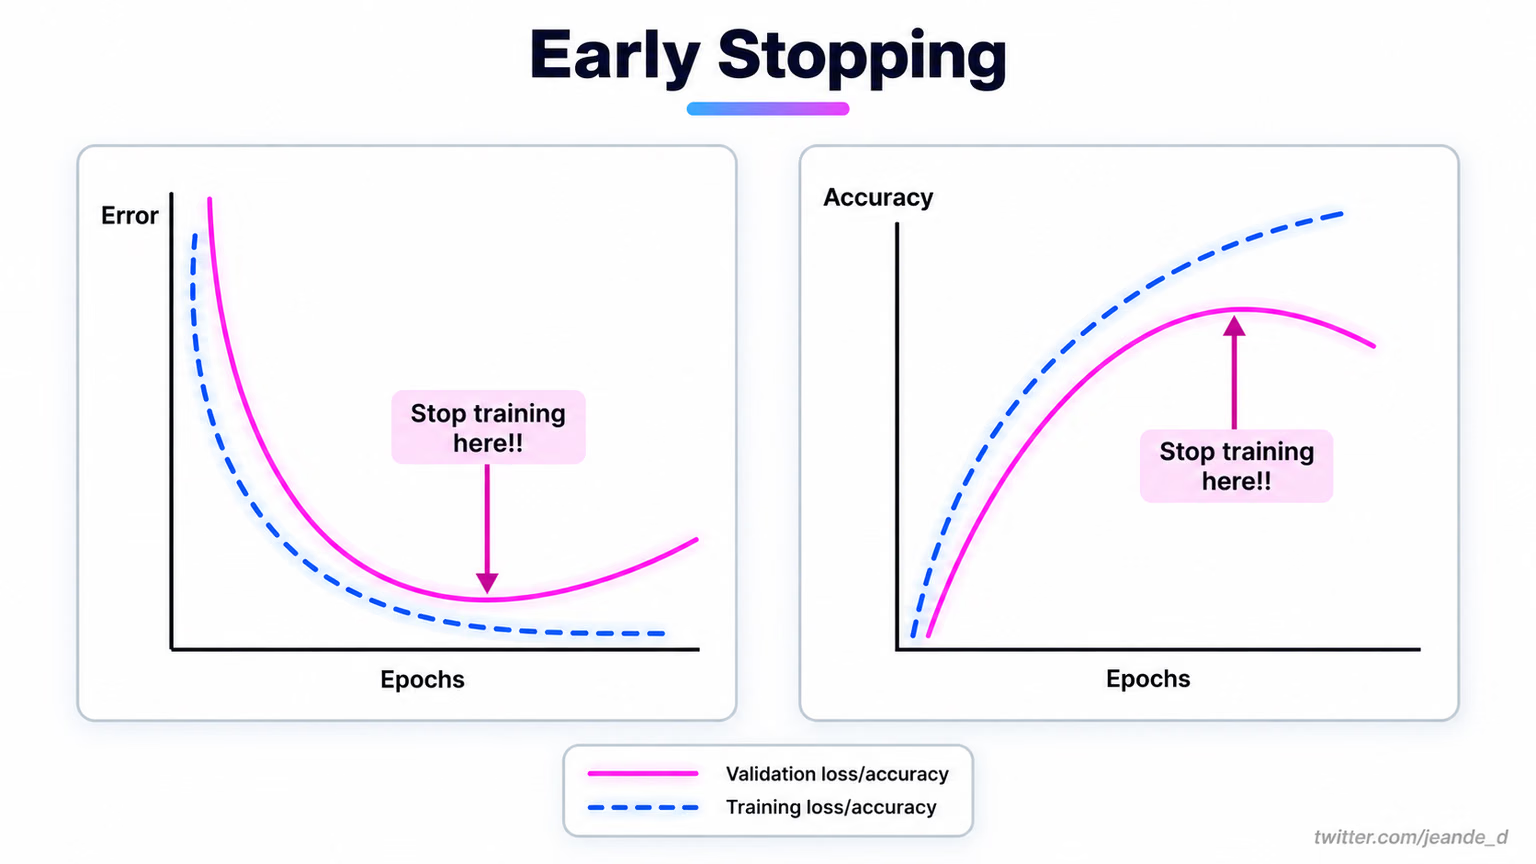
A predefinição 100 de patience significa que uma execução de 100 épocas nunca para antecipadamente. Um valor mais baixo termina uma execução estagnada quando as curvas acima indicam que deve parar; best.pt é mantido em qualquer dos casos.
Com vários GPUs, passa uma lista como device=[0, 1, 2, 3]: o Ultralytics inicia o treino distribuído com paralelismo de dados (DDP) por ti, batch corresponde ao total entre os GPUs e o treino utiliza precisão mista por predefinição (amp=True). Quando a execução ultrapassar a capacidade do teu portátil, o mesmo conjunto de dados e os mesmos argumentos podem ser executados em GPUs na cloud através da Ultralytics Platform, como explicado em Treinar, ler e ajustar finamente execuções.
Evita estes erros#
Sintoma: mAP perto de zero após muitas épocas num conjunto de dados pequeno. Causa: o modelo veio de yolo26n.yaml (pesos aleatórios) em vez de yolo26n.pt. Solução: começa sempre com um .pt pré-treinado. Treinar do zero só compensa para investigação de backbones ou conjuntos de dados muito grandes.
Sintoma: CUDA out of memory na primeira época. Solução: reduz batch para metade ou define batch=-1 para que o AutoBatch escolha um tamanho que caiba. Reduzir imgsz também ajuda, mas altera o que o modelo consegue ver.
last.pt é a época final, que pode ser pior do que uma anterior. best.pt é a época com a melhor aptidão de validação, e é essa que deves validar, exportar e disponibilizar.
O guia de sugestões para o treino de modelos aborda os restantes argumentos e o guia de ajuste de hiperparâmetros aborda as variações da taxa de aprendizagem e o ajustador genético. O guia de ajuste fino aborda o congelamento de camadas.
Mostrar solução
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
results = model.train(data="my_dataset/data.yaml", epochs=10, imgsz=320, name="pills_v1")
print(results.save_dir)  # runs/detect/pills_v1
Baseline (yolo26n.pt, no pill class): mAP50 0.001, mAP50-95 0.0002
pills_v1 (10 epochs, imgsz 320, CPU, ~1 min): mAP50 0.977, mAP50-95 0.659
Plateau: mAP50-95 gains shrink after epoch 8 (0.649 -> 0.656 -> 0.659)
train_batch0.jpg: yes, boxes sit on the pillsOs valores exatos variam ligeiramente consoante o hardware e a versão do pacote.