Primeiro ajuste fino e ciclo de iteração
Faça o ajuste fino dos pesos pré-treinados do YOLO26 com as configurações padrão, classifique as classes por AP com contagens de erros por objetos não detectados e confusões, e transforme a classe mais fraca na próxima correção do conjunto de dados.
A execução de treino desta lição obtém 0.66 mAP50, o que parece indicar um problema com a taxa de aprendizagem. Uma tabela por classe mostra outra coisa: cup tem 14 objetos rotulados na validação e o modelo não encontra nenhum. É um problema com os dados, e nenhum hiperparâmetro o teria corrigido. Trate a primeira execução como um diagnóstico que indica qual classe deve corrigir a seguir.
Prático
Comece com pesos pré-treinados#
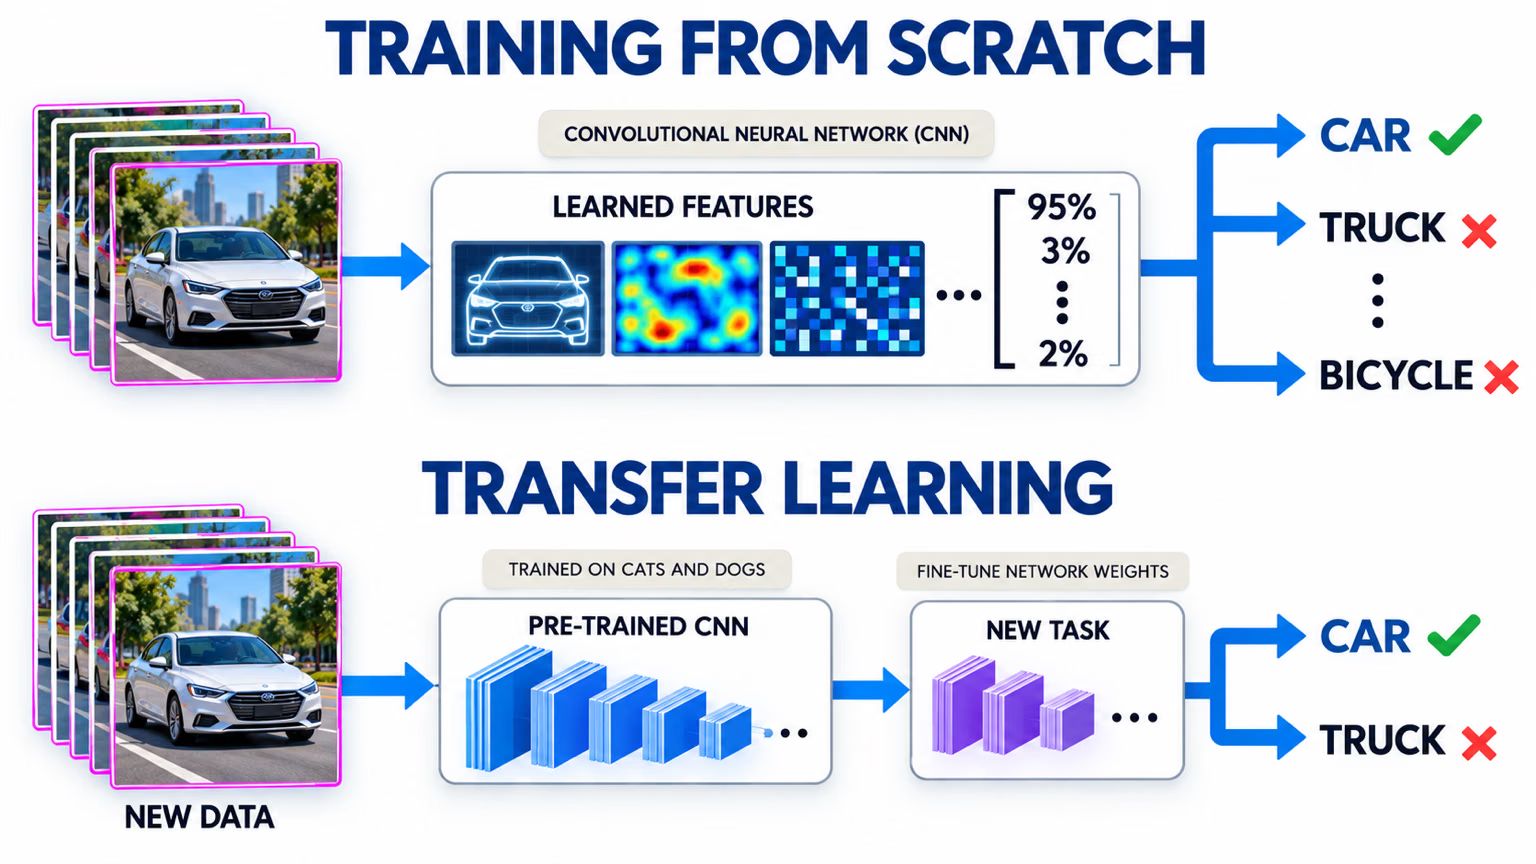
O ajuste fino começa com pesos que já reconhecem bordas, texturas e formas, por isso converge mais rápido e precisa de muito menos dados do que o treinamento com pesos aleatórios. Escolha o checkpoint do YOLO26 que corresponda à sua tarefa:
| Tarefa | Checkpoint pré-treinado | Pré-treinado em |
|---|---|---|
| Detecção | yolo26n.pt | COCO |
| Segmentação | yolo26n-seg.pt | COCO |
| Semântica | yolo26n-sem.pt | Cityscapes |
| Profundidade | yolo26n-depth.pt | Uma ampla combinação de dados de profundidade em ambientes internos e externos |
| Classificação | yolo26n-cls.pt | ImageNet |
| Pose | yolo26n-pose.pt | Pontos-chave do COCO |
| OBB | yolo26n-obb.pt | DOTAv1 |
O backbone e o neck são transferidos como estão; a cabeça da tarefa é parcialmente reinicializada para corresponder ao número de classes. O treinamento do zero só compensa com conjuntos de dados muito grandes em domínios bastante incomuns. Comece com o modelo nano (n) para obter rapidamente um resultado de referência e passe para modelos maiores somente quando o ciclo de dados deixar de trazer melhorias. O guia de ajuste fino explica o que acontece internamente.
Execute o modelo de referência#
Treine com as configurações padrão; o objetivo da primeira execução é estabelecer uma referência, não bater um recorde. O treinamento usa a divisão do conjunto de prática definida em Divida o conjunto de dados corretamente, começando pela criação do YAML de dados:
from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset
from ultralytics.utils import YAML

names = check_det_dataset("coco128.yaml")["names"]  # # o conjunto de prática mantém os nomes das classes do COCO
YAML.save("practice.yaml", {"path": "datasets/practice", "train": "train.txt", "val": "val.txt", "test": "test.txt", "names": names})

model = YOLO("yolo26n.pt")  # # pré-treinado no COCO; use o checkpoint correspondente à sua tarefa
model.train(data="practice.yaml", epochs=3, imgsz=320)  # # uma execução real: epochs=100, imgsz=640
Class Images Instances Box(P R mAP50 mAP50-95)
all 20 143 0.614 0.6 0.664 0.486A pasta da execução (runs/detect/train/) agora contém weights/best.pt. Na primeira execução, vale a pena considerar apenas três argumentos:
| Argumento | Padrão | Quando alterar |
|---|---|---|
epochs | 100 | Menos para conjuntos de dados minúsculos; 200–300 para conjuntos muito grandes |
imgsz | 640 | 1024 ou 1280 se houver muitos objetos pequenos no quadro |
batch | 16 | -1 para ajuste automático do tamanho do lote; reduza o valor em caso de erros de falta de memória |
Treine seu primeiro modelo explica detalhadamente a chamada de treinamento e o registro em tempo real.
Classifique as classes e analise os erros por objetos não detectados#
O mAP geral oculta a origem do problema. Classifique as classes por AP50-95 e use a matriz de confusão para dividir os erros de cada classe entre objetos que o modelo não detectou e objetos que classificou como outra classe:
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")  # your fine-tuned checkpoint
metrics = model.val(data="practice.yaml", imgsz=320, verbose=False)  # same data YAML and imgsz as training

matrix = metrics.confusion_matrix.matrix  # rows: predicted class, columns: true class; last row = background
for ap, cls in sorted(zip(metrics.box.ap, metrics.box.ap_class_index))[:5]:  # weakest five classes first
    total, missed, correct = matrix[:, cls].sum(), matrix[-1, cls], matrix[cls, cls]
    print(f"{model.names[cls]:>8}  AP50-95={ap:.3f}  {total:2.0f} labeled: {correct:2.0f} found, "
          f"{missed:2.0f} missed, {total - correct - missed:2.0f} called another class")
car AP50-95=0.000 4 labeled: 0 found, 4 missed, 0 called another class
fork AP50-95=0.000 1 labeled: 0 found, 0 missed, 1 called another class
handbag AP50-95=0.025 1 labeled: 1 found, 0 missed, 0 called another class
cup AP50-95=0.039 14 labeled: 0 found, 10 missed, 4 called another class
sink AP50-95=0.075 1 labeled: 1 found, 0 missed, 0 called another classCada tipo de erro aponta para uma correção diferente no conjunto de dados:
- Poucas instâncias no conjunto de validação (
fork,handbag,sink, com 1 cada): o AP é ruído. Não aja com base em uma classe até que o conjunto de validação contenha pelo menos algumas dezenas de instâncias dela; primeiro, colete mais grupos para validação. - Não detectado (
car4 de 4,cup10 de 14): o modelo não detecta nenhum objeto. Verifique se esse cenário está coberto no conjunto de treinamento e procure rótulos ausentes comsuspect_labels.py. - Classificado como outra classe (
cup4 de 14): as definições das classes se sobrepõem. Abra essas imagens, refine as definições e identifique no guia a classe parecida.
cup é o achado que exige ação neste caso: 14 instâncias rotuladas, e nenhuma foi encontrada.
Interprete a pasta da execução como retorno sobre os dados#
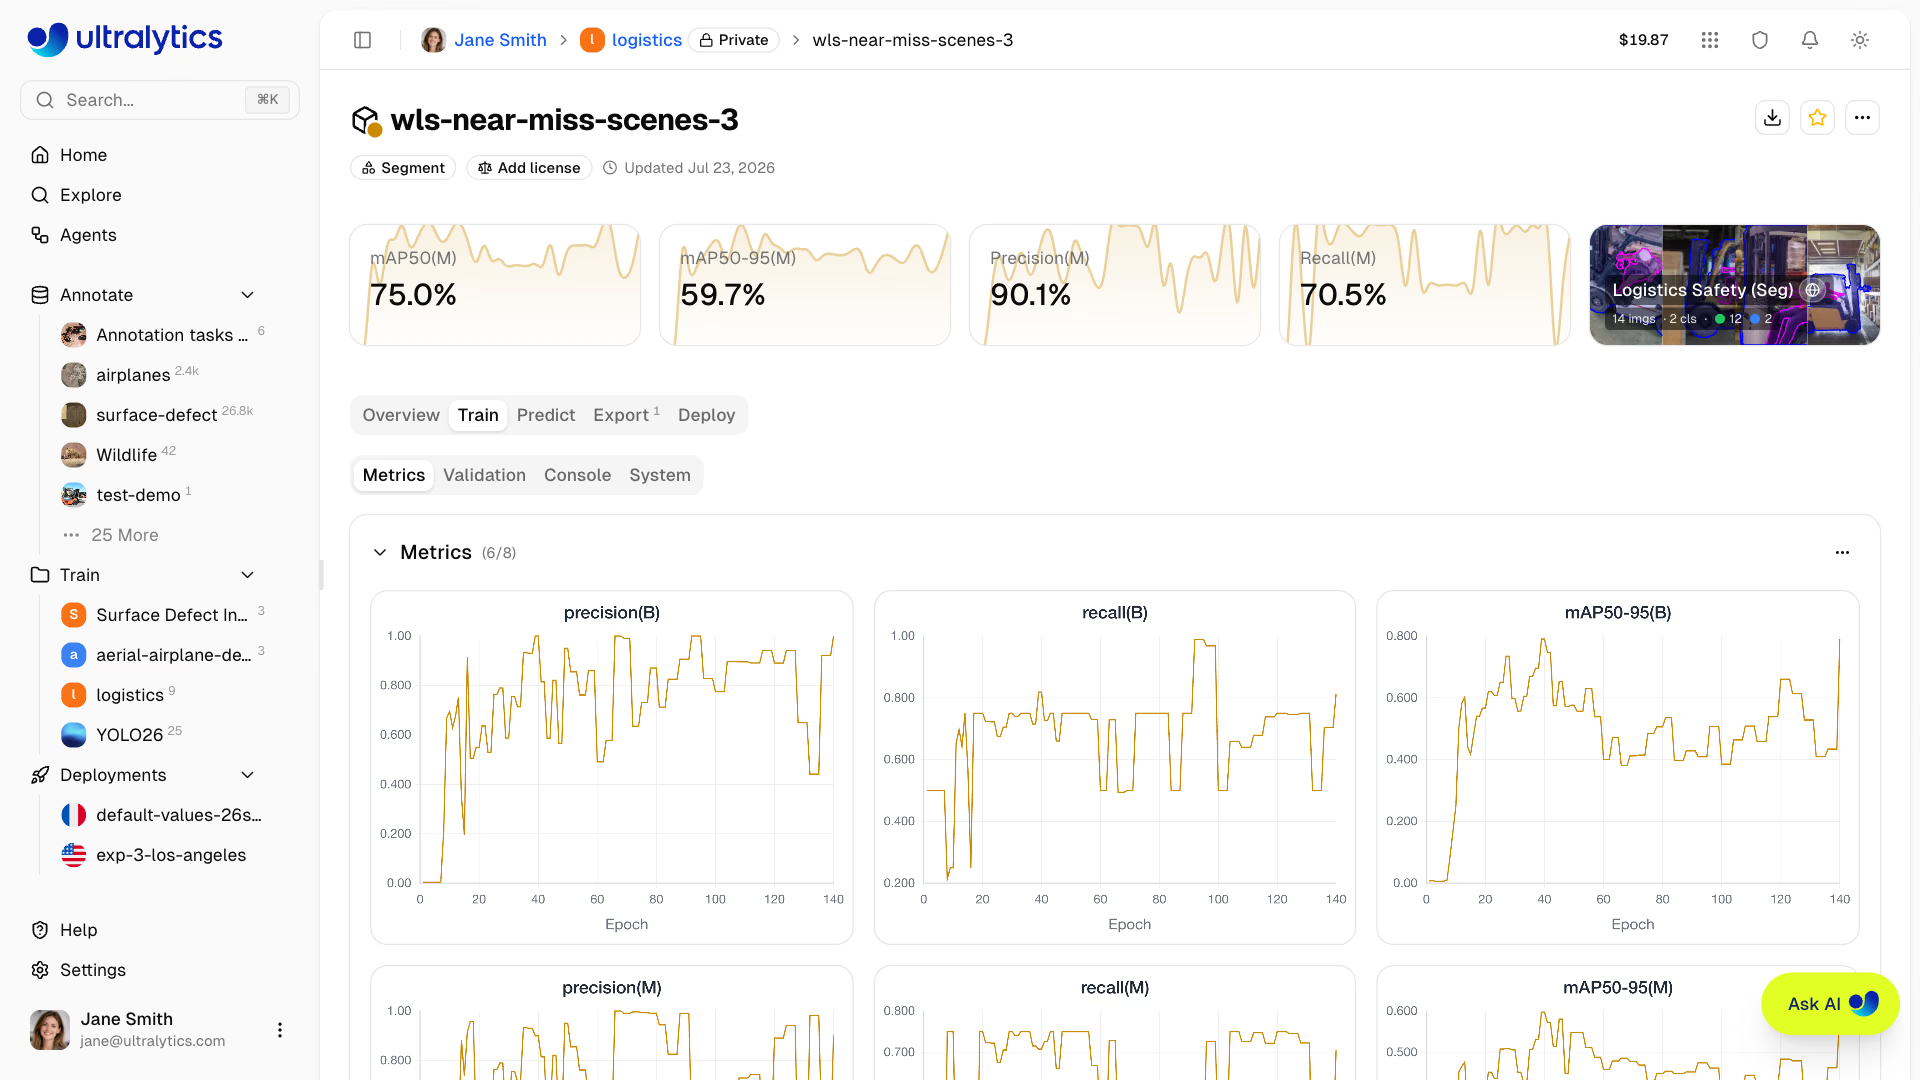
Cada execução de treinamento gera estes arquivos, e a Ultralytics Platform apresenta os mesmos gráficos em tempo real durante o treinamento na nuvem:
| Arquivo | O que informa sobre os dados |
|---|---|
confusion_matrix_normalized.png | Quais classes são confundidas entre si ou não são detectadas e acabam como fundo |
BoxPR_curve.png | Precisão-revocação por classe; uma curva baixa indica uma classe fraca |
val_batch0_pred.jpg | Previsões em imagens reais de validação; procure erros sistemáticos de detecção |
labels.jpg | Contagens de classes e tamanhos das caixas delimitadoras usados no treinamento do modelo |
results.png | Curvas de perda e métricas; o aumento da perda de validação enquanto a perda de treinamento diminui indica sobreajuste |
Valide e diagnostique explica cada gráfico; aqui, a pergunta é sempre o que está faltando nos dados.
O ciclo com foco nos dados#
Uma iteração típica: escolha a classe mais fraca que tenha instâncias suficientes no conjunto de validação, audite cerca de 50 imagens que a contenham, corrija os dados, treine novamente com as mesmas configurações e divisão, e compare o AP por classe. Em seguida, passe para a próxima classe mais fraca.
Se você adicionar 300 imagens e aumentar imgsz no mesmo retreinamento, não conseguirá saber qual mudança alterou a pontuação. Mantenha as configurações e a divisão idênticas ao iterar sobre os dados, para que cada comparação isole uma mudança nos dados.
Quando recorrer aos hiperparâmetros#
Após duas ou três iterações com os dados, quando as classes fracas restantes já não puderem ser atribuídas a problemas de cobertura, rótulos ou definições, o ajuste fino pode render os últimos pontos. O guia de ajuste fino explica o congelamento de camadas, as taxas de aprendizado e a escolha do otimizador. Mas, se ajustar antes de os dados estarem corretos, você passará semanas otimizando um modelo para o conjunto de dados errado.
Quando um modelo passar em acceptance_test.py no conjunto de teste bloqueado, Ultralytics YOLO em produção explica a exportação e a disponibilização do modelo, enquanto Monitore a integridade e a precisão e Automatize o ciclo de retreinamento, em Crie com a Ultralytics Platform, explicam o ciclo de retreinamento.
Mostrar solução
Na execução de teste, cup é a classe que exige atenção: 14 rotuladas na validação, 0 encontradas, 10 não detectadas, 4 classificadas como outra classe. Um plano dimensionado:
| Constatação | Ação no conjunto de dados | Quantidade |
|---|---|---|
| 10 de 14 copos não detectados | Verifica a cobertura do conjunto de treino: conta as imagens de treino com copos por câmera e dia; coleta imagens de copos nos grupos que não têm nenhuma | 40 novas imagens com copos, distribuídas por 4 combinações de câmera e dia |
| 4 de 14 classificadas como outra classe | Abre essas imagens em val_batch0_pred.jpg e na matriz de confusão; se forem classificadas como wine glass ou bowl, adiciona ambas as classes parecidas à definição de cup | Rotula novamente cerca de 30 imagens de treino de acordo com a nova regra |
| Classes com 1 instância | Não faças nada ainda; adiciona grupos de validação que as contenham | Próxima rodada de coleta |
Depois, treina novamente com epochs, imgsz e a divisão inalterados, executa rank_classes.py outra vez e compara o AP de cup antes e depois. Se aumentar, os dados eram o gargalo; se não aumentar, audita as próximas 50 imagens antes de mexer em qualquer hiperparâmetro.
Comentários
Faça uma pergunta, compartilhe seus resultados ou ajude outra pessoa.