Descobre quando o conjunto de dados está pronto
Condiciona a primeira execução de treinamento a oito verificações de aprovação/reprovação, automatiza as três que um script pode verificar e identifica a correção necessária para cada falha.
Todo projeto chega ao momento em que a equipa quer treinar. Às vezes, o conjunto de dados está pronto; outras vezes, ainda tem vazamento entre divisões ou uma classe com poucas anotações, o que desperdiçará uma semana de tempo de GPU e produzirá um número em que ninguém deveria confiar. Oito verificações, cada uma avaliada como sim, não ou exceção documentada, tornam essa decisão objetiva em vez de depender do humor.
Prático
As oito verificações#
| # | Verificação | Critérios de aprovação | Se falhar, volta a |
|---|---|---|---|
| 1 | Objetivo claro | A meta, a tarefa, as classes e um teste de aceitação estão documentados e foram acordados | Começa pelo objetivo de negócio |
| 2 | Classes definidas | Cada classe tem uma definição e um exemplo semelhante que ela exclui, identificado pelo nome | Objetivo e guia de anotação |
| 3 | Imagens representativas | Cada cenário da especificação cumpre a sua cota, principalmente com imagens de fontes de produção | Recolhe dados representativos e de alta qualidade |
| 4 | Volume suficiente | ≥ 1.500 imagens e ≥ 10.000 instâncias por classe, ou uma exceção documentada | Especificação e recolha |
| 5 | Anotações consistentes | Guia escrito, rodada de calibração concluída, concordância ≥ 90% | Práticas recomendadas de anotação |
| 6 | Controle de qualidade concluído | Script de auditoria sem problemas, casos suspeitos analisados, notas de controle de qualidade escritas | Controle de qualidade do conjunto de dados |
| 7 | Divisões sem vazamento | Divisão agrupada, nenhum grupo presente em duas divisões, cada classe presente em todas as divisões | Divide o conjunto de dados corretamente |
| 8 | Imagens de fundo | 0–10% das imagens são quadros sem rótulos | Especificação e recolha |
A lista de verificação valida as mesmas decisões abordadas, uma a uma, no guia de recolha de dados e anotação; aqui, elas se tornam uma única decisão de avançar ou não.
Automatiza as verificações quantificáveis#
As verificações 4, 7 e 8 são aritméticas, então um script as avalia sempre da mesma forma. Este script lê o conjunto de prática e as listas de divisões criadas por group_split.py na lição anterior:
from collections import Counter
from pathlib import Path

root = Path("datasets/practice")  # images/, labels/, and the train/val/test.txt lists from group_split.py
splits = {s: [Path(p).stem for p in (root / f"{s}.txt").read_text().split()] for s in ("train", "val", "test")}

def classes(stem):
    label = root / "labels" / f"{stem}.txt"
    return [int(r.split()[0]) for r in label.read_text().splitlines() if r.strip()] if label.exists() else []

stems = [s for split in splits.values() for s in split]
instances = Counter(c for s in stems for c in classes(s))
images = Counter(c for s in stems for c in set(classes(s)))
background = sum(not classes(s) for s in stems) / len(stems)
groups = {split: {s.rsplit("_", 1)[0] for s in names} for split, names in splits.items()}
per_split = {split: {c for s in names for c in classes(s)} for split, names in splits.items()}
shared = (groups["train"] & groups["val"]) | (groups["train"] & groups["test"]) | (groups["val"] & groups["test"])
weakest = min(instances, key=lambda c: (images[c], instances[c]))

checks = {
    "4 volume": (images[weakest] >= 1500 and instances[weakest] >= 10_000,
                 f"weakest class {weakest}: {images[weakest]} images, {instances[weakest]} instances"),
    "7 no shared groups": (not shared, f"{len(shared)} groups appear in more than one split"),
    "7 every class in every split": (all(per_split[s] == set(instances) for s in splits),
                                     ", ".join(f"{s} misses {len(set(instances) - per_split[s])}" for s in splits)),
    "8 background 0-10%": (background <= 0.10, f"{background:.1%} background images"),
}
for name, (ok, detail) in checks.items():
    print(f"{'PASS' if ok else 'FAIL'}  {name:<29} {detail}")
FAIL 4 volume weakest class 30: 1 images, 1 instances
PASS 7 no shared groups 0 groups appear in more than one split
FAIL 7 every class in every split train misses 5, val misses 36, test misses 41
PASS 8 background 0-10% 1.6% background imagesA divisão agrupada corrigiu o vazamento, mas o conjunto de prática está longe de estar pronto: a classe mais fraca (30, skis) tem apenas uma instância anotada, e a validação não consegue avaliar metade das classes. Esse é o veredito esperado para 128 imagens de demonstração e exatamente o veredito que esta verificação deve fornecer antes de uma semana de treinamento.
O script cobre o que pode ser contado. As verificações 1, 2, 3, 5 e 6 precisam de uma pessoa: um objetivo acordado, definições por escrito, cobertura da especificação, uma pontuação de concordância medida e anotações de controle de qualidade. Avalie-as manualmente, com uma linha de evidência para cada uma.
Decide: treinar, avançar com uma lacuna ou corrigir#
Quando uma verificação falha, o próximo passo tentador quase sempre é algo diferente de corrigir os dados:
| Atalho tentador | Por que não funciona |
|---|---|
| "Experimenta um modelo maior." | Um modelo maior aprende o ruído dos rótulos com a mesma eficiência. |
| "Ajusta a taxa de aprendizagem." | Nenhuma configuração do otimizador adiciona uma classe ou um cenário ausente. |
| "Treina por mais épocas." | Mais épocas com dados limitados levam a um sobreajuste mais rápido. |
| "Adiciona mais aumento de dados." | O aumento de dados não consegue criar cenários que nunca estiveram presentes nos dados. |
Três padrões de conjuntos de dados quase prontos#
| Padrão | Verificação reprovada | Como se manifesta | Solução |
|---|---|---|---|
| Volume sem variedade | 3 | 5.000 imagens, uma câmera, nenhum caso extremo | Recolhe imagens de mais câmeras, locais e horários antes de treinar |
| Variedade sem consistência | 5 | Os anotadores discordam sobre a extensão das caixas e a oclusão | Finaliza o guia, calibra e reanota a amostra afetada |
| Vazamento oculto | 7 | Divisão aleatória por imagem em quadros de vídeo | Refaça a divisão por clipe, câmera ou dia; espere uma queda no mAP de validação, porque essa queda reflete a realidade |
Lance mesmo com uma lacuna conhecida#
Muitas vezes, a decisão certa é começar com um primeiro modelo focado antes de todas as verificações serem aprovadas: um piloto, um protótipo ou uma v1 em um subconjunto de câmeras. Um modelo em produção mostra o que realmente está errado mais rápido do que aprimorar o conjunto de dados às cegas. Quando lançar mesmo com uma lacuna, registre três coisas:
- Qual verificação falhou.
- O impacto esperado, por exemplo: "sem dados noturnos; espere uma redução na revocação após o anoitecer".
- O plano de coleta que resolve a lacuna enquanto a v1 está em execução.
"Volume: exceção" não informa nada à próxima pessoa. "Volume: pallet com 700 instâncias; espera-se menor revocação de paletes em áreas de baias congestionadas; mais 2.000 rotuladas até junho" é um risco gerenciado. Toda exceção precisa indicar o impacto esperado no teste de aceitação.
Repita as verificações antes de cada novo treinamento#
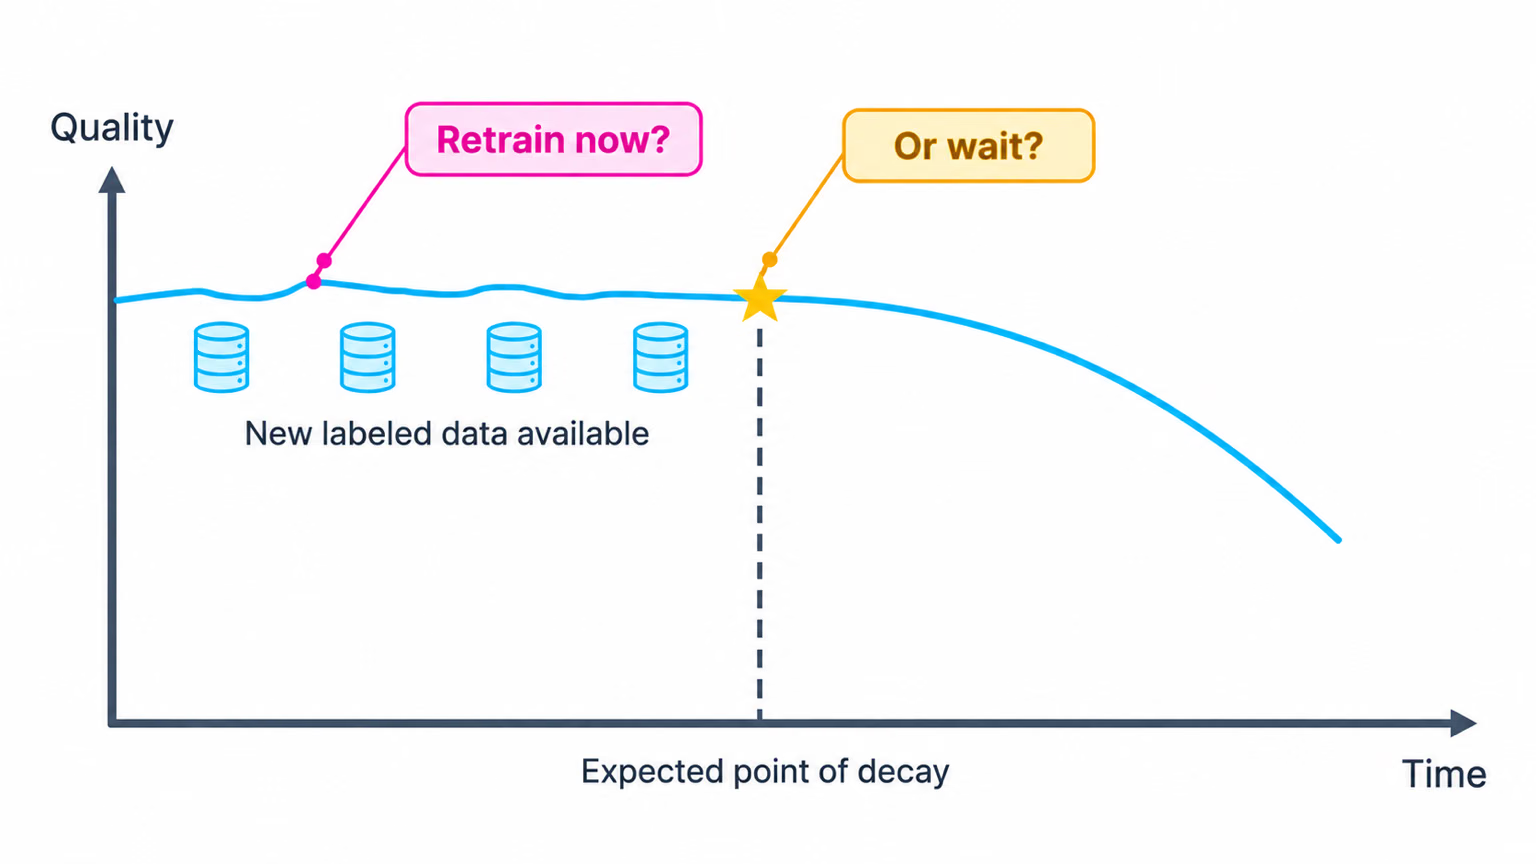
Um conjunto de dados que estava pronto para a v1 não está automaticamente pronto para a v3. Novas classes, novas fontes e novos anotadores podem fazer falhar verificações que antes eram aprovadas, enquanto os dados de produção mudam e novos rótulos se acumulam. Execute novamente readiness.py e reavalie manualmente as verificações antes de cada novo treinamento; isso leva minutos, e ignorá-las pode custar uma semana de treinamento em um conjunto de dados com problemas.
Mostrar solução
Uma lista de verificação pontuada para o conjunto de prática:
| # | Verificação | Pontuação | Evidência |
|---|---|---|---|
| 1 | Objetivo claro | sim | objective.md e acceptance_test.py da lição 1 |
| 2 | Classes definidas | não | Os 80 nomes do COCO não têm definições escritas nem exemplos parecidos excluídos |
| 3 | Imagens representativas | não | coverage.py: cam2–cam4 abaixo da cota |
| 4 | Volume suficiente | não | readiness.py: a classe mais fraca tem 1 imagem |
| 5 | Rótulos consistentes | não | Concordância de 47% na rodada de calibração |
| 6 | Controle de qualidade concluído | parcial | Auditoria executada; ainda há suspeitas pendentes em 000000000438.jpg |
| 7 | Divisões sem vazamento | não | Não há grupos compartilhados, mas o conjunto de validação não inclui 36 das 71 classes |
| 8 | Imagens de fundo | sim | 1.6% |
Decisão: corrigir primeiro. Prioridades segundo o risco para o teste de aceitação: (1) reduzir a lista às classes necessárias para o objetivo, o que melhora de uma vez as verificações 2, 4 e 7; (2) coletar mais grupos dessas classes; (3) concluir a regra do guia sobre pessoas distantes e refazer a rotulagem. Um conjunto para demonstração reprova nesta verificação, e é assim que deve ser.