Interpretar métricas de detecção com rigor
Execute a validação, analise precisão, revocação, mAP50-95, AP por classe e a matriz de confusão em conjunto, e escolha um limiar de implantação com base em uma meta.
Um único número é reconfortante: mAP 0.83, pronto. Mas o mesmo mAP pode esconder uma classe que falha metade das vezes, caixas consistentemente imprecisas ou um limiar que dispara um alerta a cada minuto. Você vai executar uma validação real e analisá-la linha por linha, até ela indicar o que corrigir e onde definir o limiar.
Prático
Como cada previsão é avaliada#
Na validação, cada caixa prevista é comparada com a verdade fundamental. Uma previsão é um verdadeiro positivo (TP) quando tem a classe correta e a IoU com uma caixa da verdade fundamental ainda não associada supera um limiar; caso contrário, é um falso positivo (FP). Cada objeto da verdade fundamental que não for associado é um falso negativo (FN).
| Métrica | Fórmula | Pergunta a que responde |
|---|---|---|
| Precisão | TP / (TP + FP) | Quando o modelo desenha uma caixa, com que frequência ela está correta? |
| Revocação | TP / (TP + FN) | Dos objetos reais, quantos ele encontrou? |
| F1 | 2 × P × R / (P + R) | Um número que equilibra ambos |
Reduzir o limiar de confiança adiciona caixas: a revocação aumenta e a precisão diminui. A curva precisão-revocação mostra essa relação em todos os limiares, e a área sob a curva é a precisão média (AP) de uma classe. mAP50 calcula a média do AP entre classes com IoU de 0.5, em que uma caixa visivelmente imprecisa ainda conta. mAP50-95 calcula a média em dez limiares de IoU, de 0.5 a 0.95, recompensando caixas mais precisas; é o principal número nas tabelas de modelos da Ultralytics.
Execute uma validação#
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
metrics = model.val(data="coco8.yaml")

print(f"precision={metrics.box.mp:.3f} recall={metrics.box.mr:.3f}")
print(f"mAP50={metrics.box.map50:.3f} mAP50-95={metrics.box.map:.3f}")
Class Images Instances Box(P R mAP50 mAP50-95)
all 4 17 0.551 0.962 0.943 0.669
person 3 10 0.551 0.8 0.848 0.387
dog 1 1 0.36 1 0.995 0.597
horse 1 2 0.36 1 0.995 0.696
elephant 1 2 0.656 0.969 0.828 0.545
umbrella 1 1 0.543 1 0.995 0.895
potted plant 1 1 0.833 1 0.995 0.895Leia de cima para baixo:
- Instâncias 17, imagens 4. COCO8 é um teste rápido. Quatro imagens não são suficientes para decidir se deve implantar; trate cada número como uma ilustração.
- mAP50 0.943 vs mAP50-95 0.669. A maioria dos objetos é encontrada, mas muitas caixas são imprecisas. Uma grande diferença indica que a localização, e não a detecção, é o ponto fraco.
personAP50-95 0.387. A classe mais comum é a mais fraca. Esse é o seu gargalo.- P 0.551, R 0.962. Estas colunas são lidas no único nível de confiança que maximiza o F1 entre as classes — um limiar baixo neste caso — e não em 0.25, o limiar usado nas suas previsões. Não as apresente como "a precisão do modelo".
AP por classe e o limiar de implantação#
A mesma execução contém o AP por classe e os valores de precisão e revocação em cada limiar de confiança, para que você possa escolher um limiar com base em uma meta, em vez de adivinhar:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
metrics = model.val(data="coco8.yaml", plots=False, verbose=False)
box = metrics.box

# Per-class AP from the same run: the average hides the weakest class
for i, c in enumerate(box.ap_class_index):
    print(f"{model.names[int(c)]:13} AP50={box.ap50[i]:.3f}  AP50-95={box.ap[i]:.3f}")

# Precision and recall at every confidence threshold for one class
row = list(box.ap_class_index).index(0)  # class 0 = person
for conf in (0.1, 0.25, 0.5, 0.75):
    j = int(conf * (len(box.px) - 1))
    print(f"person @ conf {conf:.2f}: precision {box.p_curve[row, j]:.2f}, recall {box.r_curve[row, j]:.2f}")
all 4 17 0.551 0.962 0.943 0.669
person AP50=0.848 AP50-95=0.387
dog AP50=0.995 AP50-95=0.597
horse AP50=0.995 AP50-95=0.696
elephant AP50=0.828 AP50-95=0.545
umbrella AP50=0.995 AP50-95=0.895
potted plant AP50=0.995 AP50-95=0.895
person @ conf 0.10: precision 0.63, recall 0.80
person @ conf 0.25: precision 1.00, recall 0.54
person @ conf 0.50: precision 1.00, recall 0.40
person @ conf 0.75: precision 1.00, recall 0.14Agora, o limiar é uma regra de decisão, não um palpite:
| Meta baseada na sua regra de decisão | Escolha | Nesta execução |
|---|---|---|
| No máximo 5% dos alertas podem ser falsos (precisão ≥ 0.95) | O menor limiar que atende à meta, para manter a maior revocação possível | 0.25: precisão 1.00, revocação 0.54 |
| Não deixe de encontrar mais de 1 em cada 5 pessoas (revocação ≥ 0.80) | O maior limiar que atende à meta, para manter a maior precisão possível | 0.10: precisão 0.63, revocação 0.80 |
Nenhum dos dois é bom o suficiente aqui: a alta precisão custa metade das pessoas, e a alta revocação custa um terço dos alertas. Essa é a evidência para "iterar", não um problema de limiar. A validação também salva BoxPR_curve.png, BoxP_curve.png, BoxR_curve.png, BoxF1_curve.png e confusion_matrix.png na pasta da execução, para que você possa observar a mesma relação nos gráficos; o guia de métricas de desempenho explica cada uma.
O que corrigir a seguir#
A matriz de confusão mostra com o que uma classe fraca é confundida. Se o AP de forklift for baixo e empilhadeiras forem previstas como pallet_jack, trata-se de confusão entre classes, não de localização: adicione exemplos que mostrem a diferença visual ou mescle as classes se nenhum código posterior precisar mantê-las separadas. O guia de insights da avaliação de modelos apresenta o fluxo de trabalho.
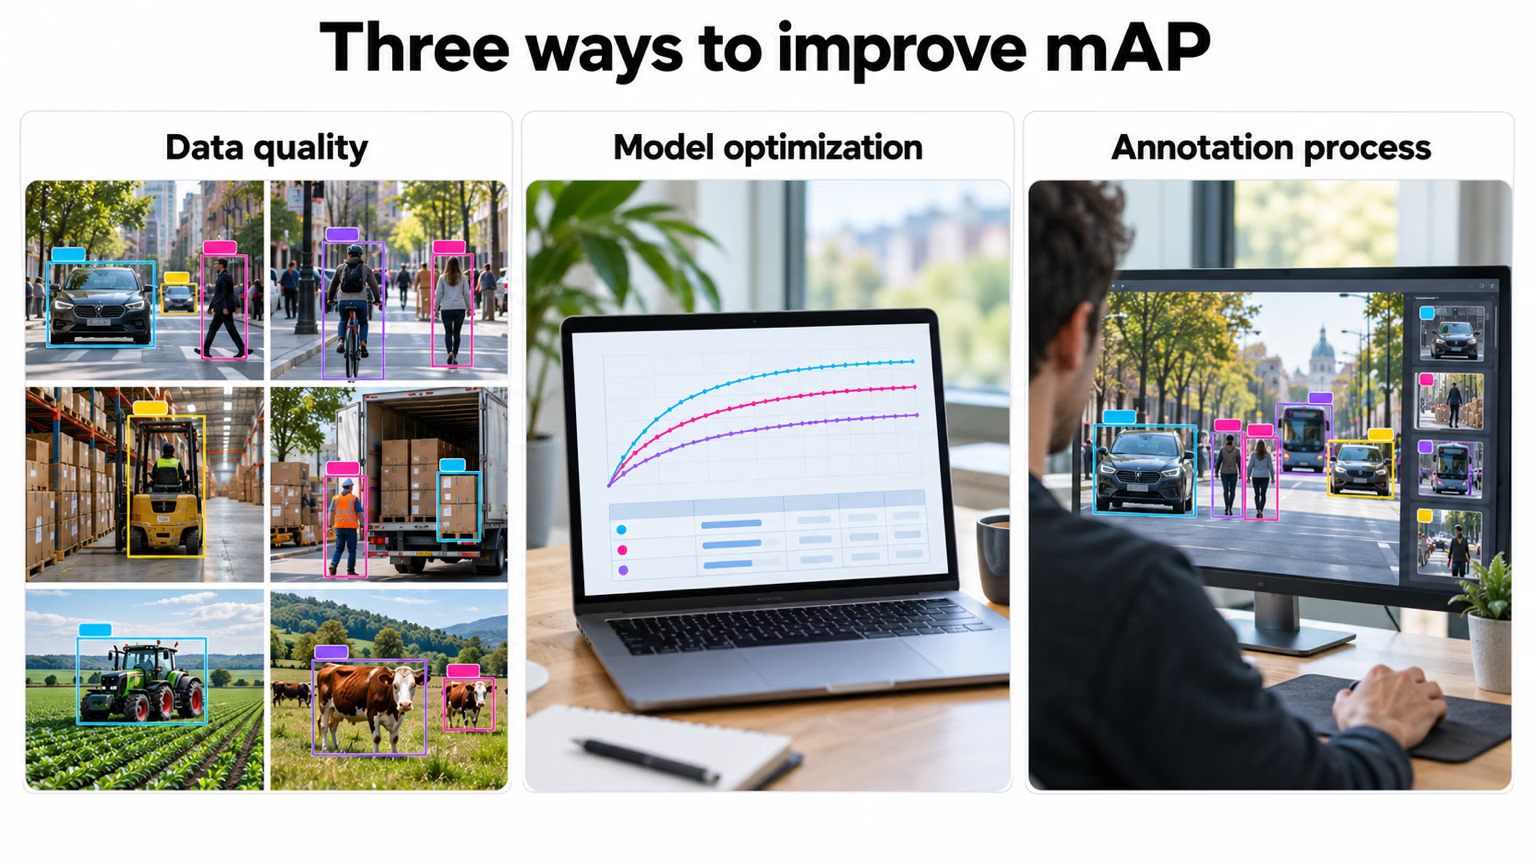
A maioria das correções se concentra no primeiro e no terceiro painéis: dados melhores e rótulos melhores para a classe gargalo. Só altere o modelo ou as configurações de treinamento depois que os dados passarem pelas verificações das três lições anteriores.
| Evidências em um conjunto de teste congelado | Decisão |
|---|---|
| Cada classe crítica para o negócio atende às metas de precisão e revocação | Implante e monitore |
| Uma classe ou condição não atinge a meta | Itere: dados e rótulos direcionados para corrigir essa lacuna |
| Todas as classes estão muito abaixo da meta ou há sobreposição visual entre elas | Repense a especificação da tarefa, as classes ou a configuração das câmeras |
Armadilhas#
Um mAP de 0,83 pode esconder uma classe com 0,40. Se essa classe concentra o valor do negócio, você não tem um modelo de 0,83 — tem um modelo com falhas e uma média enganadora.
Sintoma: um modelo que "marca 0,94" desenha caixas demasiado frouxas para medição ou recorte. Solução: informe mAP50-95 e interprete a diferença em relação a mAP50 como um sinal de localização.
Sintoma: números aparentemente perfeitos com algumas dezenas de imagens ou com imagens quase idênticas às do conjunto de treinamento. Solução: aumente o conjunto de validação para algumas centenas de instâncias por classe importante e execute a verificação de quase duplicatas da lição anterior antes de analisar qualquer métrica.
Mostrar solução
Leitura: contador de pessoas em yolo26n.pt, validação do COCO8
O gargalo é person, com AP50-95 de 0.387 face a um valor geral de 0.669. Também é a classe com mais instâncias (10 de 17), por isso é simultaneamente a mais fraca e a mais importante para um contador de pessoas. O AP50 é 0.848, portanto o modelo deteta a maioria das pessoas, mas desenha caixas imprecisas — o que importa menos para a contagem do que para qualquer tarefa que meça posição ou tamanho.
Para uma precisão ≥ 0.95, o limiar qualificável mais baixo é conf 0.25, com precisão de 1.00, mas recall de apenas 0.54: o contador deixaria escapar quase metade das pessoas. Para um recall ≥ 0.80, precisaríamos de conf 0.10, em que um terço das contagens seria falso.
Decisão: iterar. Recolhe e rotula imagens de pessoas da câmara de implementação — sobretudo pessoas pequenas, oclusas e nas margens do enquadramento — e volta a validar num conjunto de teste congelado com algumas centenas de pessoas. Quatro imagens de validação não são suficientes para decidir se deves avançar ou não.