Caixas vs. máscaras: quando você realmente precisa de segmentação
Meça o que uma máscara acrescenta em relação a uma caixa numa imagem real e decida, com base no sistema que vai consumir os dados, se o projeto precisa mesmo do formato.
Máscaras são o que a maioria das pessoas imagina quando pensa em visão computacional com IA, e são onde as equipes gastam a maior parte do orçamento de rotulagem. Uma máscara mostra o formato exato de um objeto; uma caixa mostra apenas onde ele está. Essa diferença é decisiva para alguns produtos — e não muda nada para a maioria deles.
Prático
O que uma máscara acrescenta#
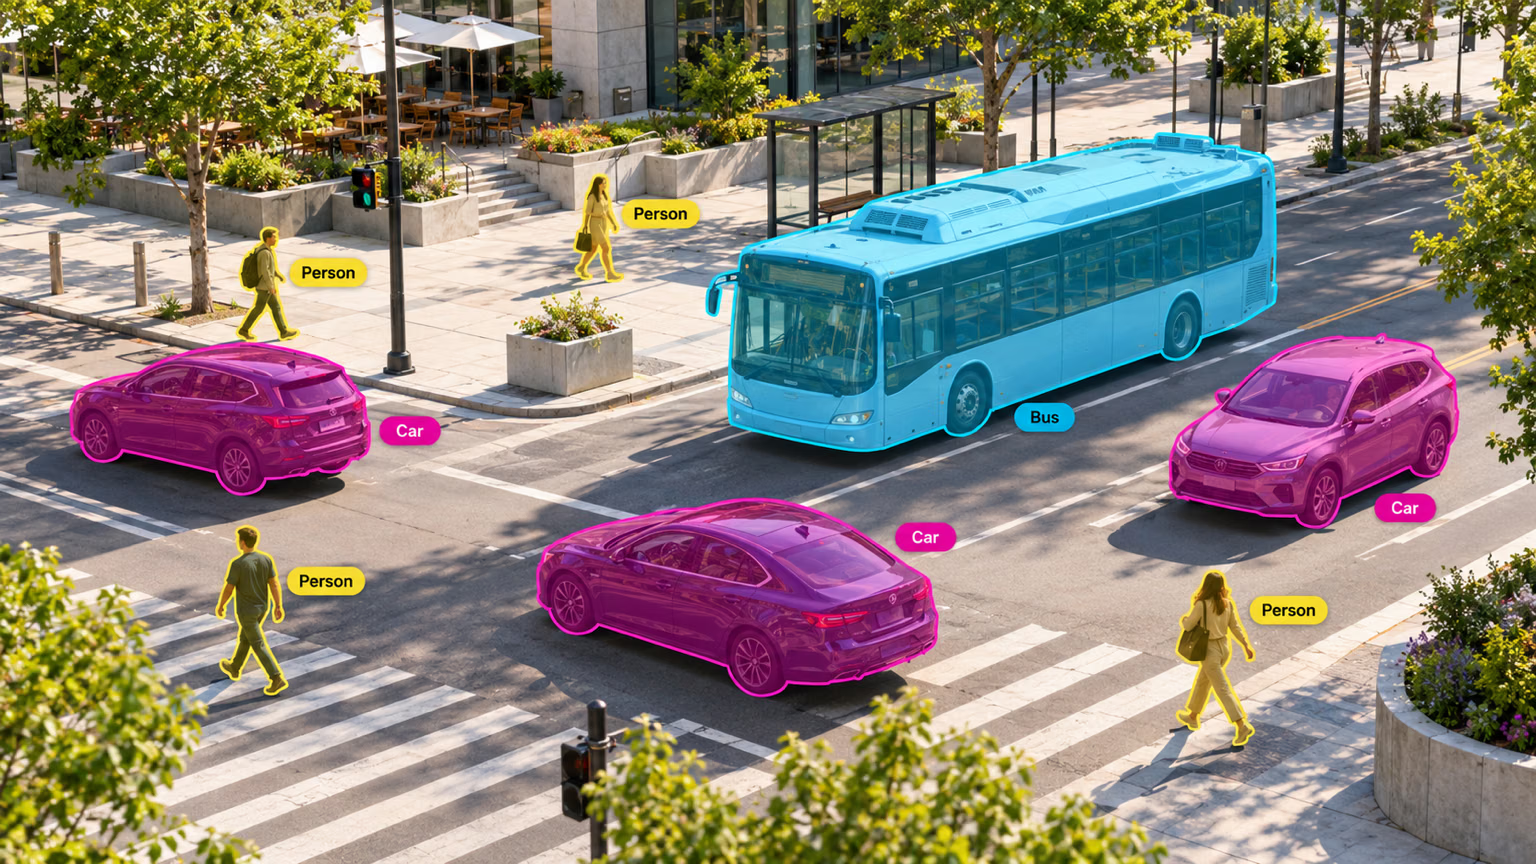
Para cada objeto, a tarefa Segment retorna tudo o que um detector retorna — classe, caixa, confiança — além dos pixels que pertencem ao objeto. Assim, cada carro acima recebe seu próprio contorno, separado do ônibus e das pessoas. Leia a máscara como um polígono (masks.xy) ou como uma imagem binária (masks.data).
Quanto o formato altera os números? Compare a área da caixa de cada objeto com a área da máscara:
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
result = model("https://ultralytics.com/images/bus.jpg", retina_masks=True, verbose=False)[0]

for box, mask in zip(result.boxes, result.masks.data):
    x1, y1, x2, y2 = box.xyxy[0].tolist()
    box_area = (x2 - x1) * (y2 - y1)
    mask_area = float(mask.sum())  # pixels inside the object's mask
    name, ratio = result.names[int(box.cls)], mask_area / box_area
    print(f"{name:7} box={box_area:7.0f} px  mask={mask_area:7.0f} px  ({ratio:.0%})")
person box= 97116 px mask= 49331 px (51%)
person box= 68102 px mask= 21316 px (31%)
bus box= 410093 px mask= 255265 px (62%)
person box= 55998 px mask= 33524 px (60%)
person box= 23690 px mask= 11109 px (47%)O ônibus ocupa apenas 62% da caixa, e uma pessoa ocupa 31%. Qualquer número calculado apenas com caixas — área pintada, tamanho de um derramamento, quanto espaço vazio há numa prateleira — terá esse nível de erro. Se o produto informa um número desse tipo, você precisa de máscaras. Se ele apenas conta ou localiza objetos, os pixels adicionais não mudam nada.
Sintoma: áreas de máscara que parecem 3–4× pequenas demais em comparação com as áreas das caixas. Causa: por padrão, masks.data retorna na resolução de inferência (aqui, 640×480), enquanto as caixas estão em pixels da imagem original (1080×810). Solução: passe retina_masks=True, como acima, ou ajuste as contagens você mesmo.
Decida com base no sistema consumidor, não na demonstração#
| Necessidade do sistema seguinte | Caixas são suficientes? | Por quê |
|---|---|---|
| Contar objetos ou verificar presença | Sim | A localização é a resposta completa |
| Enviar um alerta quando um objeto entrar numa zona | Sim | Basta uma caixa cruzar uma linha |
| Rastrear objetos entre quadros | Sim | Os rastreadores associam caixas |
| Recortar para um segundo classificador | Sim | Para um recorte, basta a caixa |
| Medir área ou cobertura (ervas daninhas, ferrugem, derramamentos) | Não | Formatos irregulares tornam a área da caixa sem sentido |
| Recortar o objeto (remoção do fundo, RA) | Não | Você precisa do contorno exato |
| Verificar distância livre ou contato (agarramento robótico, colisão) | Não | A caixa superestima o tamanho do objeto |
| Separar objetos irregulares que se tocam | Muitas vezes, não | Caixas sobrepostas deixam indefinido a quem pertencem os pixels |
Se todas as linhas de que o seu produto precisa dizem "sim", coloque um detector em produção. Recorra à segmentação com YOLO26 somente quando o formato justificar o custo.
Segmentação de instâncias vs. semântica#
A segmentação de instâncias atribui uma máscara própria a cada objeto, então três carros sobrepostos continuam sendo três carros. A segmentação semântica atribui uma classe a cada pixel e nada mais: todos os pixels de carros formam uma única região "carro", e a contagem desaparece. Para contar ou medir objetos individuais — células, frutas, defeitos — use segmentação de instâncias. Para medir a cobertura de regiões — estrada versus calçada, plantação versus solo — use segmentação semântica.
O custo de rotular o formato#
Uma caixa exige dois cliques. Um bom polígono pode exigir dezenas, e cada contorno é um ponto de possível discordância entre anotadores: a bolsa faz parte da pessoa? A sombra faz parte do carro? Meça o seu próprio custo em vez de confiar numa regra geral: cronometre a anotação de 20 objetos como caixas e dos mesmos 20 como polígonos, depois multiplique a diferença pelo tamanho do conjunto de dados.
Ferramentas assistidas por IA reduzem bastante essa diferença. A anotação inteligente e rotulagem em lote propõe uma máscara a partir de um clique ou de uma caixa, para que os anotadores corrijam os contornos em vez de desenhá-los — mas alguém ainda precisa revisar cada limite.
Decida como lidar com oclusões, objetos transparentes, sombras, objetos cortados pela borda do quadro e itens anexados (bolsas, alças, cargas) antes de começar a rotulagem, e entregue a mesma página aos anotadores e revisores. Melhores práticas de anotação explica como aplicar essas regras; o conjunto de dados COCO-Seg mostra máscaras consistentes em escala.
Ao verificar máscaras por amostragem, procure por vazamento (a máscara ultrapassa o contorno), lacunas (regiões dentro do objeto não detectadas), contornos fantasma (a máscara acompanha um artefato JPEG) e partes ambíguas (a alça da mala faz parte da máscara da mala?).
Mostrar solução
Imagine que dois produtos compartilham a câmera do ônibus: um contador de pessoas e um relatório de ocupação da rua que informa quanto da cena é coberto por veículos. Meça as duas respostas na mesma execução:
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
result = model("https://ultralytics.com/images/bus.jpg", retina_masks=True, verbose=False)[0]
height, width = result.orig_shape

for name in sorted({result.names[int(c)] for c in result.boxes.cls}):
    rows = [i for i, c in enumerate(result.boxes.cls) if result.names[int(c)] == name]
    union = result.masks.data[rows].amax(dim=0)  # merge masks so overlaps count once
    box_union = sum(float((b[2] - b[0]) * (b[3] - b[1])) for b in result.boxes.xyxy[rows])
    print(f"{name:6} {len(rows)} objects | masks cover {float(union.sum()) / (height * width):.0%} of the image, boxes {box_union / (height * width):.0%}")
bus 1 objects | masks cover 29% of the image, boxes 47%
person 4 objects | masks cover 13% of the image, boxes 28%- Contador de pessoas → caixas. A contagem é 4 nos dois casos; as máscaras aumentam o custo de rotulagem e não mudam nada.
- Relatório de ocupação → máscaras. As caixas indicam que o ônibus cobre 47% da cena; na realidade, ele cobre 29%. Um relatório baseado em caixas teria um erro superior à metade.