Qualidade das anotações
Descobre o que contém um rótulo YOLO, verifica os ficheiros de rótulos em busca de linhas inválidas e mantém a consistência entre anotadores com uma diretriz e uma ronda de calibração medida.
Um modelo treinado com rótulos inconsistentes aprende essa inconsistência. Cinquenta mil caixas desenhadas segundo uma regra clara superam meio milhão desenhadas com vinte interpretações pessoais, e quase sempre é mais barato voltar a rotular do que usar um modelo maior. Nesta lição, vais criar um verificador de rótulos, uma diretriz de uma página e uma medida de concordância entre anotadores.
Prático
O que é realmente um rótulo#
No formato YOLO, cada imagem tem um ficheiro .txt correspondente, com uma linha por objeto. As coordenadas são normalizadas de 0 a 1 pela largura e altura da imagem, para que os rótulos continuem válidos após o redimensionamento. A estrutura da linha depende da tarefa:
| Tarefa | Um rótulo | Notas |
|---|---|---|
| Detecção | class x_center y_center width height | Centro e tamanho da caixa |
| Segmentação de instâncias | class x1 y1 x2 y2 ... xn yn | Contorno do polígono |
| Pose | class x y w h px1 py1 v1 ... pxn pyn vn | Caixa, seguida dos pontos-chave com visibilidade opcional |
| OBB | class x1 y1 x2 y2 x3 y3 x4 y4 | Quatro cantos da caixa rodada |
| Classificação | Sem ficheiro de rótulos | Imagens organizadas numa pasta por classe |
| Segmentação semântica | Uma máscara PNG por imagem | Cada valor de píxel é um índice de classe |
| Estimativa de profundidade | Um PNG ou NPY de profundidade por imagem | Cada valor de píxel é uma distância |
Os índices de classe começam em 0 e correspondem aos nomes no YAML do conjunto de dados. Uma imagem sem objetos não precisa de ficheiro de rótulos — é assim que funcionam as imagens de fundo. As páginas de conjuntos de dados de formato de deteção, segmentação semântica e profundidade incluem exemplos práticos.
Verifica os teus ficheiros de rótulos#
Linhas inválidas passam despercebidas: uma coordenada superior a 1, um ID de classe não definido no YAML ou o mesmo objeto delimitado duas vezes tornam-se ruído que o modelo tenta aprender. Um verificador simples deteta esses problemas antes do treino:
from itertools import combinations
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

def iou(a, b):
    """IoU of two normalized (x_center, y_center, width, height) boxes."""
    ax1, ay1, ax2, ay2 = a[0] - a[2] / 2, a[1] - a[3] / 2, a[0] + a[2] / 2, a[1] + a[3] / 2
    bx1, by1, bx2, by2 = b[0] - b[2] / 2, b[1] - b[3] / 2, b[0] + b[2] / 2, b[1] + b[3] / 2
    inter = max(0, min(ax2, bx2) - max(ax1, bx1)) * max(0, min(ay2, by2) - max(ay1, by1))
    return inter / (a[2] * a[3] + b[2] * b[3] - inter)

def check_labels(text, names):
    """Return a list of problems in one YOLO detection label file."""
    problems, boxes = [], []
    for i, row in enumerate(text.split("\n"), 1):
        values = row.split()
        if not values:
            continue
        if len(values) != 5:
            problems.append(f"row {i}: {len(values)} values, expected 5")
        elif int(values[0]) not in names:
            problems.append(f"row {i}: unknown class {values[0]}")
        elif not all(0 <= float(v) <= 1 for v in values[1:]):
            problems.append(f"row {i}: coordinates outside 0-1")
        else:
            boxes.append((i, int(values[0]), [float(v) for v in values[1:]]))
    for (i, ca, a), (j, cb, b) in combinations(boxes, 2):
        if ca == cb and iou(a, b) > 0.8:
            problems.append(f"row {j}: duplicate of row {i} (IoU {iou(a, b):.2f})")
    return problems

broken = "0 0.50 0.50 0.20 0.30\n0 0.51 0.50 0.20 0.30\n3 0.40 0.40 0.10 0.10\n0 1.20 0.50 0.10 0.10\n0 0.50 0.50 0.10"
print("\n".join(check_labels(broken, {0: "pill"})))

data = check_det_dataset("medical-pills.yaml")
files = sorted(Path(data["path"], "labels").rglob("*.txt"))
found = sum(len(check_labels(f.read_text(), data["names"])) for f in files)
print(f"medical-pills: {found} problems in {len(files)} label files")
row 3: unknown class 3
row 4: coordinates outside 0-1
row 5: 4 values, expected 5
row 2: duplicate of row 1 (IoU 0.90)
medical-pills: 0 problems in 115 label filesO exemplo criado manualmente mostra cada erro que o verificador deteta; o conjunto de dados real passa sem problemas. Executa-o depois de cada lote de anotações e antes de cada treino — demora apenas alguns segundos.
Porque é que os rótulos divergem#
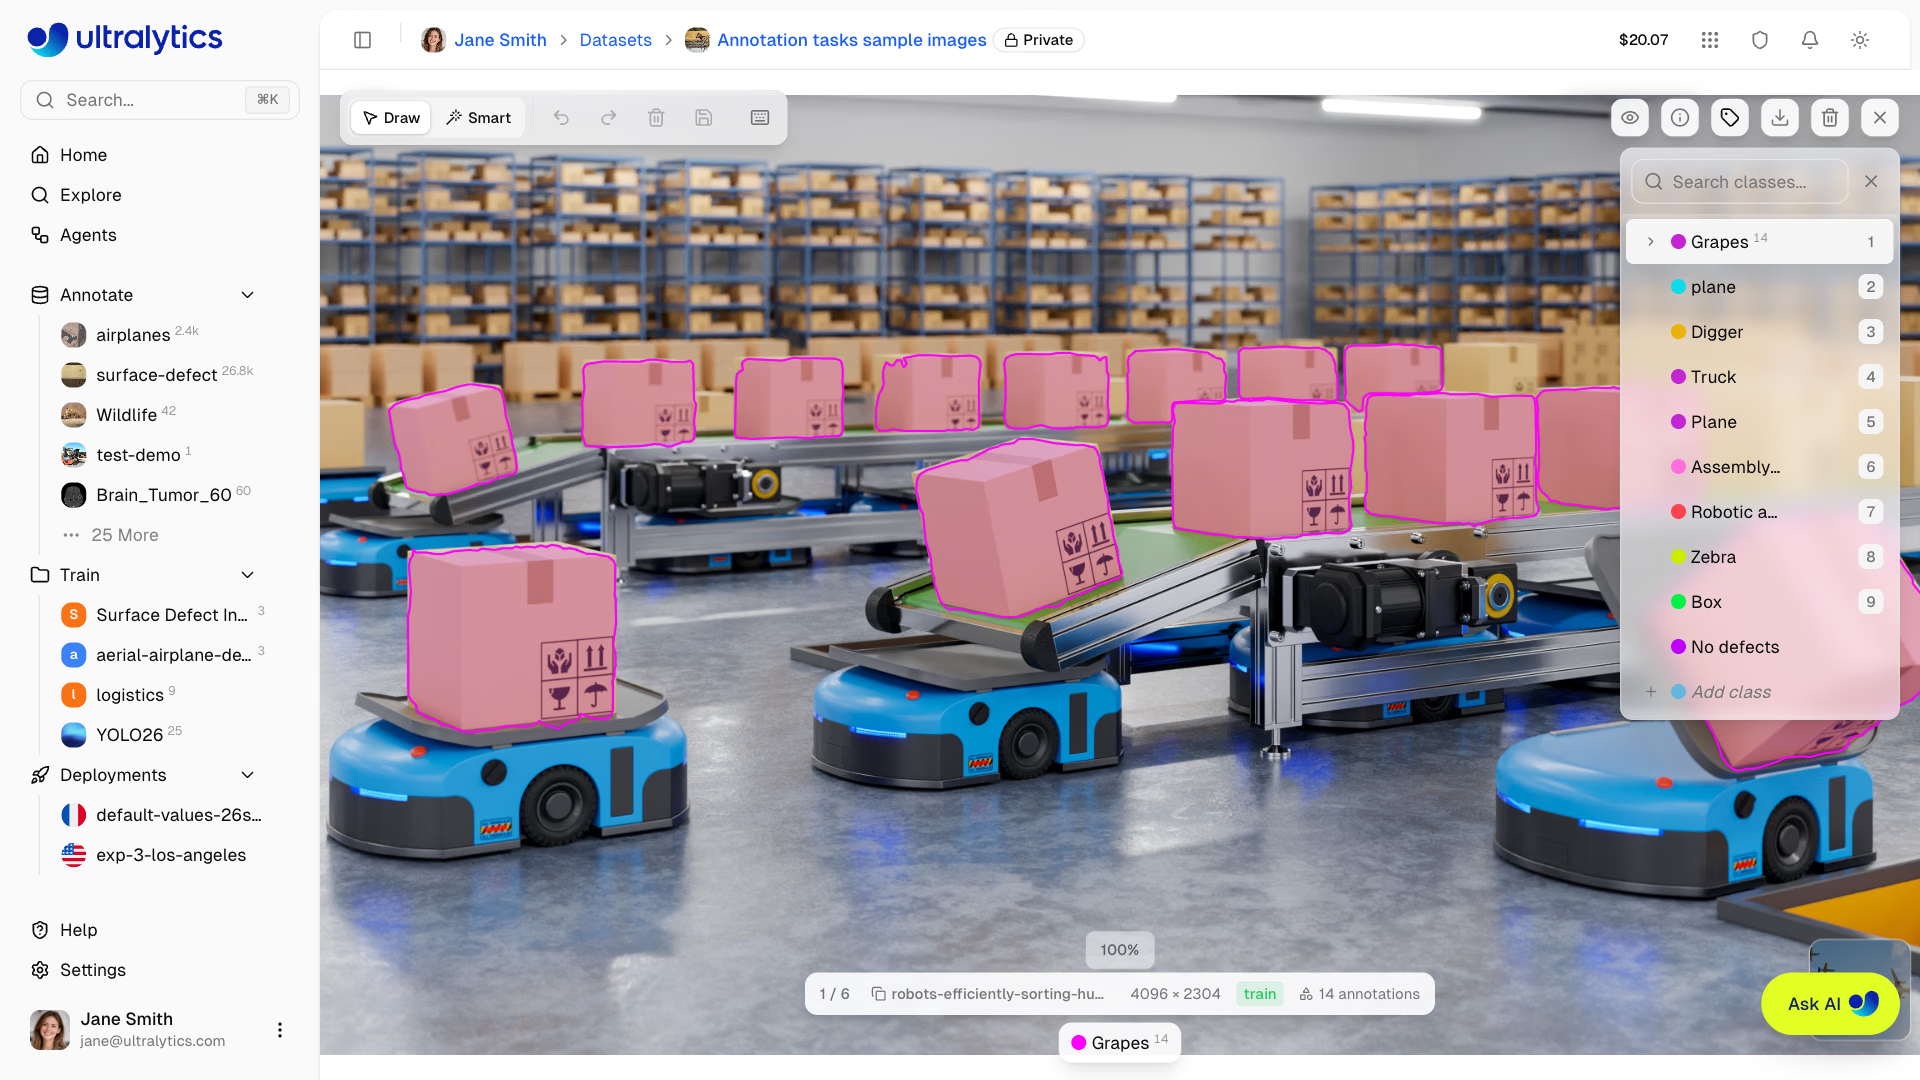
Observa o painel de classes neste editor: os 14 polígonos das caixas de cartão estão guardados em Grapes, enquanto uma classe Box aparece mais abaixo na lista — e plane e Plane existem como duas classes distintas. Um verificador não deteta nenhum destes problemas, porque todas as linhas são válidas, mas um revisor que compare os rótulos com a diretriz identificaria ambos em segundos. A maioria dos erros de rotulagem é assim: ficheiros válidos, decisões erradas.
Raramente os anotadores rotulam mal por falta de cuidado. Rotulam de forma inconsistente porque as regras são ambíguas e cada um faz uma suposição razoável, mas diferente:
- Onde deve terminar a caixa? Na sombra, num saco transportado, na carga dos garfos de um empilhador?
- Truncamento. Uma pessoa que aparece parcialmente fora do enquadramento continua a ser
person? A partir de que fração visível? - Oclusão. Um carro visível apenas por uma roda deve ser rotulado ou ignorado?
- Limites entre classes. Uma carrinha de caixa aberta é
caroutruck? Uma scooter ébicycleouother? - Casos a não rotular. Reflexos, cartazes e ecrãs que mostram o objeto.
Cada escolha é válida, desde que todos façam a mesma.
Uma diretriz de uma página#
Cabe numa página, inclui uma imagem de exemplo para cada regra e apresenta primeiro os casos-limite:
## Class: forklift

Include:
- Forklifts with at least 30% of the body visible, moving or parked, any size or color.

Do not label:
- Pallet jacks (no overhead mast) → class `pallet_jack`.
- Reflections in glass or polished floors, and forklifts on posters or screens.

Box rules:
- Include the mast and the full visible body.
- Exclude the load (pallets, boxes) — those have their own classes.
- For partly occluded forklifts, box the visible part only.
Mede a concordância numa ronda de calibração#
Antes de passar de um para vinte anotadores, todos rotulam as mesmas 50 imagens e tu comparas os resultados:
A concordância é a proporção de objetos que ambos os anotadores desenharam com a mesma classe e um IoU de, pelo menos, 0.5 — a versão prática da fiabilidade entre avaliadores:
def iou(a, b):
    """IoU of two (x1, y1, x2, y2) pixel boxes."""
    w = max(0, min(a[2], b[2]) - max(a[0], b[0]))
    h = max(0, min(a[3], b[3]) - max(a[1], b[1]))
    inter = w * h
    return inter / ((a[2] - a[0]) * (a[3] - a[1]) + (b[2] - b[0]) * (b[3] - b[1]) - inter)

def agreement(boxes_a, boxes_b, threshold=0.5):
    """Share of objects both annotators drew with the same class and IoU >= threshold."""
    unmatched, matched = list(boxes_b), 0
    for cls_a, box_a in boxes_a:
        best = max(unmatched, key=lambda b: iou(box_a, b[1]) if b[0] == cls_a else -1, default=None)
        if best and best[0] == cls_a and iou(box_a, best[1]) >= threshold:
            unmatched.remove(best)
            matched += 1
    return matched / max(len(boxes_a), len(boxes_b))

# Two annotators label the same calibration image
alice = [("forklift", (100, 200, 400, 600)), ("person", (450, 220, 520, 480)), ("person", (600, 230, 660, 470))]
bob = [("forklift", (100, 120, 400, 600)), ("person", (452, 218, 522, 478)), ("pallet_jack", (600, 230, 660, 470))]
print(f"agreement: {agreement(alice, bob):.0%}")
agreement: 67%Há dois tipos de divergência escondidos nesses 67%. A caixa do empilhador do Bob começa 80 píxeis mais acima — ele incluiu a ponta do mastro —, mas ainda corresponde com IoU 0.83, por isso conta como concordância; aperfeiçoa a regra das caixas se o teu produto medir a altura. O terceiro objeto é um conflito real: a Alice diz person, o Bob diz pallet_jack. Isso exige uma regra mais clara e uma imagem de exemplo, seguidas de outra ronda. Guarda as 50 imagens de calibração: tornam-se o teste de integração para cada novo anotador.
Um revisor que corrige rótulos discretamente elimina o ciclo de feedback, e os anotadores nunca aprendem o que fizeram de errado. Rejeite com um motivo e deixe o anotador corrigir. É mais lento nas primeiras cem imagens, mas muito mais rápido depois.
O que acompanhar#
| Métrica | O que indica |
|---|---|
| Ritmo (objetos por hora) | Capacidade e custo |
| Taxa de rejeição | Se a qualidade está a piorar |
| Concordância num conjunto partilhado de sobreposições | Se os anotadores continuam a aplicar as mesmas regras |
Quando a concordância diminui, algo mudou: um novo anotador, uma nova câmara, um lote ambíguo ou fadiga. Quando o modelo falhar mais tarde numa condição específica, envia essas mesmas imagens de volta para serem rotuladas — é o ciclo que a aprendizagem ativa automatiza e de onde vêm a maioria dos ganhos de precisão no mundo real. Explora e filtra as falhas nos teus conjuntos de dados na Ultralytics Platform e consulta Controlo de qualidade de conjuntos de dados e Práticas recomendadas para anotações para executar este processo em grande escala.
Mostrar solução
Uma diretriz para a classe pill de medical-pills, escrita após uma ronda de calibração com 10 imagens:
## Class: pill

Include:
- Every tablet inside a blister cavity, including half-visible ones at the image edge.
- Tablets seen through clear plastic, even when glare covers part of them.

Do not label:
- Empty cavities, torn foil, or tablets outside the pack.
- Reflections of tablets in the foil.

Box rules:
- Box the tablet itself, not the plastic bubble around it.
- If two tablets touch, draw two boxes.
Como interpretar a pontuação de concordância: imagina que a primeira ronda obtém 82%. Ordena os objetos sem correspondência por causa. Nos blisters, as duas causas mais comuns são caixas desenhadas à volta da bolha de plástico em vez do comprimido (corrigido pela primeira regra sobre caixas, com uma imagem de exemplo) e comprimidos cobertos por reflexos que um anotador ignorou (corrigido pela segunda regra de inclusão). Repete o processo com 10 imagens novas; só aumenta a escala quando a pontuação ultrapassar o limite de 90%.