Define o problema
Transforma uma ideia vaga de produto numa especificação de tarefa de três linhas e mantém a regra de negócio no código, onde podes alterá-la sem voltar a treinar.
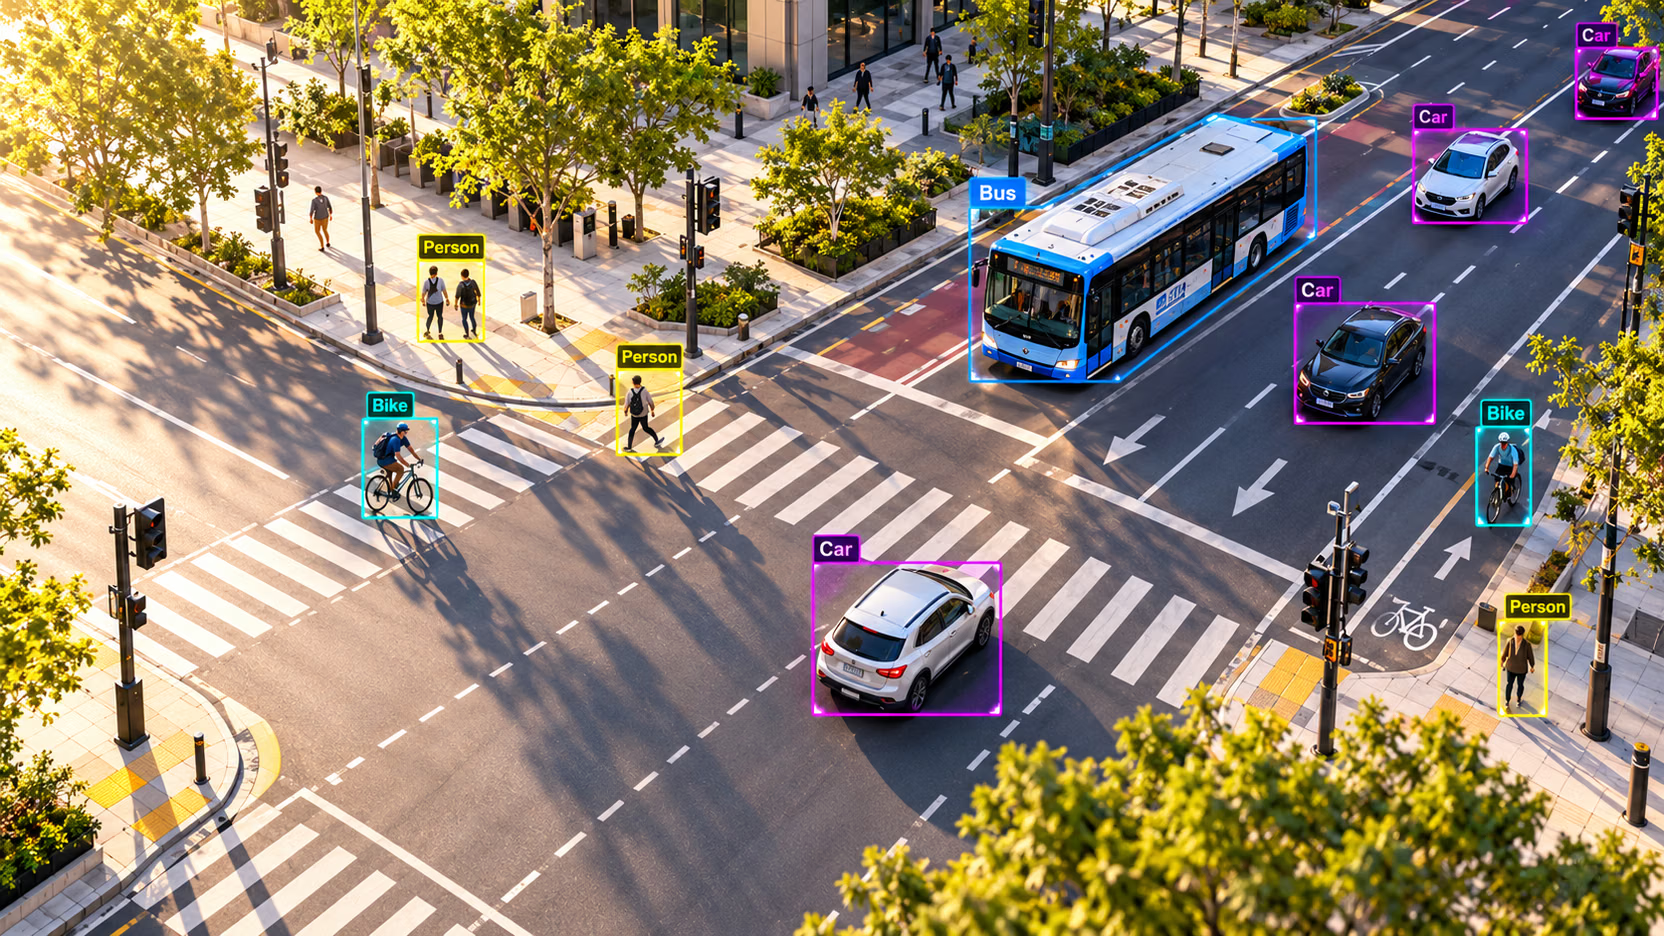
A maioria dos projetos de visão computacional que ficam pelo caminho nunca teve uma pergunta clara. «Detetar comportamentos inseguros» parece um requisito, mas um anotador não consegue rotulá-lo, um modelo não consegue aprendê-lo e ninguém consegue determinar quando funciona. Uma especificação de três linhas resolve isso numa tarde — e determina que tarefa vais treinar, o que vais rotular e que métrica vais comunicar.
Prático
Porque é que a especificação vem primeiro#
Cada etapa de um projeto de visão computacional herda o seu objetivo da etapa 0. Uma pergunta vaga produz um conjunto de dados vago, anotadores que discordam e uma métrica que mede a coisa errada — e nenhum treino na etapa 2 consegue corrigir isso.
As três linhas#
Uma especificação de tarefa consiste em três frases, uma por linha. Cada uma responde a uma pergunta que uma pessoa diferente do projeto fará:
| Linha | Pergunta a que responde | Fraca | Forte |
|---|---|---|---|
| Entrada | O que vê o modelo? | «Imagens de câmaras» | «Fotogramas de 1920×1080 a 5 fps, de 12 câmaras instaladas no teto» |
| Saída | Que dados são devolvidos? | «Detetar problemas de segurança» | «Caixas para forklift e person, cada uma com uma pontuação de confiança» |
| Decisão | Quem age e quando? | «Melhorar a segurança» | «Notificar o supervisor do turno quando um empilhador e uma pessoa estiverem a menos de 2 m durante 2 s» |
A linha da saída exige mais atenção, porque o tipo de dados determina a tarefa:

Um rótulo para a imagem inteira significa classificação; caixas significam deteção; contornos significam segmentação; articulações significam pose; caixas rodadas significam OBB; uma classe ou uma distância por píxel significa segmentação semântica ou profundidade. A próxima lição aborda as sete tarefas.
Exemplo trabalhado: mantém o modelo e a regra separados#
«Queremos saber quando os empilhadores estão a fazer algo perigoso no armazém.»
Essa frase descreve um projeto, não uma tarefa. Mistura duas funções: encontrar empilhadores e pessoas, o que diz respeito aos píxeis, e decidir o que é perigoso, o que diz respeito à política. Separa-as:
Só o detetor é o modelo. O losango é apenas código. Podes testar esta separação agora: bus.jpg não tem empilhadores, mas um autocarro e quatro pessoas permitem fazer o mesmo teste. Uma primeira regra diz «alertar quando mais de 30% da caixa de uma pessoa se sobrepõe à caixa de um veículo»:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
result = model("https://ultralytics.com/images/bus.jpg", verbose=False)[0]

# The model's job ends here: a class, a box, and a confidence per object.
people = [b.xyxy[0].tolist() for b in result.boxes if result.names[int(b.cls)] == "person"]
vehicles = [b.xyxy[0].tolist() for b in result.boxes if result.names[int(b.cls)] == "bus"]

def share_inside(a, b):
    """Fraction of box a's area that lies inside box b."""
    w = max(0, min(a[2], b[2]) - max(a[0], b[0]))
    h = max(0, min(a[3], b[3]) - max(a[1], b[1]))
    return w * h / ((a[2] - a[0]) * (a[3] - a[1]))

# The decision rule is plain code: change the policy without retraining.
ALERT_SHARE = 0.30
for person in people:
    share = max(share_inside(person, v) for v in vehicles)
    print(f"person at x={person[0]:3.0f}: {share:4.0%} inside the bus box -> {'ALERT' if share > ALERT_SHARE else 'ok'}")
person at x= 49: 70% inside the bus box -> ALERT
person at x=223: 76% inside the bus box -> ALERT
person at x=670: 70% inside the bus box -> ALERT
person at x= 0: 62% inside the bus box -> ALERTQuatro alertas, todos falsos: as pessoas estão no passeio, à frente de um autocarro estacionado. O detetor está certo em relação a todas as caixas; a regra está errada, porque a sobreposição numa imagem 2D não significa que duas coisas estejam próximas no mundo real. Como a regra é código, a correção também é código. Compara o ponto onde os pés de cada pessoa tocam no chão com a linha das rodas do autocarro:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
result = model("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
people = [b.xyxy[0].tolist() for b in result.boxes if result.names[int(b.cls)] == "person"]
vehicles = [b.xyxy[0].tolist() for b in result.boxes if result.names[int(b.cls)] == "bus"]

def same_ground_line(person, vehicle, tolerance=40):
    """True when the person's feet are level with the vehicle's wheels and inside its width."""
    feet_x, feet_y = (person[0] + person[2]) / 2, person[3]
    return vehicle[0] < feet_x < vehicle[2] and abs(feet_y - vehicle[3]) < tolerance

for person in people:
    alert = any(same_ground_line(person, v) for v in vehicles)
    print(f"person at x={person[0]:3.0f}: feet y={person[3]:.0f}, bus wheels y={vehicles[0][3]:.0f} -> {'ALERT' if alert else 'ok'}")
person at x= 49: feet y=902, bus wheels y=751 -> ok
person at x=223: feet y=861, bus wheels y=751 -> ok
person at x=670: feet y=880, bus wheels y=751 -> ok
person at x= 0: feet y=871, bus wheels y=751 -> okOs pés de todas as pessoas estão 110–150 píxeis abaixo da linha das rodas, por isso estão mais perto da câmara do que o autocarro. Sem voltar a treinar nem a rotular: a equipa de segurança pode iterar na regra enquanto o detetor permanece fixo. Uma versão de produção mapearia os pés para coordenadas do chão com uma câmara calibrada e acrescentaria a persistência de 2 segundos através do rastreamento de objetos — ainda seria código sobre as mesmas caixas.
Palavras subjetivas — "inseguro", "defeituoso", "suspeito", "VIP" — pertencem ao código que lê a saída do modelo. Um modelo responde a perguntas sobre pixels. Se dois especialistas discutiriam sobre um rótulo, a discussão pertence a uma regra que você pode versionar, testar e alterar.
Armadilhas#
Sintoma: a especificação diz "detectar problemas de segurança" ou "entender a cena", e os anotadores perguntam o que devem desenhar. Solução: reescreva a saída como um tipo de dado com classes nomeadas: "caixas para forklift e person".
Sintoma: uma classe como suspicious_behavior ou dangerous que dois anotadores rotulam de maneiras diferentes no mesmo quadro. Solução: substitua-a por evidências visíveis — uma pessoa dentro de uma zona restrita, uma porta mantida aberta — e transfira o julgamento para a linha de decisão.
Sintoma: "descreva o que está acontecendo" (geração de legendas) ou "preveja se a empilhadeira vai atingir alguém" (previsão). Solução: primeiro localize os objetos e, em seguida, adicione regras de rastreamento e movimento. Crie o detector antes da previsão.
Da especificação aos critérios de sucesso#
A especificação diz o que o modelo faz, não qual é o nível de qualidade suficiente nem quanto custa um erro em comparação com um falso alarme. Começa pelo objetivo de negócio, em Construir conjuntos de dados YOLO de alto desempenho, transforma a especificação em objetivos mensuráveis. Todas as lições seguintes deste curso remetem para as tuas três linhas.
Mostrar solução
Uma especificação para a câmara da prateleira:
- Entrada: uma imagem fixa de 1920×1080 a cada 60 segundos, captada por uma câmara fixa voltada para um corredor.
- Saída: caixas delimitadoras para
producteempty_facing(um espaço da prateleira sem produto), cada uma com uma pontuação de confiança. - Decisão: criar uma tarefa de reposição quando três ou mais caixas de
empty_facingna mesma prateleira persistirem em cinco imagens fixas consecutivas durante o horário de funcionamento da loja.
As expressões que o modelo não consegue ver são tarefa de reposição, mesma prateleira, persistir em cinco imagens fixas e horário de funcionamento da loja. Como regra:
if count(empty_facing on shelf S) >= 3 in each of the last 5 stills and store_is_open(now):
    create_restock_task(shelf=S)
A loja pode alterar «3», «5» ou o horário de abertura sem voltar a rotular uma única imagem.