Ajuste de custos e latência
Analisa o perfil de todo o pipeline, aciona as alavancas que realmente reduzem a latência e o custo, por ordem, e para quando atingires o limite.
As equipas passam semanas a reduzir milissegundos do modelo enquanto uma gravação na base de dados ou um descodificador RTSP é o verdadeiro gargalo. Há poucas alavancas importantes, e são bem mensuráveis: YOLO26s demora 2,2 vezes mais do que YOLO26n na CPU para obter mais 7,7 pontos de mAP, e executar a deteção em fotogramas alternados reduz o trabalho para metade. Nesta lição, vais aprender a analisar o perfil primeiro, acionar a alavanca de maior impacto que se adequa ao caso e parar quando atingires um limite definido antecipadamente.
Prático
Mede primeiro o pipeline completo#
Cada objeto Results divide o seu próprio tempo por etapas:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
totals = {"preprocess": 0.0, "inference": 0.0, "postprocess": 0.0}
for n, r in enumerate(model.predict(video, stream=True, verbose=False), 1):
    for stage in totals:
        totals[stage] += r.speed[stage]
print({stage: round(ms / n, 1) for stage, ms in totals.items()}, "ms per frame")
{'preprocess': 0.7, 'inference': 36.1, 'postprocess': 0.7} ms per frameNeste caso, a inferência representa 95% do tempo do modelo, por isso as alavancas relacionadas com o modelo vão ajudar. Mede também a descodificação e os teus próprios destinos da mesma forma (time.perf_counter() à volta de cada um) e, depois, aplica a regra correspondente ao que encontrares:
| O que medes | O que corrigir primeiro |
|---|---|
| 60 ms a descodificar RTSP, 5 ms de inferência | Descodificação por hardware, resolução de fluxo mais baixa ou mais threads de descodificação |
| 30 ms de inferência, 100 ms de pós-processamento em Python | Vetorização com NumPy ou execução num processo de trabalho |
| 5 ms de inferência, 200 ms em gravações na base de dados | Agrupa as gravações ou executa-as de forma assíncrona |
| A inferência é o gargalo | A classificação das alavancas abaixo |
Classificação das alavancas#
Experimenta pela ordem indicada e para quando atingires o limite:
| Ajuste | Aceleração típica | Custo típico em precisão |
|---|---|---|
| Modelo menor (m → s, s → n) | 1.5–2.5× | 4,5–7,7 pontos de mAP no COCO; menos em tarefas específicas |
imgsz menor (640 → 480) | cerca de 1,8× | Primeiro, objetos pequenos e distantes |
| Runtime mais rápido, FP16 | cerca de 1,5× na GPU | Normalmente nenhum; verifica a paridade |
| INT8 com calibração | mais 1,2× na GPU; até 2,9× na CPU | 1 ponto (YOLO26n) a 4–6 pontos (modelos maiores); o QAT recupera a maior parte |
Menos fotogramas (vid_stride=N) | até N× | Objetos rápidos e eventos curtos podem passar despercebidos |
| Lote maior (servidores) | Maior débito, não menor latência | Nenhum |
Os números provêm das tabelas de benchmarks do YOLO26, TensorRT e OpenVINO, bem como das medições abaixo; os teus serão diferentes, por isso mede.
Modelo menor#
A tabela de benchmarks do YOLO26 no COCO:
| Modelo | mAP50-95 | CPU ONNX (ms) | T4 TensorRT10 (ms) |
|---|---|---|---|
| YOLO26n | 40.9 | 38.9 | 1.7 |
| YOLO26s | 48.6 | 87.2 | 2.5 |
| YOLO26m | 53.1 | 220.0 | 4.7 |
Na CPU, cada redução de tamanho é 2,2–2,5× mais rápida. A diferença de precisão no COCO representa o pior caso: um detetor de armazém com 3 classes e objetos grandes costuma perder muito menos ao passar de m para n do que um detetor geral com 80 classes. Por isso, vale sempre a pena testar o modelo menor no teu próprio conjunto de validação.
Entrada menor#
O cálculo escala aproximadamente com o número de píxeis, por isso imgsz=480 requer cerca de 56% do trabalho da resolução 640. Medido na CPU do portátil de teste, com ONNX Runtime no lote 1 (mediana de 25 execuções em bus.jpg):
| Modelo | 640 | 480 | 320 |
|---|---|---|---|
| YOLO26n | 21.3 ms | 12.1 ms | 7.1 ms |
| YOLO26s | 55.0 ms | 24.2 ms | 12.9 ms |
Regra de decisão: se o teu objeto importante mais pequeno ainda ocupar cerca de 10 píxeis ou mais na nova resolução, experimenta; se os objetos forem pequenos ou distantes (drones, prateleiras longe da câmera), mantém a resolução e reduz o modelo.
Menos fotogramas#
Se a inferência limitar a tua frequência de fotogramas e a cena se mover lentamente, executa a deteção em cada N-ésimo fotograma com vid_stride=N e deixa o rastreador preencher as lacunas:
import time

from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
model.predict(video, vid_stride=30, verbose=False)  # warm up so the first timing is fair

for stride in (1, 2, 3):
    start, ids, frames = time.perf_counter(), set(), 0
    for r in model.track(video, stream=True, vid_stride=stride, tracker="bytetrack.yaml", classes=[0], verbose=False):
        frames += 1
        if r.boxes.is_track:
            ids.update(r.boxes.id.int().tolist())
    print(f"vid_stride={stride}: {frames} frames in {time.perf_counter() - start:.2f} s, {len(ids)} person IDs")
vid_stride=1: 62 frames in 2.66 s, 32 person IDs
vid_stride=2: 31 frames in 1.19 s, 30 person IDs
vid_stride=3: 20 frames in 0.95 s, 28 person IDsProcessar metade dos fotogramas demora cerca de metade do tempo, e o rastreador manteve 30 das 32 identidades. Em vid_stride=3 perdeu 4, o que indica que deves parar neste caso de movimento a passo de caminhada.
Reduz os custos na nuvem#
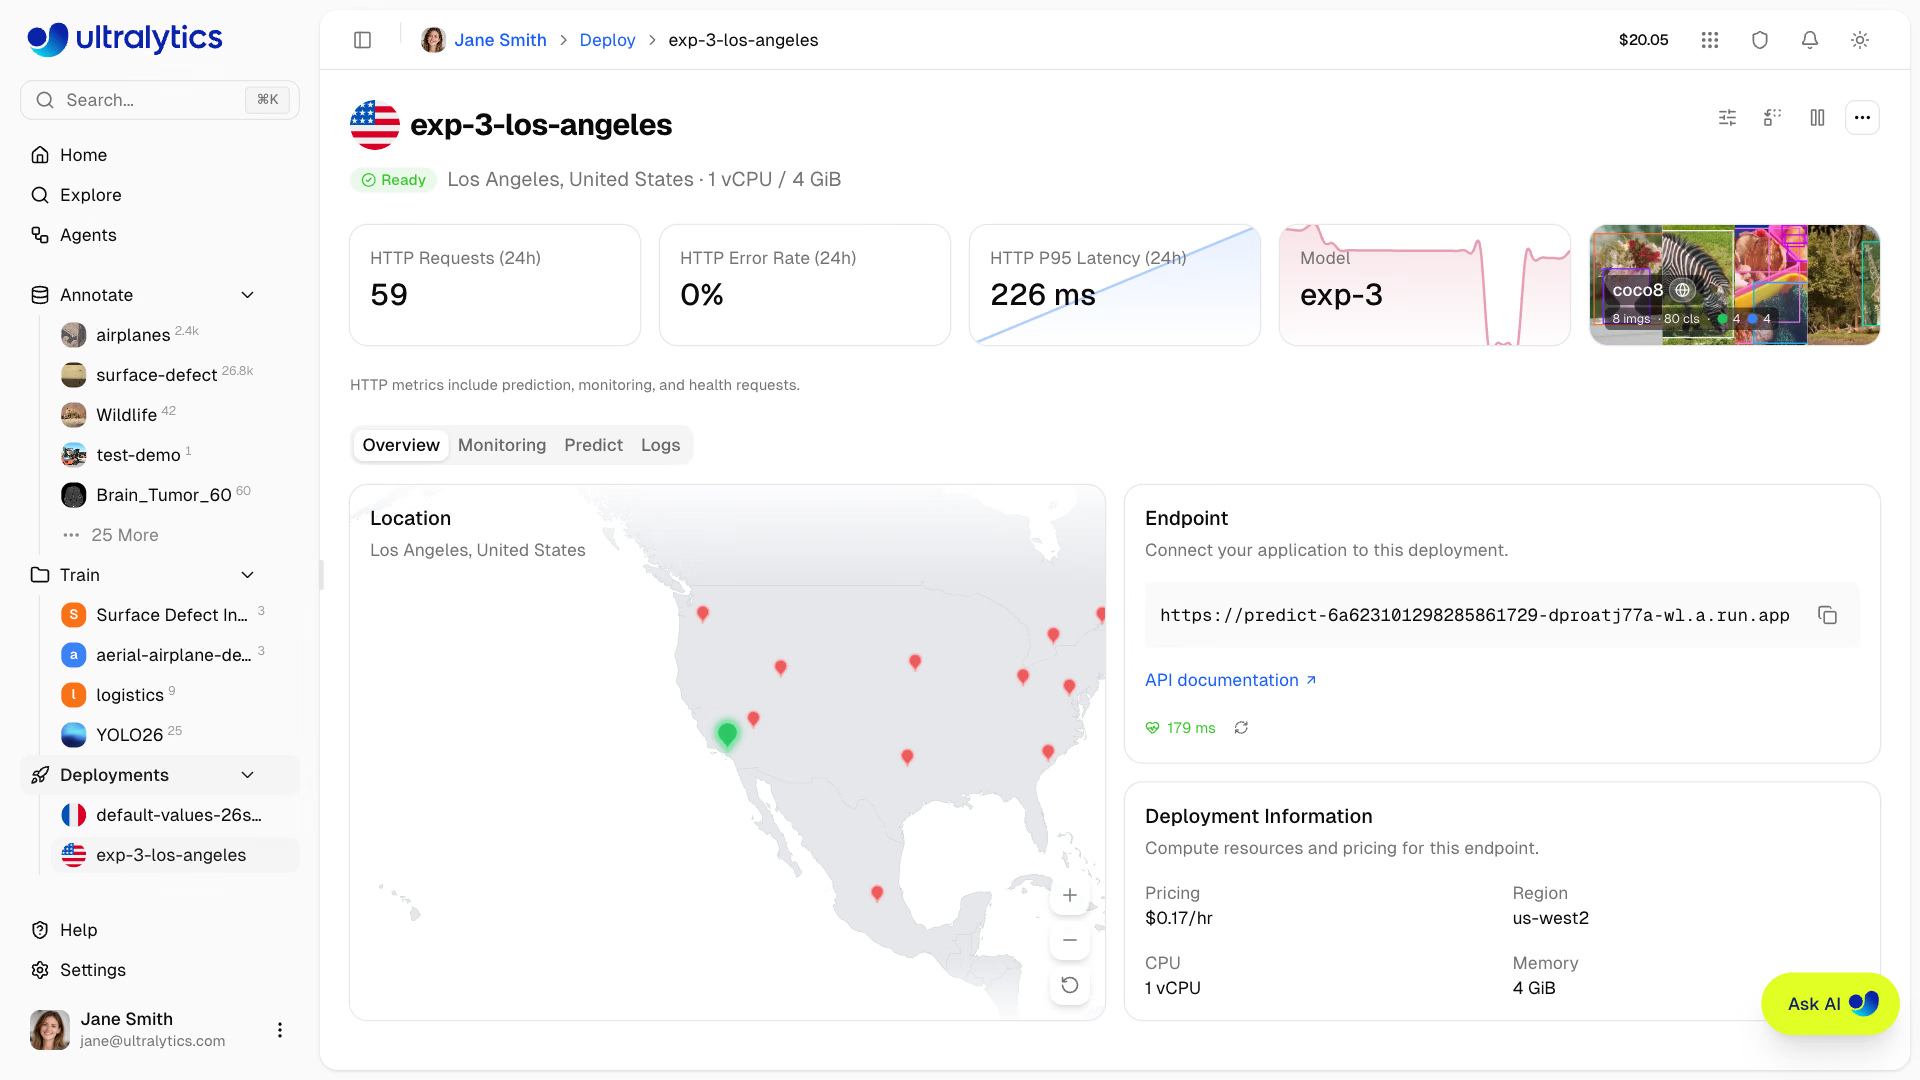
O custo corresponde às horas de instância divididas pelo trabalho útil. Um cartão como este apresenta os dois números de que precisas: o custo por hora (0,17 $ por 1 vCPU e 4 GiB neste caso) e o trabalho realizado (59 pedidos em 24 horas com latência P95 de 226 ms, num endpoint praticamente inativo). Depois:
- Aumenta a utilização. Uma GPU com 30% de utilização desperdiça 70% do que pagas. Agrupa os fluxos (lições anteriores) ou disponibiliza-os através do Triton Inference Server.
- Ajusta o tamanho dos recursos. Compara o desempenho numa GPU menor ou numa CPU com OpenVINO antes de presumires que precisas de uma GPU grande.
- Usa capacidade spot ou preemptível para trabalhos em lote. O reprocessamento de vídeos arquivados tolera interrupções; os fluxos em direto, não.
Armadilhas#
Sintoma: duas semanas de ajustes economizaram 10 ms, mas o sistema continua lento. Solução: primeiro, analise o pipeline inteiro e corrija a etapa mais lenta, seja ela qual for.
Sintoma: usar if i % 2: continue dentro do loop de resultados não economiza nada. Solução: o modelo já foi executado nesse quadro; pule quadros na origem com vid_stride.
Sintoma: o throughput aumentou, mas cada quadro chega mais tarde. Solução: lotes maiores aumentam o throughput por dólar, não reduzem a latência por quadro; use-os para muitos fluxos ou tarefas offline, não para uma única câmera em tempo real.
Quando as possibilidades de ajustar o modelo se esgotam, dados melhores são a próxima alavanca. Um conjunto de dados que corresponde à produção permite que um modelo menor alcance a precisão que um modelo maior exigia: uma redução de custos sem perda de precisão.
Mostrar solução
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on macOS and Windows
    data, img = "coco8.yaml", "https://ultralytics.com/images/bus.jpg"  # use your val YAML and a production frame
    for weights, imgsz in (("yolo26s.pt", 640), ("yolo26n.pt", 640), ("yolo26n.pt", 480)):
        model = YOLO(weights)
        runs = [model(img, imgsz=imgsz, verbose=False)[0].speed["inference"] for _ in range(20)][5:]
        m = model.val(data=data, imgsz=imgsz, batch=1, plots=False, verbose=False).box.map
        print(f"{weights} imgsz={imgsz}: {sorted(runs)[len(runs) // 2]:.1f} ms, mAP50-95 {m:.3f}")
Cada linha descarta as cinco primeiras execuções como aquecimento e informa a mediana das restantes. Escolha a primeira linha que atenda ao orçamento de latência com uma perda de mAP dentro do seu limite. Exemplo de orçamento: "dois dias, no máximo 1 ponto de mAP, 20 FPS no computador da loja". Se yolo26s em 640 não atingir 50 ms por quadro e yolo26n em 640 atingir esse valor com uma perda de até 1 ponto no seu conjunto de validação, pare por aí; não gaste o segundo dia testando 480.