Otimizar com TensorRT
Cria um engine TensorRT FP16, decide se o INT8 compensa a perda de precisão e valida o engine antes de o lançar.
Numa GPU NVIDIA, um engine TensorRT FP16 costuma ser o aumento de velocidade mais fácil que vais conseguir: cerca de 1,5× mais rápido no benchmark Ultralytics A100, sem alteração no mAP. O INT8 vai mais longe, mas o INT8 pós-treino custou de 4 a 6 pontos de mAP aos modelos YOLO26s a YOLO26m no COCO. Esta lição ensina-te a saber qual passo estás a dar e a medi-lo antes que os teus utilizadores o façam.
Prático
O código desta lição requer uma GPU NVIDIA com TensorRT instalado. Todos os argumentos mostrados estão listados para format=engine na documentação do modo de exportação.
FP16 é o primeiro passo seguro#
As GPUs NVIDIA a partir da arquitetura Volta têm núcleos tensoriais FP16, e os modelos de deteção raramente precisam de FP32 durante a inferência. Começa por aqui:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # or runs/detect/pills_v1/weights/best.pt
model.export(format="engine", quantize=16, workspace=4)  # Mecanismo FP16, até 4 GiB de espaço de trabalho do compilador
workspace limita a memória da GPU que o TensorRT pode usar durante a criação; deixa-o sem definir para permitir que o TensorRT decida. A página de integração do TensorRT publica este resultado obtido numa A100 (YOLOv8n, 640 px):
| Precisão | Predição, lote de 8 (ms) | mAP50-95 de validação no COCO |
|---|---|---|
| FP32 | 0.52 | 0.37 |
| FP16 | 0.34 | 0.37 |
| INT8 | 0.28 | 0.33 |
O modelo é anterior ao YOLO26, mas o padrão desta relação entre velocidade e precisão mantém-se: o FP16 foi cerca de 1,5× mais rápido sem custo; o INT8 trouxe mais 1,2× de velocidade e custou 4 pontos. Se o FP16 cumprir o teu orçamento, lança-o.
Não tens uma GPU NVIDIA local? O separador Exportar da Ultralytics Platform cria o engine numa GPU na nuvem à tua escolha, com as mesmas opções de tamanho da imagem, precisão, lote, modo dinâmico, NMS e espaço de trabalho:

Escolhe a família de GPU em que vais fazer a implementação: o engine da captura de ecrã foi criado numa RTX 5090 e só será executado nessa família.
O INT8 requer dados de calibração#
A quantização INT8 mapeia as ativações de cada camada para 256 níveis. Para escolher esses intervalos, o exportador executa imagens de calibração no modelo e regista as ativações observadas; por isso, as imagens devem ser semelhantes às de produção:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(
    format="engine",
    quantize=8,
    data="coco128.yaml",  # as imagens de calibração vêm da divisão val deste conjunto de dados; usa my_dataset/data.yaml
    fraction=1.0,  # percentagem (ou número) dessas imagens a utilizar
    batch=8,  # lotes de calibração maiores produzem intervalos mais estáveis
    dynamic=True,  # com batch=8, o engine aceita lotes de 1 a 8
    workspace=4,
)
O custo do INT8 depende do modelo. A documentação do modo Exportar mediu engines TensorRT YOLO26 na validação do COCO (mAP50-95):
| Modelo | Engine FP32 | INT8 com calibração (PTQ) | INT8 após treino com reconhecimento de quantização (QAT) |
|---|---|---|---|
| YOLO26n | 0.4032 | 0.3934 | 0.3935 |
| YOLO26s | 0.4794 | 0.4412 | 0.4711 |
| YOLO26m | 0.5269 | 0.4696 | 0.5137 |
Só a calibração custa 1 ponto ao YOLO26n e 4–6 pontos aos modelos maiores. O QAT ajusta o modelo com quantize=8 em train para que os pesos tolerem INT8; o checkpoint inclui os próprios intervalos, a exportação INT8 não precisa de dados de calibração e fica a 1–2 pontos do FP32. A decisão:
Valida o engine antes de o lançar#
Cada engine tem de passar pelas mesmas verificações na GPU de implementação:
| Verificação | Critério |
|---|---|
| mAP50-95 no teu conjunto de validação | A menos de 0,5 pontos do FP32 para FP16; para INT8, dentro do orçamento definido por escrito |
| AP por classe | Nenhuma classe perde mais de cerca de 1 ponto (as classes pequenas variam mais) |
| Latência p95 | Abaixo do orçamento com o tamanho de lote de produção |
| Limiar de operação | conf escolhido novamente com base na própria curva F1 do engine |
| Determinismo | A mesma imagem produz exatamente as mesmas caixas nas duas execuções |
yolo val model=yolo26n.engine data=coco8.yaml  # or my_dataset/data.yaml
yolo benchmark model=yolo26n.pt data=coco8.yaml imgsz=640 format=engine quantize=16
De onde vem o aumento de velocidade#
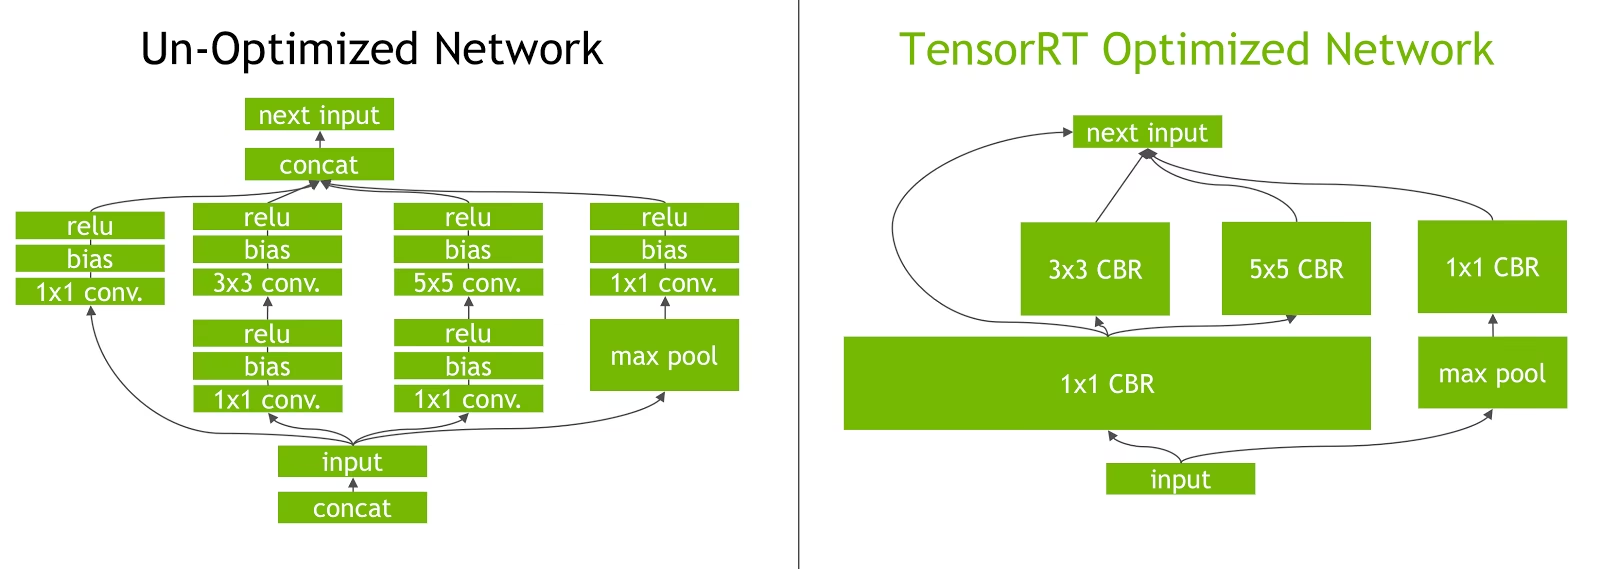
O TensorRT funde cada convolução, bias e ReLU num único kernel (os blocos “CBR” à direita) e elimina as etapas de concatenação, pelo que a GPU executa muito menos kernels e movimenta menos dados. No YOLO26, isto traz vantagens nas sequências conv-BN-ativação presentes em toda a rede, no bloco de atenção (PSA) do backbone e nas muitas operações pequenas da cabeça de deteção. Se um engine continuar lento, analisa-o com trtexec ou NVIDIA Nsight: muitas vezes, uma camada ocupa 30% ou mais do tempo.
Armadilhas#
Sintoma: INT8 perde 1 ponto no COCO e 6 nas suas câmeras. Solução: calibre com uma parte dos seus próprios dados de validação separada para teste; a NVIDIA recomenda pelo menos 500 imagens representativas. A calibração também varia entre dispositivos, então calibre na GPU de destino.
Sintoma: a revocação cai depois de mudar para INT8 com o mesmo conf. Solução: INT8 pode alterar os valores de confiança; escolha novamente conf com base na própria curva F1 do mecanismo INT8.
Sintoma: o mecanismo não consegue ser desserializado ou é executado mais lentamente do que o esperado na máquina de implantação. Solução: compile na família de GPUs de implantação com versões correspondentes do TensorRT e do runtime CUDA e envie o .onnx para que os dispositivos possam recompilar. Se a calibração falhar durante a compilação, aumente workspace ou diminua imgsz ou batch.
No Jetson, o DeepStream executa os engines resultantes num pipeline de vídeo acelerado por hardware; no centro de dados, o Triton Inference Server disponibiliza-os.
Mostrar solução
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on Windows
    data = "coco8.yaml"  # or my_dataset/data.yaml
    model = YOLO("yolo26n.pt")
    engine = model.export(format="engine", quantize=16, workspace=4)

    base = model.val(data=data, plots=False).box.map
    fp16 = YOLO(engine).val(data=data, plots=False).box.map
    print(f"PyTorch {base:.4f}  FP16 engine {fp16:.4f}  gap {abs(base - fp16) * 100:.2f} points")

    # Only if FP16 misses the latency budget:
    # model.export(format="engine", quantize=8, data=data, batch=8, dynamic=True, workspace=4)
Um relatório aprovado indica: diferença inferior a 0,5 pontos, p95 abaixo do orçamento e decisão de lançar FP16. Se a p95 não cumprir o orçamento, exporta em INT8 com o teu próprio YAML de calibração, volta a executar as mesmas duas linhas e lança em INT8 apenas se a diferença ficar dentro do orçamento definido por escrito antes de começar; caso contrário, experimenta QAT ou um modelo menor.