OpenVINO na CPU
Exporta modelos OpenVINO FP32, FP16 e INT8, valida cada um e mantém o INT8 apenas se trouxer vantagens na tua própria CPU.
Uma CPU Intel que já tens pode muitas vezes substituir uma instância com GPU: nos benchmarks da Ultralytics, o YOLO26m passa de 192 ms em PyTorch para 36 ms com OpenVINO INT8 numa CPU Core Ultra de portátil. Os ganhos dependem do chip, porém, e no portátil de teste ARM deste curso, uma exportação INT8 calibrada com quatro imagens perdeu 3 pontos de mAP. Vais aprender a medir qual destes casos se aplica antes de lançar o modelo.
Prático
O que o OpenVINO oferece#
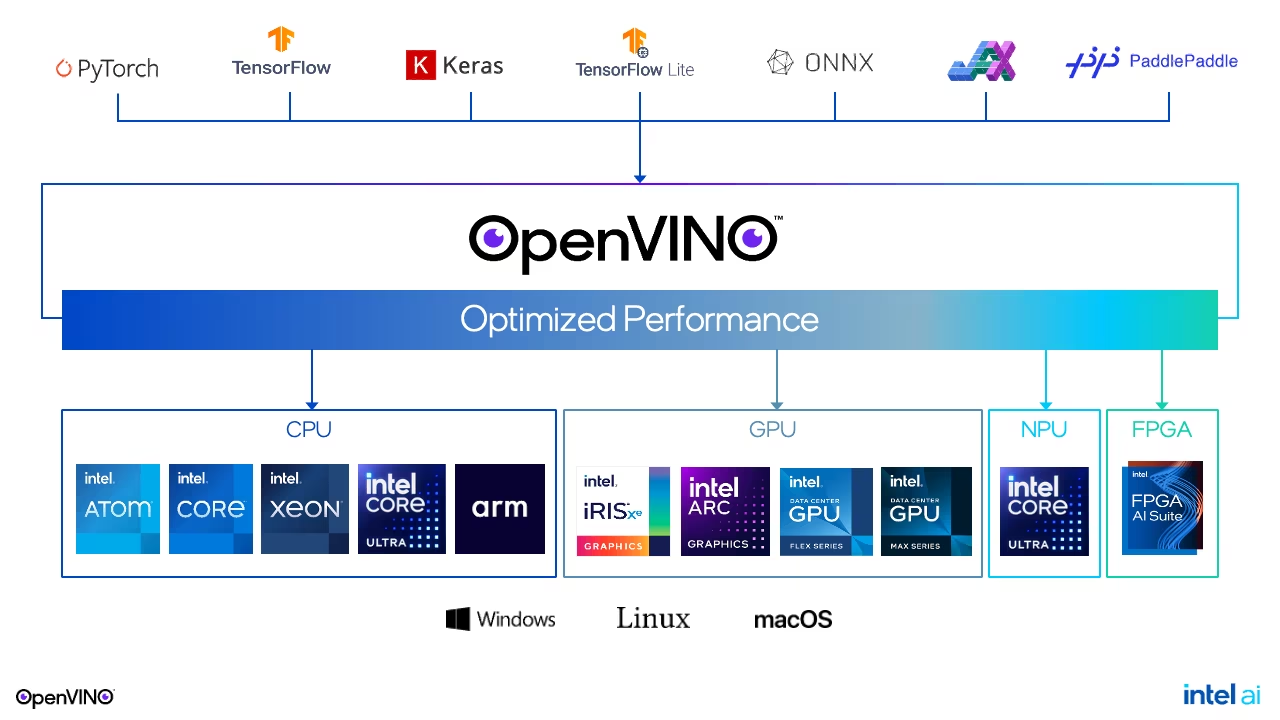
O OpenVINO recebe modelos do PyTorch e do ONNX e executa-os em CPUs Intel, GPUs integradas e dedicadas e NPUs, através de uma única API. Os kernels para CPU têm como alvo os conjuntos de instruções Intel (AVX2, AVX-512, AMX), e o percurso INT8 está bastante desenvolvido. Observa a secção ARM na coluna CPU: o OpenVINO também funciona em ARM, mas os seus kernels são otimizados para Intel, por isso mede o desempenho antes de depender dele nesse hardware.
O benchmark publicado numa CPU Intel Core Ultra 7 155H (COCO128):
| Modelo | PyTorch FP32 | OpenVINO FP32 | OpenVINO INT8 | mAP50-95 de FP32 a INT8 |
|---|---|---|---|---|
| YOLO26n | 33.19 ms | 13.43 ms | 11.40 ms | 0.4734 → 0.4611 |
| YOLO26s | 70.92 ms | 36.16 ms | 15.54 ms | 0.5632 → 0.5471 |
| YOLO26m | 192.45 ms | 102.52 ms | 35.72 ms | 0.6191 → 0.6025 |
Da tabela resultam três regras:
- Só o OpenVINO FP32 reduz aproximadamente para metade a latência do PyTorch numa CPU Intel. Começa por aqui.
- O INT8 compensa mais à medida que o modelo cresce: 1,2× para
n, 2,9× param, com uma perda de 1,2–1,7 pontos de mAP. Non, raramente compensa usar INT8 devido à perda de precisão. - Experimenta a GPU integrada antes de comprar hardware: a GPU Arc integrada (iGPU) do mesmo chip (
device="intel:gpu") executou o YOLO26n FP32 em 9,13 ms e o YOLO26m em 34,47 ms.
Compara os níveis de precisão na tua própria CPU#
Exporta cada nível de precisão, valida-o imediatamente e só depois exporta o seguinte:
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on macOS and Windows
    model = YOLO("yolo26n.pt")  # or runs/detect/pills_v1/weights/best.pt
    for name, quantize in (("FP32", None), ("FP16", 16), ("INT8", 8)):
        path = model.export(format="openvino", quantize=quantize, data="coco8.yaml")  # or my_dataset/data.yaml
        m = YOLO(path).val(data="coco8.yaml", batch=1, plots=False, verbose=False)  # before the next export overwrites it
        print(f"{name}: mAP50-95 {m.box.map:.4f}  -> {path}")
OpenVINO: export success ✅ 2.3s, saved as 'yolo26n_openvino_model/' (9.6 MB)
FP32: mAP50-95 0.6783 -> yolo26n_openvino_model/
OpenVINO: export success ✅ 1.6s, saved as 'yolo26n_openvino_model/' (5.1 MB)
FP16: mAP50-95 0.6783 -> yolo26n_openvino_model/
WARNING ⚠️ OpenVINO: >300 images recommended for INT8 calibration, found 4 images.
OpenVINO: export success ✅ 11.3s, saved as 'yolo26n_int8_openvino_model/' (3.2 MB)
INT8: mAP50-95 0.6460 -> yolo26n_int8_openvino_model/O que cada linha informa:
- FP32 e FP16 obtêm a mesma pontuação, e o FP16 ocupa metade do espaço (5,1 contra 9,6 MB), mas ambos foram gravados na mesma pasta. Se tivesses exportado os dois primeiro e validado depois, terias medido o FP16 duas vezes.
- O INT8 ocupa 3,2 MB e perdeu 3,2 pontos, porque foi calibrado com as quatro imagens do COCO8. O aviso explica o motivo: uma calibração real precisa de centenas de imagens semelhantes às de produção, do teu próprio YAML (
fractionlimita o número de imagens utilizadas). - Nada disto mede a velocidade. Para isso, usa o benchmark abaixo.
Para executar um modelo exportado num dispositivo Intel específico:
from ultralytics import YOLO

ov_model = YOLO("yolo26n_openvino_model/")
results = ov_model("https://ultralytics.com/images/bus.jpg", device="intel:cpu")  # ou intel:gpu, intel:npu
Distribui a pasta inteira: yolo26n.xml (o grafo), yolo26n.bin (os pesos) e metadata.yaml. intel:gpu e intel:npu requerem hardware Intel.
Compara o desempenho com o ONNX Runtime#
A precisão está definida; a velocidade determina-se no dispositivo de destino, sob a carga real que terá de suportar. Executa pick_runtime.py da primeira lição com CANDIDATES = ("onnx", "openvino"). No portátil de teste com Apple silicon, enquanto outros trabalhos partilhavam a CPU:
onnx      p50  30.0 ms  p95  46.4 ms  misses the 30 ms budget
openvino  p50  22.8 ms  p95 113.5 ms  misses the 30 ms budget
O OpenVINO teve uma mediana melhor e uma cauda muito pior. O wrapper Ultralytics compila o OpenVINO com a sugestão LATENCY (o registo indica Using OpenVINO LATENCY mode for batch=1 inference on CPU), que distribui cada pedido pelos núcleos da CPU; quando outros trabalhos concorrem por esses núcleos, os pedidos mais lentos são os mais afetados. Num computador Intel dedicado, os resultados costumam ser semelhantes aos publicados acima, mas só a tua própria p95 te pode dar essa certeza.
Regras de decisão:
Armadilhas#
Sintoma: a exportação FP16 tem metade do tamanho e é exatamente tão lenta quanto antes. Solução: na maioria das CPUs, o plug-in escolhe sua própria precisão de execução; use FP16 para downloads menores e INT8 ou a iGPU para obter velocidade.
Sintoma: FP32 e FP16 reportam números idênticos porque eram o mesmo arquivo. Solução: as exportações FP32 e FP16 compartilham a pasta *_openvino_model/; valide (ou renomeie a pasta) logo após cada exportação.
Sintoma: a média parece boa, mas ainda há quadros perdidos nos momentos de maior atividade. Solução: cronometre a inferência com a carga de produção em execução e tome decisões com base no p95, não na média. Para muitos fluxos em um servidor, compile com a dica THROUGHPUT carregando o .xml diretamente com o runtime OpenVINO, como mostra o guia modos de latência vs. throughput.
No macOS e no Windows, a validação inicia processos de trabalho que reimportam seu script. Sem if __name__ == "__main__":, a execução de teste desta lição repetiu as exportações dentro desses processos, desperdiçando minutos e competindo pela CPU que estava tentando medir.
Mostrar solução
python ov_compare.py    # accuracy and size of FP32, FP16, INT8
python pick_runtime.py  # p50 and p95 for ONNX Runtime and OpenVINO
Um exemplo de decisão com os números do Core Ultra 7 155H acima:
| Opção | mAP50-95 | Quantidade | ms por imagem |
|---|---|---|---|
| OpenVINO FP32 | 0.4734 | 9.6 MB | 13.43 |
| OpenVINO INT8 | 0.4611 | 3.2 MB | 11.40 |
iGPU FP32 (intel:gpu) | 0.4758 | 9.6 MB | 9.13 |
Implementa OpenVINO FP32 na GPU integrada: é a opção mais rápida e não perde precisão, enquanto INT8 na CPU custaria 1,2 pontos para poupar 2 ms. Numa implementação de YOLO26m, a resposta muda para CPU INT8 (2,9× mais rápido por 1,7 pontos), se essa perda estiver dentro do teu orçamento.