Inferência em múltiplos fluxos
Executa várias câmeras num único modelo com inferência em lotes, filas limitadas e medição de frames descartados.
Um sistema que acompanha uma câmera pode ficar minutos atrasado com quatro, sem que nada falhe: os resultados simplesmente chegam cada vez mais tarde, até a memória esgotar. No CPU do portátil usado aqui, um fluxo de 30 FPS acompanhou o ritmo; quatro descartaram metade dos frames e oito descartaram mais de dois terços. Esta lição cria o pipeline que mede esse valor, porque é assim que dimensionas o hardware.
Prático
Para onde vai o tempo#
Cada frame passa por quatro etapas:
| Etapa | Custo típico | Executa em |
|---|---|---|
| Descodificação (RTSP ou ficheiro → array) | 5–20 ms por frame 1080p | CPU |
| Pré-processamento (letterbox, normalização) | cerca de 1 ms | CPU |
| Inferência | alguns ms (GPU) a dezenas de ms (CPU) | Acelerador |
| Pós-processamento, rastreamento, destinos | alguns ms, mais para bases de dados lentas | CPU |
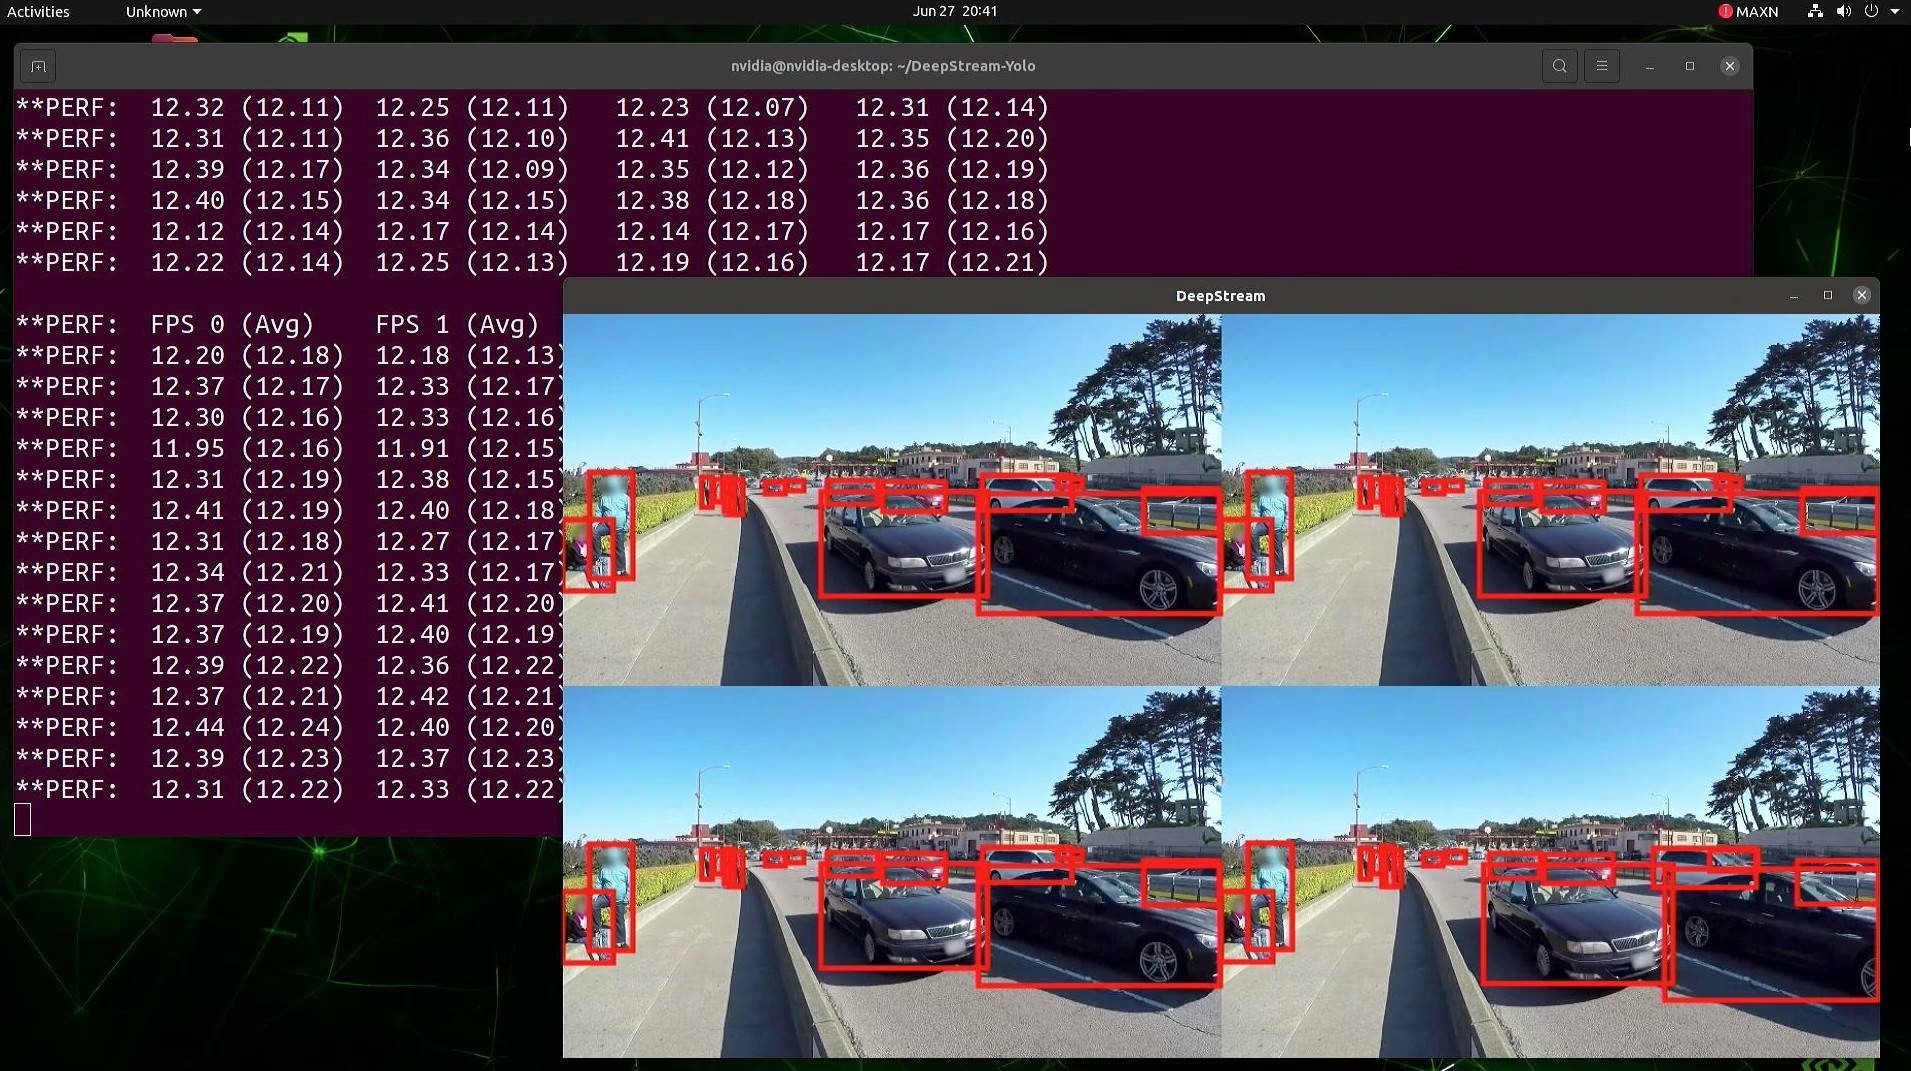
Executa as etapas uma após a outra, câmera a câmera, numa única thread, e o acelerador fica ocioso enquanto os frames são descodificados. A solução é separar as etapas, como faz o pipeline DeepStream acima: quatro fluxos partilham um dispositivo, cada um indicando o seu próprio FPS (cerca de 12 aqui). A mesma estrutura em Python:
Integrado: um ficheiro .streams#
O Ultralytics agrupa várias fontes em lotes por ti. Coloca uma fonte por linha num ficheiro .streams e passa-o ao modo Predict ou Track. Cada fluxo recebe a sua própria thread de leitura e o seu próprio rastreador, e cada iteração executa uma passagem direta em lote por todos os fluxos:
from collections import Counter
from pathlib import Path

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

base = "https://github.com/ultralytics/assets/releases/download/v0.0.0/"
clips = [safe_download(base + name) for name in ("solutions_ci_demo.mp4", "ground-vehicles-airport.mp4")]
Path("cams.streams").write_text("\n".join(str(c) for c in clips))  # produção: um URL rtsp:// por linha

model = YOLO("yolo26n.pt")  # usa a tua exportação otimizada em produção
frames = Counter()
for r in model.track("cams.streams", stream=True, stream_buffer=True, tracker="bytetrack.yaml", verbose=False):
    frames[Path(r.path).name] += 1  # r.path indica de que fluxo veio este resultado
print(frames)
Counter({'solutions_ci_demo.mp4': 62, 'ground-vehicles-airport.mp4': 62})Ambos os fluxos produziram 62 resultados porque a iteração termina quando acaba o fluxo mais curto (o clipe do aeroporto tem 150 frames). stream_buffer=True processou todos os frames, o que é adequado para ficheiros gravados; para câmeras ao vivo, mantém a predefinição False para que um modelo lento ignore frames desatualizados em vez de ficar para trás. Combina isto com uma exportação TensorRT ou OpenVINO para obter o melhor débito por fluxo.
Personalizado: produtor-consumidor com contadores de descartes#
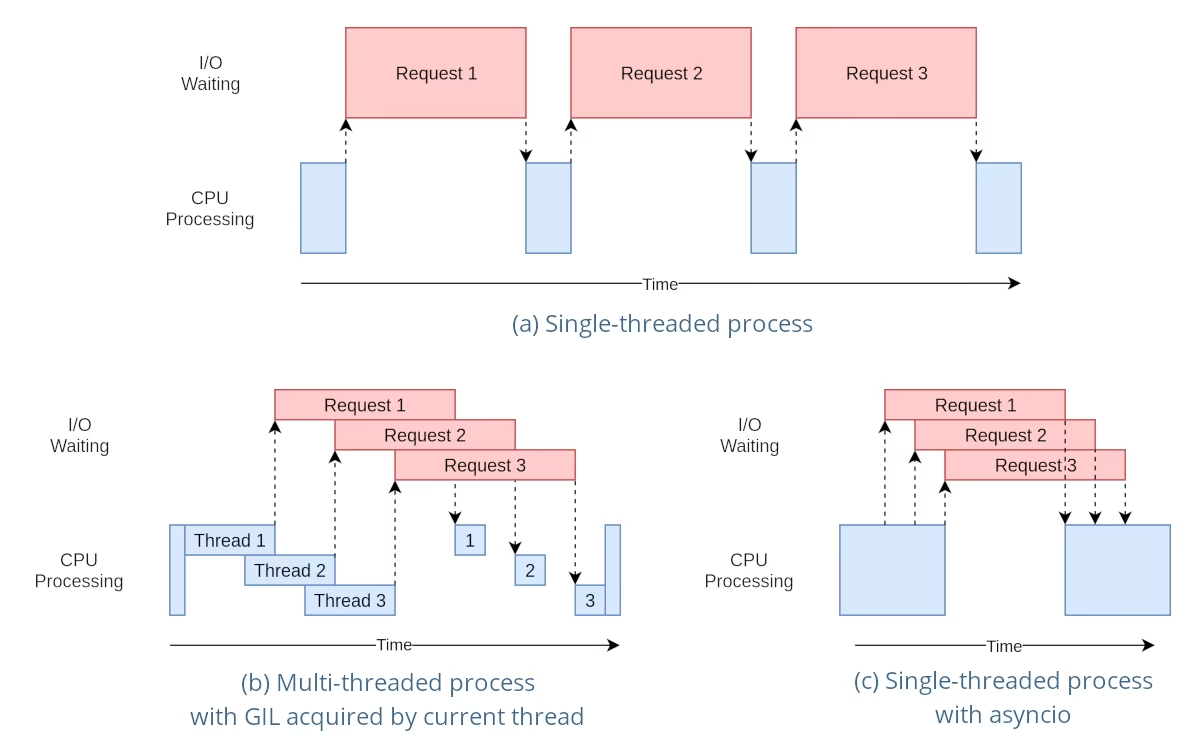
O diagrama mostra por que as threads funcionam neste pipeline. A descodificação consiste sobretudo em esperar (as barras cor-de-rosa de E/S), e OpenCV e PyTorch libertam o GIL do Python enquanto trabalham, por isso as threads de descodificação sobrepõem-se bem (painel b). O pós-processamento intenso em Python não se sobrepõe; transfere-o para processos separados.
Quando precisares dos teus próprios destinos, de lógica por câmera ou de métricas explícitas de descarte, constrói o pipeline por tua conta. As threads de descodificação nunca tocam no modelo; um único loop consumidor controla-o, o que também te mantém dentro das regras de inferência segura para threads:
import queue
import threading
import time

import cv2

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

base = "https://github.com/ultralytics/assets/releases/download/v0.0.0/"
SOURCES = [str(safe_download(base + n)) for n in ("solutions_ci_demo.mp4", "ground-vehicles-airport.mp4")]
frames = queue.Queue(maxsize=16)  # bounded: memory and latency stay flat under overload
dropped = [0] * len(SOURCES)

def decode(stream_id, source):
    """Producer: read frames at the camera's pace and never block on a full queue."""
    cap = cv2.VideoCapture(source)
    interval = 1 / (cap.get(cv2.CAP_PROP_FPS) or 30)
    while True:
        ok, frame = cap.read()
        if not ok:
            break
        try:
            frames.put_nowait((stream_id, frame))
        except queue.Full:
            dropped[stream_id] += 1  # consumer is behind: drop rather than serve stale frames
        time.sleep(interval)  # pace files like a live camera; remove for RTSP sources
    cap.release()

model = YOLO("yolo26n.pt")  # one model, used only by the consumer loop below
model.predict("https://ultralytics.com/images/bus.jpg", verbose=False)  # warm up before cameras start

decoders = [threading.Thread(target=decode, args=(i, s), daemon=True) for i, s in enumerate(SOURCES)]
for t in decoders:
    t.start()

processed = [0] * len(SOURCES)
while any(t.is_alive() for t in decoders) or not frames.empty():
    batch = []
    while len(batch) < 8:  # gather up to 8 frames from any camera
        try:
            batch.append(frames.get(timeout=0.05))
        except queue.Empty:
            break
    if not batch:
        continue
    results = model([frame for _, frame in batch], verbose=False)  # one batched forward pass
    for (stream_id, _), r in zip(batch, results):
        processed[stream_id] += 1  # per-stream postprocessing and sinks go here

print(f"processed={processed} dropped={dropped}")
processed=[56, 131] dropped=[6, 19]Os dois clipes têm 62 e 150 frames, e cada frame é processado ou descartado (56 + 6 = 62, 131 + 19 = 150), portanto os contadores contabilizam tudo. Foram descartados 25 dos 212 frames: o CPU deste portátil não consegue executar yolo26n em PyTorch com dois fluxos de 30 FPS. Repetindo os clipes para simular mais câmeras, numa única execução:
| Fluxos (30 FPS cada) | Frames descartados |
|---|---|
| 1 | 0% |
| 2 | 12% |
| 4 | 51% |
| 8 | 69% |
Dimensiona a capacidade com base em medições#
Fluxos por dispositivo ≈ débito sustentado (frames por segundo que o modelo processa com o tamanho de lote escolhido) ÷ FPS necessário por fluxo. Mede o débito com a exportação otimizada das lições anteriores no hardware real, mantém uma margem de 20–30% para picos e gera um alerta quando os descartes forem superiores a zero. O custo de resoluções mais altas aumenta aproximadamente com o número de píxeis: 1280×1280 exige cerca de 4× mais capacidade de computação do que 640×640. Para grandes frotas, o Triton Inference Server e o DeepStream no Jetson são opções naturais para produção.
Armadilhas#
Sintoma: model.track(["cam1.mp4", "cam2.mp4"]) trata a lista como um lote de imagens, não como fluxos. Solução: grave as origens em um arquivo .streams, uma por linha.
Sintoma: cada arquivo fornece apenas um ou dois quadros. Solução: stream_buffer=False descarta quadros obsoletos, e os leitores de arquivos avançam mais rápido que o modelo; defina stream_buffer=True para arquivos e mantenha o padrão para câmeras ao vivo.
Sintoma: resultados incorretos ou misturados ocasionalmente sob carga. Solução: nunca chame uma única instância de YOLO simultaneamente de várias threads. Deixe um único consumidor ser responsável por ela, como acima, ou crie um modelo dentro de cada thread de inferência.
Sintoma: a latência aumenta a cada minuto e a memória cresce até o processo encerrar. Solução: use uma fila limitada que descarte itens quando estiver cheia, além de um contador de descartes. Sistemas em tempo real devem descartar quadros durante sobrecargas, não ficar atrasados.
Mostrar solução
Transforma a quantidade de fluxos num argumento da linha de comandos, adicionando estas linhas a producer_consumer.py, logo após a linha SOURCES:
import sys

N = int(sys.argv[1]) if len(sys.argv) > 1 else 2  # quantidade de câmeras simuladas
SOURCES = [SOURCES[i % len(SOURCES)] for i in range(N)]
Depois, varia o valor:
for n in 1 2 4 8; do python producer_consumer.py $n; doneprocessed=[62] dropped=[0]
processed=[56, 131] dropped=[6, 19]
processed=[23, 82, 23, 81] dropped=[39, 68, 39, 69]
processed=[14, 53, 13, 53, 13, 52, 13, 53] dropped=[48, 97, 49, 97, 49, 98, 49, 97]A resposta para esta máquina é um fluxo: os descartes começam com dois. Para servir quatro câmeras, exporta para um runtime mais rápido (lições 3 e 4), reduz imgsz ou muda para um acelerador; depois, executa novamente os testes.