Настройка стоимости и задержки
Профилируй весь конвейер, по очереди задействуй рычаги, которые действительно снижают задержку и стоимость, и остановись, когда достигнешь заданного бюджета.
Команды тратят недели, пытаясь сэкономить миллисекунды на модели, хотя настоящим узким местом оказывается запись в базу данных или декодер RTSP. Эффективных рычагов немного, и их влияние хорошо измерено: YOLO26s работает на CPU в 2,2 раза дольше, чем YOLO26n, ради прироста в 7,7 пункта mAP, а обработка детекциями каждого второго кадра сокращает объём работы вдвое. На этом уроке ты научишься сначала профилировать систему, задействовать самый эффективный подходящий рычаг и останавливаться на заранее заданном бюджете.
Практические занятия
Сначала измерь весь конвейер#
Каждый объект Results разбивает собственное время на этапы:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
totals = {"preprocess": 0.0, "inference": 0.0, "postprocess": 0.0}
for n, r in enumerate(model.predict(video, stream=True, verbose=False), 1):
    for stage in totals:
        totals[stage] += r.speed[stage]
print({stage: round(ms / n, 1) for stage, ms in totals.items()}, "ms per frame")
{'preprocess': 0.7, 'inference': 36.1, 'postprocess': 0.7} ms per frameЗдесь на инференс приходится 95% времени модели, поэтому рычаги, связанные с моделью, помогут. Замерь время декодирования и собственных этапов передачи результатов тем же способом (оберни каждый из них в time.perf_counter()), а затем действуй в зависимости от результата:
| Результаты измерений | Что исправить в первую очередь |
|---|---|
| 60 мс на декодирование RTSP, 5 мс на инференс | Аппаратное декодирование, снижение разрешения потока или увеличение числа потоков декодера |
| 30 мс на инференс, 100 мс на постобработку в Python | Векторизуй операции с помощью NumPy или перенеси их в рабочий процесс |
| 5 мс на инференс, 200 мс на запись в базу данных | Объедини записи в пакеты или выполняй их асинхронно |
| Преобладает время инференса | Рейтинг рычагов ниже |
Рейтинг рычагов#
Пробуй по порядку, начиная сверху, и остановись, когда уложишься в бюджет:
| Способ | Типичное ускорение | Типичная цена в точности |
|---|---|---|
| Модель меньшего размера (m → s, s → n) | 1.5–2.5× | 4,5–7,7 пункта mAP на COCO; меньше для узкоспециализированных задач |
Меньший imgsz (640 → 480) | около 1,8× | Сначала пропадают мелкие и удалённые объекты |
| Более быстрый runtime, FP16 | около 1,5× на GPU | Обычно отсутствует; проверь эквивалентность результатов |
| INT8 с калибровкой | дополнительно 1,2× на GPU; до 2,9× на CPU | 1 пункт для YOLO26n и 4–6 пунктов для более крупных моделей; QAT позволяет восстановить большую часть точности |
Меньше кадров (vid_stride=N) | до N× | Быстрые объекты и короткие события могут остаться незамеченными |
| Больший размер пакета (серверы) | Выше пропускная способность, но не ниже задержка | Не требуется |
Числа взяты из таблиц бенчмарков YOLO26, TensorRT и OpenVINO, а также из приведённых ниже измерений; у тебя результаты будут отличаться, поэтому измеряй.
Модель меньшего размера#
Таблица бенчмарков YOLO26 на COCO:
| Модель | mAP50-95 | CPU ONNX (мс) | T4 TensorRT10 (мс) |
|---|---|---|---|
| YOLO26n | 40.9 | 38.9 | 1.7 |
| YOLO26s | 48.6 | 87.2 | 2.5 |
| YOLO26m | 53.1 | 220.0 | 4.7 |
На CPU каждый переход на модель меньшего размера ускоряет обработку в 2,2–2,5 раза. Разрыв в точности на COCO — наихудший сценарий: детектор для склада с 3 классами и крупными объектами обычно теряет гораздо меньше при переходе с m на n, чем универсальный детектор с 80 классами, поэтому всегда проверяй модель меньшего размера на собственном val-наборе.
Меньший размер входа#
Вычислительная нагрузка примерно пропорциональна числу пикселей, поэтому imgsz=480 требует около 56% вычислений по сравнению с размером 640. Измерения выполнены на CPU тестового ноутбука с ONNX Runtime и размером пакета 1 (медиана 25 запусков на bus.jpg):
| Модель | 640 | 480 | 320 |
|---|---|---|---|
| YOLO26n | 21.3 ms | 12.1 ms | 7.1 ms |
| YOLO26s | 55.0 ms | 24.2 ms | 12.9 ms |
Правило принятия решения: если самый маленький важный объект всё ещё занимает около 10 пикселей или больше при новом размере, попробуй его; если объекты мелкие или удалённые (дроны, дальние стеллажи), сохрани разрешение и вместо этого уменьши модель.
Меньше кадров#
Если частоту кадров ограничивает инференс, а сцена меняется медленно, запускай детекцию на каждом N-м кадре с помощью vid_stride=N, а пробелы пусть заполняет трекер:
import time

from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
model.predict(video, vid_stride=30, verbose=False)  # warm up so the first timing is fair

for stride in (1, 2, 3):
    start, ids, frames = time.perf_counter(), set(), 0
    for r in model.track(video, stream=True, vid_stride=stride, tracker="bytetrack.yaml", classes=[0], verbose=False):
        frames += 1
        if r.boxes.is_track:
            ids.update(r.boxes.id.int().tolist())
    print(f"vid_stride={stride}: {frames} frames in {time.perf_counter() - start:.2f} s, {len(ids)} person IDs")
vid_stride=1: 62 frames in 2.66 s, 32 person IDs
vid_stride=2: 31 frames in 1.19 s, 30 person IDs
vid_stride=3: 20 frames in 0.95 s, 28 person IDsОбработка половины кадров занимает примерно вдвое меньше времени, а трекер сохранил 30 из 32 идентификаторов. При vid_stride=3 он потерял 4 идентификатора — для сцены с движением в темпе ходьбы это сигнал остановиться.
Снижение облачных затрат#
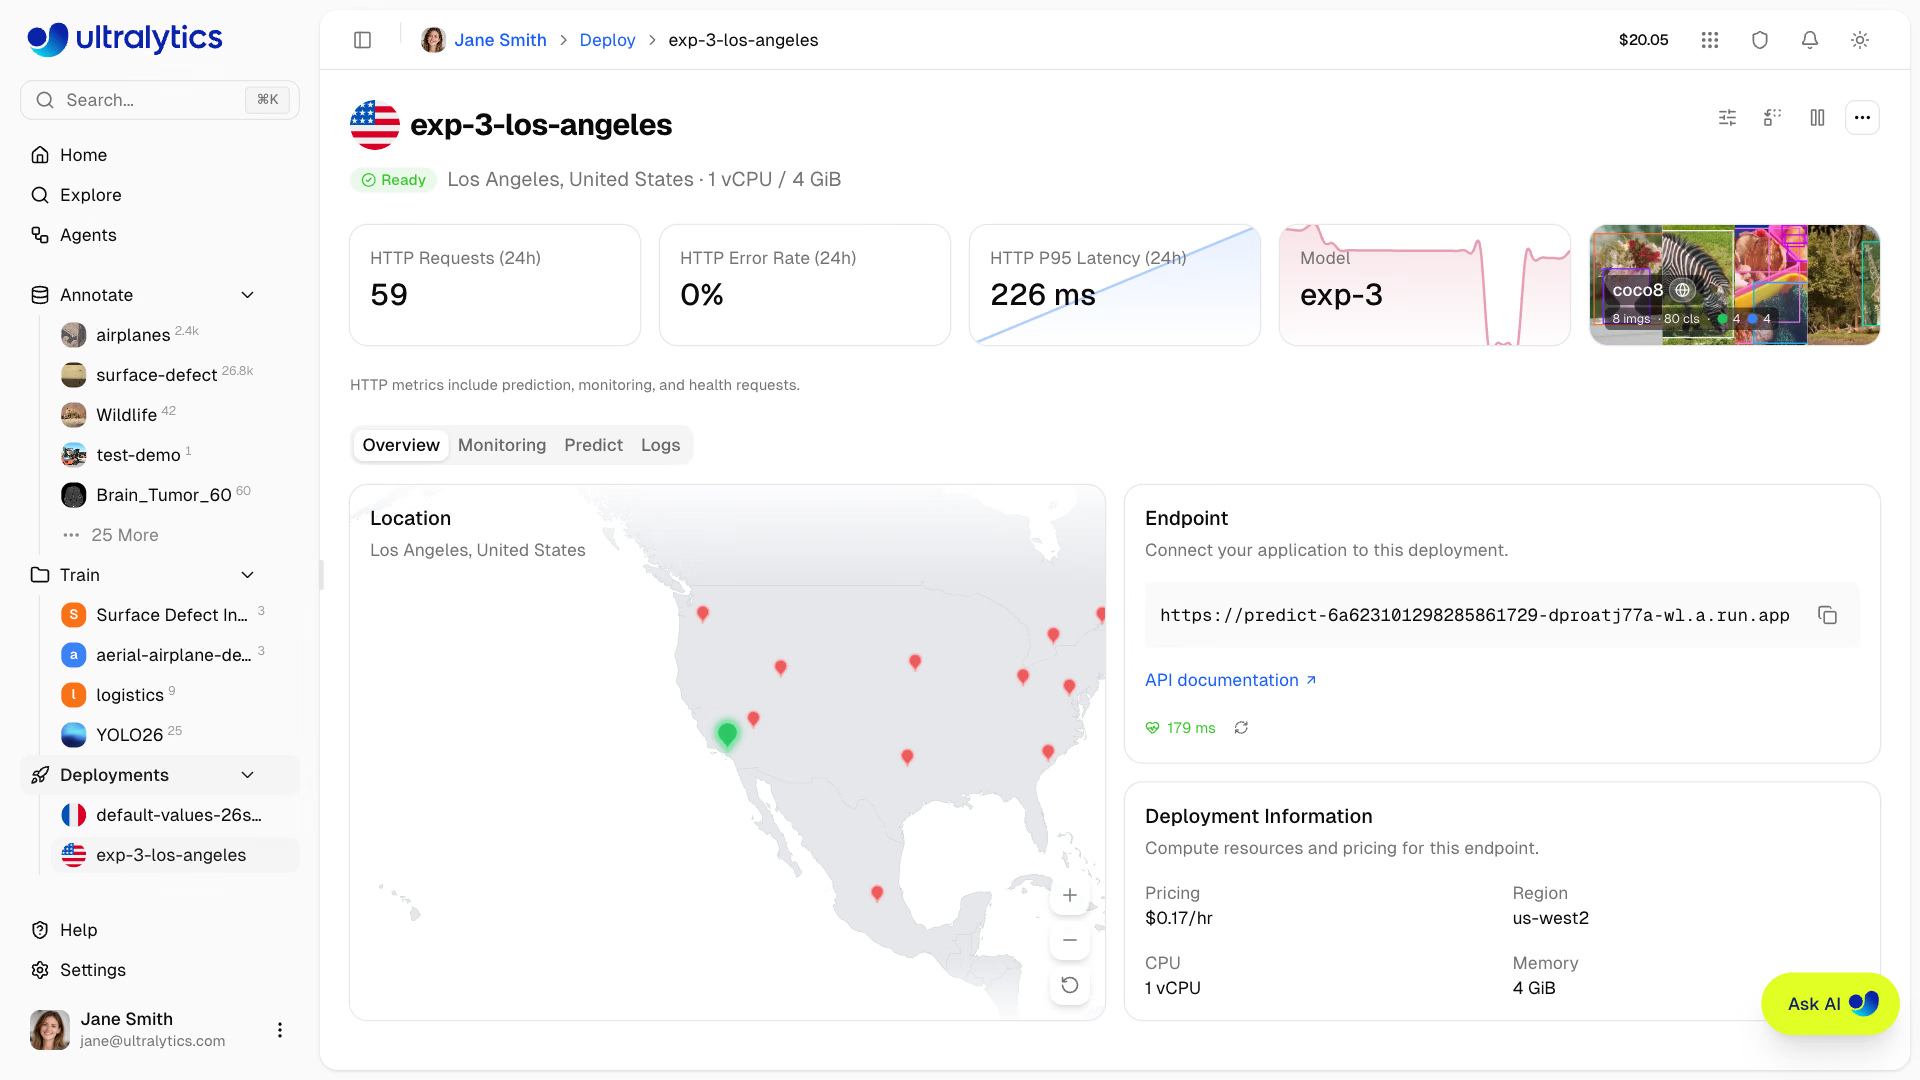
Стоимость — это время работы экземпляра, делённое на объём полезной работы. На карточке, как эта, указаны два нужных тебе числа: стоимость часа ($0,17 за 1 vCPU и 4 GiB в этом примере) и объём выполненной работы (59 запросов за 24 часа при P95 226 мс — конечная точка в основном простаивает). Затем:
- Повышай загрузку. GPU с загрузкой 30% впустую расходует 70% средств, потраченных на его работу. Объединяй потоки в пакеты (см. предыдущие уроки) или используй Triton Inference Server.
- Подбери ресурсы нужного размера. Прежде чем считать, что тебе нужен мощный GPU, проведи бенчмарки на менее мощном GPU или на CPU с OpenVINO.
- Используй ресурсы по модели spot или с возможностью прерывания для пакетных задач. Повторную обработку архивного видео можно прервать; прямые трансляции — нельзя.
Подводные камни#
Симптом: две недели настройки сэкономили 10 мс, а система всё ещё работает медленно. Решение: сначала профилируй весь конвейер и оптимизируй самый медленный этап, каким бы он ни был.
Симптом: if i % 2: continue внутри цикла обработки результатов ничего не экономит. Решение: модель уже обработала этот кадр; пропускай кадры в источнике с помощью vid_stride.
Симптом: пропускная способность выросла, но каждый кадр теперь приходит позже. Решение: большие пакеты повышают пропускную способность в расчёте на доллар, а не снижают задержку каждого кадра; используй их для обработки множества потоков или офлайн-задач, но не для одной камеры реального времени.
Когда возможности оптимизации модели исчерпаны, следующий шаг — улучшить данные. Датасет, соответствующий рабочей среде, позволяет меньшей модели достичь точности, для которой потребовалась бы более крупная модель: это снижает затраты без потери точности.
Показать решение
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on macOS and Windows
    data, img = "coco8.yaml", "https://ultralytics.com/images/bus.jpg"  # use your val YAML and a production frame
    for weights, imgsz in (("yolo26s.pt", 640), ("yolo26n.pt", 640), ("yolo26n.pt", 480)):
        model = YOLO(weights)
        runs = [model(img, imgsz=imgsz, verbose=False)[0].speed["inference"] for _ in range(20)][5:]
        m = model.val(data=data, imgsz=imgsz, batch=1, plots=False, verbose=False).box.map
        print(f"{weights} imgsz={imgsz}: {sorted(runs)[len(runs) // 2]:.1f} ms, mAP50-95 {m:.3f}")
В каждой строке первые пять запусков отбрасываются как прогревочные, а для остальных указывается медиана. Выбери первую строку, которая укладывается в бюджет задержки, а потеря mAP — в твой бюджет. Пример бюджета: «два дня, не более 1 пункта mAP, 20 FPS на сервере в магазине». Если yolo26s при разрешении 640 не укладывается в 50 мс на кадр, а yolo26n при разрешении 640 укладывается в этот лимит с потерей не более 1 пункта на проверочном наборе, остановись на этом варианте; не трать второй день на разрешение 480.